
配置Kafka JSON Catalog后,您可以在实时计算Flink版作业开发中直接访问Kafka集群中格式为JSON的Topic,无需再定义Schema。本文为您介绍如何创建、查看及删除Kafka JSON Catalog。
背景信息
Kafka JSON Catalog通过自动解析JSON格式的消息来推导Topic的Schema,您无需在Flink SQL中声明Kafka表的Schema便可以获取消息的具体字段信息。Kafka JSON Catalog具有以下功能特点:
Kafka JSON Catalog的表名对应Kafka Topic名,无需再通过DDL语句手动注册Kafka表,提升开发效率和正确性。
Kafka JSON Catalog提供的表可以直接作为Flink SQL作业中的源表使用。
Kafka JSON Catalog可以配合Flink CDC数据摄入完成Schema变更的数据同步,详情可见复用已有Catalog。
本文将从以下方面为您介绍如何管理Kafka JSON Catalog:
使用限制
Kafka JSON Catalog仅支持消息格式为JSON的Topic,暂不支持其他格式。
仅Flink计算引擎VVR 6.0.2及以上版本支持配置Kafka JSON Catalog。
不支持通过DDL语句修改已有的Kafka JSON Catalog。
仅支持查询数据表,不支持创建、修改和删除数据库和表。
Kafka JSON Catalog不支持读取或写入开启了SSL或SASL认证的Kafka。
Kafka JSON Catalog提供的表可以直接作为Flink SQL作业中的源表,不支持作为结果表和Lookup维表。
由于云消息队列 Kafka 版暂不支持采用开源版Kafka相同的接口删除Group,创建Kafka JSON Catalog时需要指定aliyun.kafka.instanceId、aliyun.kafka.accessKeyId、aliyun.kafka.accessKeySecret、aliyun.kafka.endpoint和aliyun.kafka.regionId才能自动删除Group ID,详情请参见开源对比。
注意事项
Kafka JSON Catalog通过取样数据解析生成表的Schema,对于数据格式不一致的Topic,默认保留全部列返回最宽的Schema。如果Topic的数据格式出现变化,Kafka JSON Catalog在不同时间得到的表的Schema会出现不一致。当在作业重启前后推断的Schema不同时,可能出现作业运行问题。
例如,Flink SQL作业中引用了Kafka JSON Catalog中的一张表,运行一段时间后从Savepoint重启,可能会重新获取到与上一次运行不一样的Schema。SQL作业的执行计划会用之前的Schema生成的版本,从而导致下游比如过滤条件、字段取值不匹配。因此建议在Flink SQL 作业中使用Create Temporary Table的方式建立Kakfka表,通过固定的Schema使用。
创建Kafka JSON Catalog
在数据查询文本编辑区域,输入以下配置Kafka JSON Catalog的命令。
自建Kafka集群或EMR Kafka集群
CREATE CATALOG <YourCatalogName> WITH( 'type'='kafka', 'properties.bootstrap.servers'='<brokers>', 'format'='json', 'default-database'='<dbName>', 'key.fields-prefix'='<keyPrefix>', 'value.fields-prefix'='<valuePrefix>', 'timestamp-format.standard'='<timestampFormat>', 'infer-schema.flatten-nested-columns.enable'='<flattenNestedColumns>', 'infer-schema.primitive-as-string'='<primitiveAsString>', 'infer-schema.parse-key-error.field-name'='<parseKeyErrorFieldName>', 'infer-schema.compacted-topic-as-upsert-table'='true', 'max.fetch.records'='100' );CREATE CATALOG <YourCatalogName> WITH( 'type'='kafka', 'properties.bootstrap.servers'='<brokers>', 'format'='json', 'default-database'='<dbName>', 'key.fields-prefix'='<keyPrefix>', 'value.fields-prefix'='<valuePrefix>', 'timestamp-format.standard'='<timestampFormat>', 'infer-schema.flatten-nested-columns.enable'='<flattenNestedColumns>', 'infer-schema.primitive-as-string'='<primitiveAsString>', 'infer-schema.parse-key-error.field-name'='<parseKeyErrorFieldName>', 'infer-schema.compacted-topic-as-upsert-table'='true', 'max.fetch.records'='100', 'aliyun.kafka.accessKeyId'='<aliyunAccessKeyId>', 'aliyun.kafka.accessKeySecret'='<aliyunAccessKeySecret>', 'aliyun.kafka.instanceId'='<aliyunKafkaInstanceId>', 'aliyun.kafka.endpoint'='<aliyunKafkaEndpoint>', 'aliyun.kafka.regionId'='<aliyunKafkaRegionId>' );
参数
类型
说明
是否必填
备注
YourCatalogName
String
Kafka JSON Catalog名称。
是
请填写为自定义的英文名。
重要参数替换为您的Catalog名称后,需要去掉尖括号(<>),否则语法检查会报错。
type
String
Catalog类型。
是
固定值为kafka。
properties.bootstrap.servers
String
Kafka Broker地址。
是
格式为
host1:port1,host2:port2,host3:port3。以英文逗号(,)分割。
format
String
Kafka消息格式。
是
目前只支持配置为JSON。Flink会解析JSON格式的Kafka消息,来获取Schema。
default-database
String
Kafka集群名称。
否
默认值为kafka。Catalog要求三层结构定位一张表,即catalog_name.db_name.table_name。此处是配置默认的db_name,由于Kafka没有Database的概念,您可以在此处使用任意字符串指代Kafka集群作为database的定义。
key.fields-prefix
String
自定义添加到消息键(Key)解析出字段名称的前缀,来避免Kafka消息键解析后的命名冲突问题。
否
默认值为key_。例如,如果您的key字段名为a,则系统默认解析key后的字段名称为key_a。
说明key.fields-prefix的配置值不可以是value.fields-prefix的配置值的前缀。例如value.fields-prefix配置为test1_value_,则key.fields-prefix不可以配置为test1_。
value.fields-prefix
String
自定义添加到消息体(Value)解析出字段名称的前缀,来避免Kafka消息体解析后的命名冲突问题。
否
默认值为value_。例如,如果您的value字段名为b,则系统默认解析value后的字段名称为value_b。
说明value.fields-prefix的配置值不可以是key.fields-prefix的配置值的前缀。例如key.fields-prefix配置为test2_value_,则value.fields-prefix不可以配置为test2_。
timestamp-format.standard
String
解析JSON格式消息中Timestamp类型字段的格式,首先尝试通过您配置的格式去解析,解析失败后再自动尝试使用其他格式解析。
否
可配置的值有以下两种:
SQL(默认值)
ISO-8601
infer-schema.flatten-nested-columns.enable
Boolean
解析JSON格式消息体(Value)时,是否递归式地展开JSON中的嵌套列。
否
参数取值如下:
true:递归式展开。
对于被展开的列,Flink使用索引该值的路径作为名字。例如,对于
{"nested": {"col": true}}中的列col,它展开后的名字为nested.col。说明设置为true时,建议和Flink CDC数据摄入作业配合使用,目前暂不支持其它DML语句自动展开嵌套列。
false(默认值):将嵌套类型当作String处理。
infer-schema.primitive-as-string
Boolean
解析JSON格式消息体(Value)时,是否推导所有基本类型为String类型。
否
参数取值如下:
true:推导所有基本类型为String。
false(默认值):按照基本规则进行推导。
infer-schema.parse-key-error.field-name
String
解析JSON格式消息键(Key)时,如果消息键不为空,且解析失败,会添加key.fields-prefix前缀拼接此配置项的值为列名,类型为VARBINARY的字段到表Schema,表示消息键部分的数据。
否
默认值为col。如:消息体解析出的字段为value_name,消息键不为空但解析失败,则默认返回的Schema包含两个字段:key_col,value_name。
infer-schema.compacted-topic-as-upsert-table
Boolean
当Kafka topic的日志清理策略为compact且消息键(Key)不为空时,是否作为Upsert Kafka表使用。
否
默认值为true。使用Flink CDC数据摄入同步数据到阿里云消息队列Kafka版时需要配置为true。
说明仅实时计算引擎VVR 6.0.2及以上版本支持该参数。
max.fetch.records
Int
解析JSON格式消息时,最多尝试消费的消息数量。
否
默认值为100。
aliyun.kafka.accessKeyId
String
阿里云账号AccessKey ID,详情请参见创建AccessKey。
否
使用Flink CDC数据摄入同步数据到阿里云消息队列Kafka版时需要配置。
说明仅实时计算引擎VVR 6.0.2及以上版本支持该参数。
aliyun.kafka.accessKeySecret
String
阿里云账号AccessKey Secret,详情请参见创建AccessKey。
否
使用Flink CDC数据摄入同步数据到阿里云消息队列Kafka版时需要配置。
说明仅实时计算引擎VVR 6.0.2及以上版本支持该参数。
aliyun.kafka.instanceId
String
阿里云Kafka消息队列实例ID,可在消息队列Kafka实例详情界面查看。
否
使用Flink CDC数据摄入同步数据到阿里云消息队列Kafka版时需要配置。
说明仅实时计算引擎VVR 6.0.2及以上版本支持该参数。
aliyun.kafka.endpoint
String
阿里云Kafka API服务接入地址,详情请参见服务接入点。
否
使用Flink CDC数据摄入同步数据到阿里云消息队列Kafka版时需要配置。
说明仅实时计算引擎VVR 6.0.2及以上版本支持该参数。
aliyun.kafka.regionId
String
Topic所在实例的地域ID,详情请参见服务接入点。
否
使用Flink CDC数据摄入同步数据到阿里云消息队列Kafka版时需要配置。
说明仅实时计算引擎VVR 6.0.2及以上版本支持该参数。
选中创建Catalog的代码后,单击左侧代码行数上的运行。
CREATE CATALOG KafkaCatalog WITH( 'type'='kafka', 'properties.bootstrap.servers'='<brokers>', 'format'='json', 'default-database'='<dbName>', 'key.fields-prefix'='<keyPrefix>', 'value.fields-prefix'='<valuePrefix>', 'timestamp-format.standard'='<timestampFormat>', 'infer-schema.flatten-nested-columns.enable'='<flattenNestedColumns>', 'infer-schema.primitive-as-string'='<primitiveAsString>', 'infer-schema.parse-key-error.field-name'='<parseKeyErrorFieldName>', 'infer-schema.compacted-topic-as-upsert-table'='true', 'max.fetch.records'='100', 'aliyun.kafka.accessKeyId'='<aliyunAccessKeyId>', 'aliyun.kafka.accessKeySecret'='<aliyunAccessKeySecret>', 'aliyun.kafka.instanceId'='<aliyunKafkaInstanceId>', 'aliyun.kafka.endpoint'='<aliyunKafkaEndpoint>', 'aliyun.kafka.regionId'='<aliyunKafkaRegionId>' );在左侧元数据区域,查看创建的Catalog。
查看Kafka JSON Catalog
在数据查询文本编辑区域,输入以下命令。
DESCRIBE `${catalog_name}`.`${db_name}`.`${topic_name}`;参数
说明
${catalog_name}
Kafka JSON Catalog名称。
${db_name}
Kafka集群名称。
${topic_name}
Kafka Topic名称。
选中查看Catalog的代码后,单击左侧代码行数上的运行。
运行成功后,可以在运行结果中查看表的具体信息。执行后返回Kafka源表的字段定义,包含业务字段
value_from(STRING)、value_name(STRING)、value_order(BIGINT),以及元数据虚拟字段partition(INT,主键)、offset(BIGINT,主键)、timestamp(TIMESTAMP_LTZ(3)),其中元数据字段的extras列均为METADATA VIRTUAL。
使用Kafka JSON Catalog
作为源表,从Kafka Topic中读取数据。
INSERT INTO ${other_sink_table} SELECT... FROM `${kafka_catalog}`.`${db_name}`.`${topic_name}`/*+OPTIONS('scan.startup.mode'='earliest-offset')*/;说明如果Kafka JSON Catalog的表使用时需要指定其他WITH参数,则建议使用SQL Hints的方式来添加其他参数。例如,如上SQL使用了SQL Hints指定从最早的数据开始消费。其他参数详情请参见消息队列Kafka源表和消息队列Kafka结果表。
作为源表,使用Flink CDC数据摄入将Kafka Topic中的数据同步至paimon目标表中,通过
using.built-in-catalog复用参数可简化配置。单表同步,实时同步数据。
source:
  type: kafka
  using.built-in-catalog: kafka_json_catalog
  topic: topic0
  properties.group.id: cdc_kafka_json_to_paimon
  # 首次启动从各 Topic 最早的可用消息开始消费
  scan.startup.mode: earliest-offset
  value.format: json

sink:
  type: paimon
  using.built-in-catalog: paimon_dlf_catalog

# 指定topic0写入的paimon表
route:
  - source-table: topic0
    sink-table: db.table0
在一个作业中同步多张表。
source:
  type: kafka
  using.built-in-catalog: kafka_json_catalog
  topic: "topic0;topic1;topic2"
  properties.group.id: cdc_kafka_json_to_paimon
  # 首次启动从各 Topic 最早的可用消息开始消费
  scan.startup.mode: earliest-offset
  value.format: json
  # 批量发送启动时已知的建表事件
  scan.emit.create-table-events.in-batch.enabled: true

sink:
  type: paimon
  using.built-in-catalog: paimon_dlf_catalog

# 每个topic分别写入不同的表
route:
  - source-table: topic0
    sink-table: db.table0
  - source-table: topic1
    sink-table: db.table1
  - source-table: topic2
    sink-table: db.table2
完整的端到端的Kafka JSON Catalog使用示例详情请参见日志实时入仓和使用Flink读取kafka Catalog源表数据后写入下游Hologres表。
删除Kafka JSON Catalog
删除Kafka JSON Catalog不会影响已运行的作业,但会导致使用该Catalog下表的作业,在上线或重启时报无法找到该表的错误,请您谨慎操作。
在数据查询文本编辑区域,输入以下命令。
DROP CATALOG ${catalog_name};其中${catalog_name}为您要删除的目标Kafka JSON Catalog名称。
选中删除Catalog的命令,鼠标右键选择运行。
在左侧元数据区域,查看目标Catalog是否已删除。
从Kafka JSON Catalog获取的表信息详解
为了方便使用Kafka JSON Catalog获取的表,Kafka JSON Catalog会在推导的表上添加默认的配置参数、元数据和主键信息。Kafka JSON Catalog获取的表的详细信息如下:
Kafka表的Schema推导
Kafka JSON Catalog在解析JSON格式消息获取Topic的Schema时,Catalog会尝试消费最多max.fetch.records条消息,解析每条数据的Schema,解析规则与Kafka作为Flink CDC数据摄入数据源时的基本规则相同,再将这些Schema合并作为最终的Schema。
重要Kafka JSON Catalog在推导Schema时,会建立消费组消费该Topic的数据,消费组名称使用前缀表明是Catalog创建的。
对于阿里云消息队列Kafka版,建议在6.0.7及以上的版本使用Kafka JSON Catalog。6.0.7版本以前不会自动删除消费组,将导致用户收到消费组数据堆积告警。
Schema主要包含以下几个部分:
推导的物理列(Physical Columns)
Kafka JSON Catalog会从Kafka消息的消息键(Key)和消息体(Value)推导出消息的物理列,列名添加对应的前缀。
如果消息键不为空但解析失败,会返回列名为key.fields-prefix前缀和infer-schema.parse-key-error.field-name参数配置值的拼接结果,类型为VARBINARY的列。
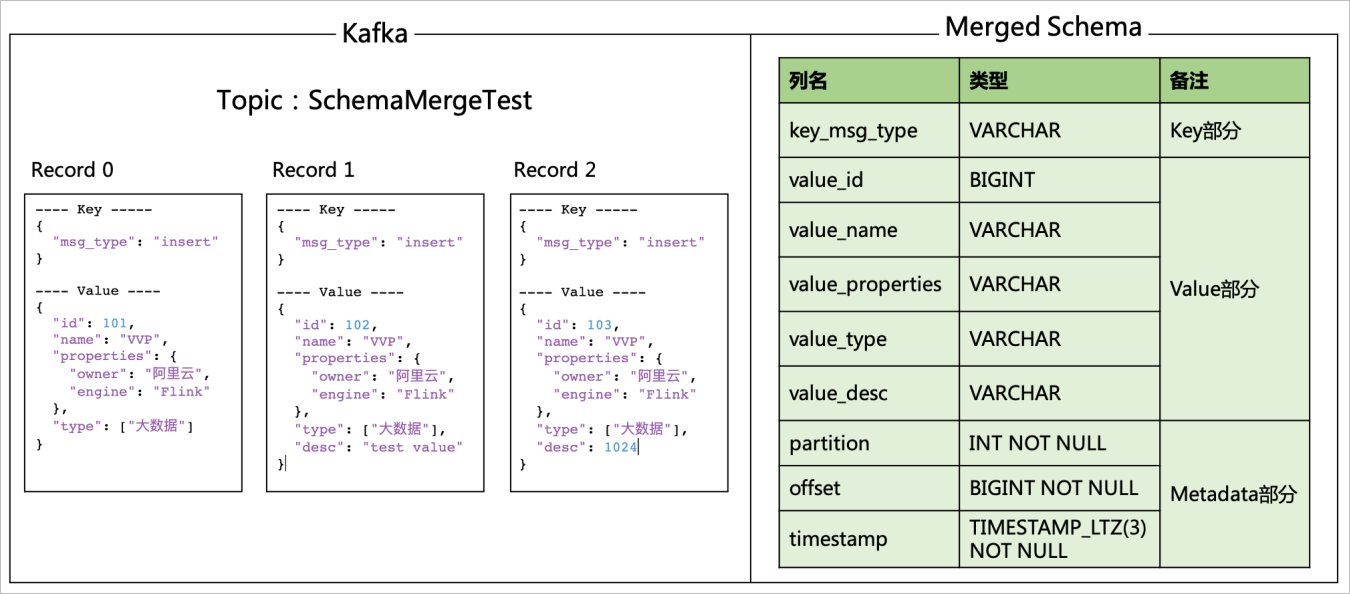
当拉取到一组Kafka消息后,Catalog会逐条解析Kafka消息并按以下规则合并解析出的物理列,从而作为整个Topic的Schema。合并规则如下:
如果解析出的物理列中包含结果Schema中没有的字段,则Kafka JSON Catalog会自动将这些字段加入到结果Schema。
如果两者出现了同名列,则按照以下场景进行处理:
当类型相同且精度不同时,会取两者中较大的精度的类型。
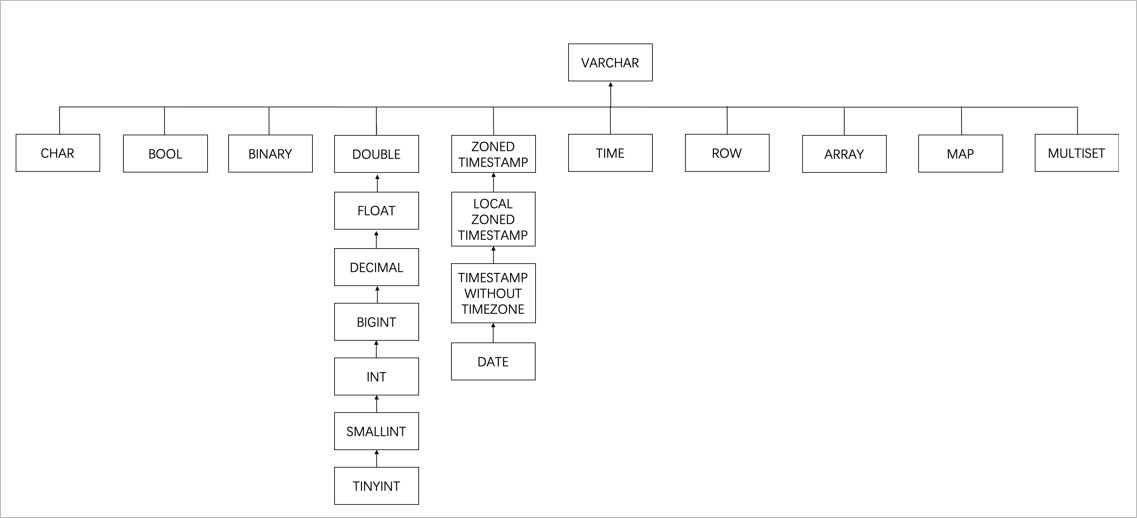
当类型不同时,会按照如下图的树型结构找到最小父节点,作为该同名列的类型。但当Decimal和Float类型合并时,为了保留精度会合并为Double类型。
例如,对于下面包含三条数据的一个Kafka topic,Kafka JSON Catalog得到的Schema如下图所示。
默认添加的元数据列(Metadata Column)
Kafka JSON Catalog会默认添加partition,offset和timestamp三个有用的元数据列。详情如下表所示。
元数据名
列名称
类型
说明
partition
partition
INT NOT NULL
分区值。
offset
offset
BIGINT NOT NULL
偏移量。
timestamp
timestamp
TIMESTAMP_LTZ(3) NOT NULL
消息时间戳。
默认添加的主键约束
从Kafka JSON Catalog获取的表,在作为源表消费时,会默认把元数据列partition和offset列作为主键,确保数据不重复。
说明如果Kafka JSON Catalog推导出来的表Schema不符合预期,您可以通过CREATE TEMPORARY TABLE ... LIKE语法声明临时表来指定期望的表Schema。比如JSON数据中存在字段ts,字段格式是'2023-01-01 12:00:01',Kafka JSON Catalog会将ts字段自动推导成TIMESTAMP类型,如果希望ts字段作为STRING类型使用,可以通过CREATE TEMPORARY TABLE ... LIKE语法声明该表进行使用。如下所示,由于默认配置中消息Value部分字段添加了value_前缀,此处字段名为value_ts。
CREATE TEMPORARY TABLE tempTable (
    value_name STRING,
    value_ts STRING
) LIKE `kafkaJsonCatalog`.`kafka`.`testTopic`;
默认添加的表参数
参数
说明
备注
connector
Connector类型。
固定值为kafka或upsert-kafka。
topic
对应的Topic名称。
声明的表名。
properties.bootstrap.servers
Kafka Broker地址。
对应Catalog的properties.bootstrap.servers参数配置值。
value.format
Flink Kafka Connector在序列化或反序列化Kafka的消息体(Value)时使用的格式。
固定值为json。
value.fields-prefix
为所有Kafka消息体(Value)指定自定义前缀,以避免与消息键(Key)或Metadata字段重名。
对应Catalog的value.fields-prefix参数配置值。
value.json.infer-schema.flatten-nested-columns.enable
Kafka消息体(Value)是否递归式地展开JSON中的嵌套列。
对应Catalog的infer-schema.flatten-nested-columns.enable参数配置值。
value.json.infer-schema.primitive-as-string
Kafka消息体(Value)是否推导所有基本类型为String类型。
对应Catalog的infer-schema.primitive-as-string参数配置值。
value.fields-include
定义消息体在处理消息键字段时的策略。
固定值为EXCEPT_KEY。表示消息体中不包含消息键的字段。
消息键(Key)不为空时配置该参数,消息键(Key)为空时不配置该参数。
key.format
Flink Kafka Connector在序列化/反序列化Kafka的消息键(Key)时使用的格式。
固定值为json或raw。
消息键(Key)不为空时配置该参数,消息键(Key)为空时不配置该参数。
当消息键(Key)不为空但解析失败时,配置为raw;解析成功时,配置为json。
key.fields-prefix
为所有Kafka消息键(Key)指定自定义前缀,以避免与消息体(Value)格式字段重名。
对应Catalog的key.fields-prefix参数配置值。
消息键(Key)不为空时配置该参数,消息键(Key)为空时不配置该参数。
key.fields
Kafka消息键(Key)解析出来的数据存放的字段。
自动填写解析出来的Key字段列表。
消息键(Key)不为空且不是Upsert Kafka表时配置该参数,否则不配置该参数。