
在相同硬件规格下,使用OpenMessaging Benchmark测试框架以及运行Flink作业,对Fluss与Kafka在日志读写吞吐、列裁剪读取、冷读回追进行性能对比。
背景
Fluss简介
Fluss是从零设计的湖流一体流存储系统,兼具高吞吐流写入和高效列式存储能力。区别于Kafka等传统消息系统仅支持行式数据传输,Fluss基于Apache Arrow列式存储格式,原生支持列裁剪和谓词下推,在流读场景下可实现数倍至数十倍的性能提升。
为什么与Kafka对比
Kafka广泛用于实时数仓的消息队列层,是缺少流存储时最常见的替代方案。本测试旨在验证以下三点:
列裁剪优势:Fluss列式存储在部分列读取场景下的收益。
冷热分离能力:Fluss分层存储在数据回追场景下的稳定性。
基础流读写能力:Fluss是否能达到与Kafka同等的吞吐和延迟水平。
测试环境
阿里云华北2(北京),可用区H。
硬件配置
配置项 | Fluss(全托管) | Kafka(自建ECS) |
集群规格 | 3台8 CU Tablet Server | 3台ecs.g9i.2xlarge |
计算资源 | 共24 CU | 共24核96 GB |
存储资源 | 3 TB云盘存储(3副本) | 3 TB云盘存储(3副本) |
软件环境
组件 | 版本 |
全托管Fluss | 0.9-ali-4.0 |
Apache Kafka | 开源4.2.0(KRaft模式) |
测试框架
测试场景 | 测试框架 | 测试内容 |
列裁剪读取、冷读回追 | Flink SQL | 不同列数读取吞吐、冷热分离读取吞吐 |
日志表读写吞吐 | 单分区/多分区阶梯速率吞吐 |
测试一:列裁剪读取
测试方法
Fluss:创建一张16列表(8 BIGINT + 8 STRING),单个Bucket,预写入1亿条数据(约100 GB)。Flink任务1个并发读取。
Kafka:创建一个主题,单个Partition,预写入1亿条数据(约100 GB)。Flink任务1个并发读取。
分别测试读取不同列数下的吞吐表现。
测试结果
读取列数 | Fluss读取数据量(GB) | Fluss(条/秒) | Kafka读取数据量(GB) | Kafka(条/秒) | Fluss倍数 |
16(全列) | 103.66 | 47.6K | 121.17 | 41.6K | ~1x |
8 | 52.99 | 121.8K | 121.17 | 44.4K | ~2.6x |
4 | 27.66 | 386.1K | 121.17 | 42.8K | ~8.1x |
2 | 14.99 | 465.1K | 121.17 | 37K | ~9.8x |
1(BIGINT) | 3.07 | 3.03M | 121.17 | 33.3K | ~63.7x |
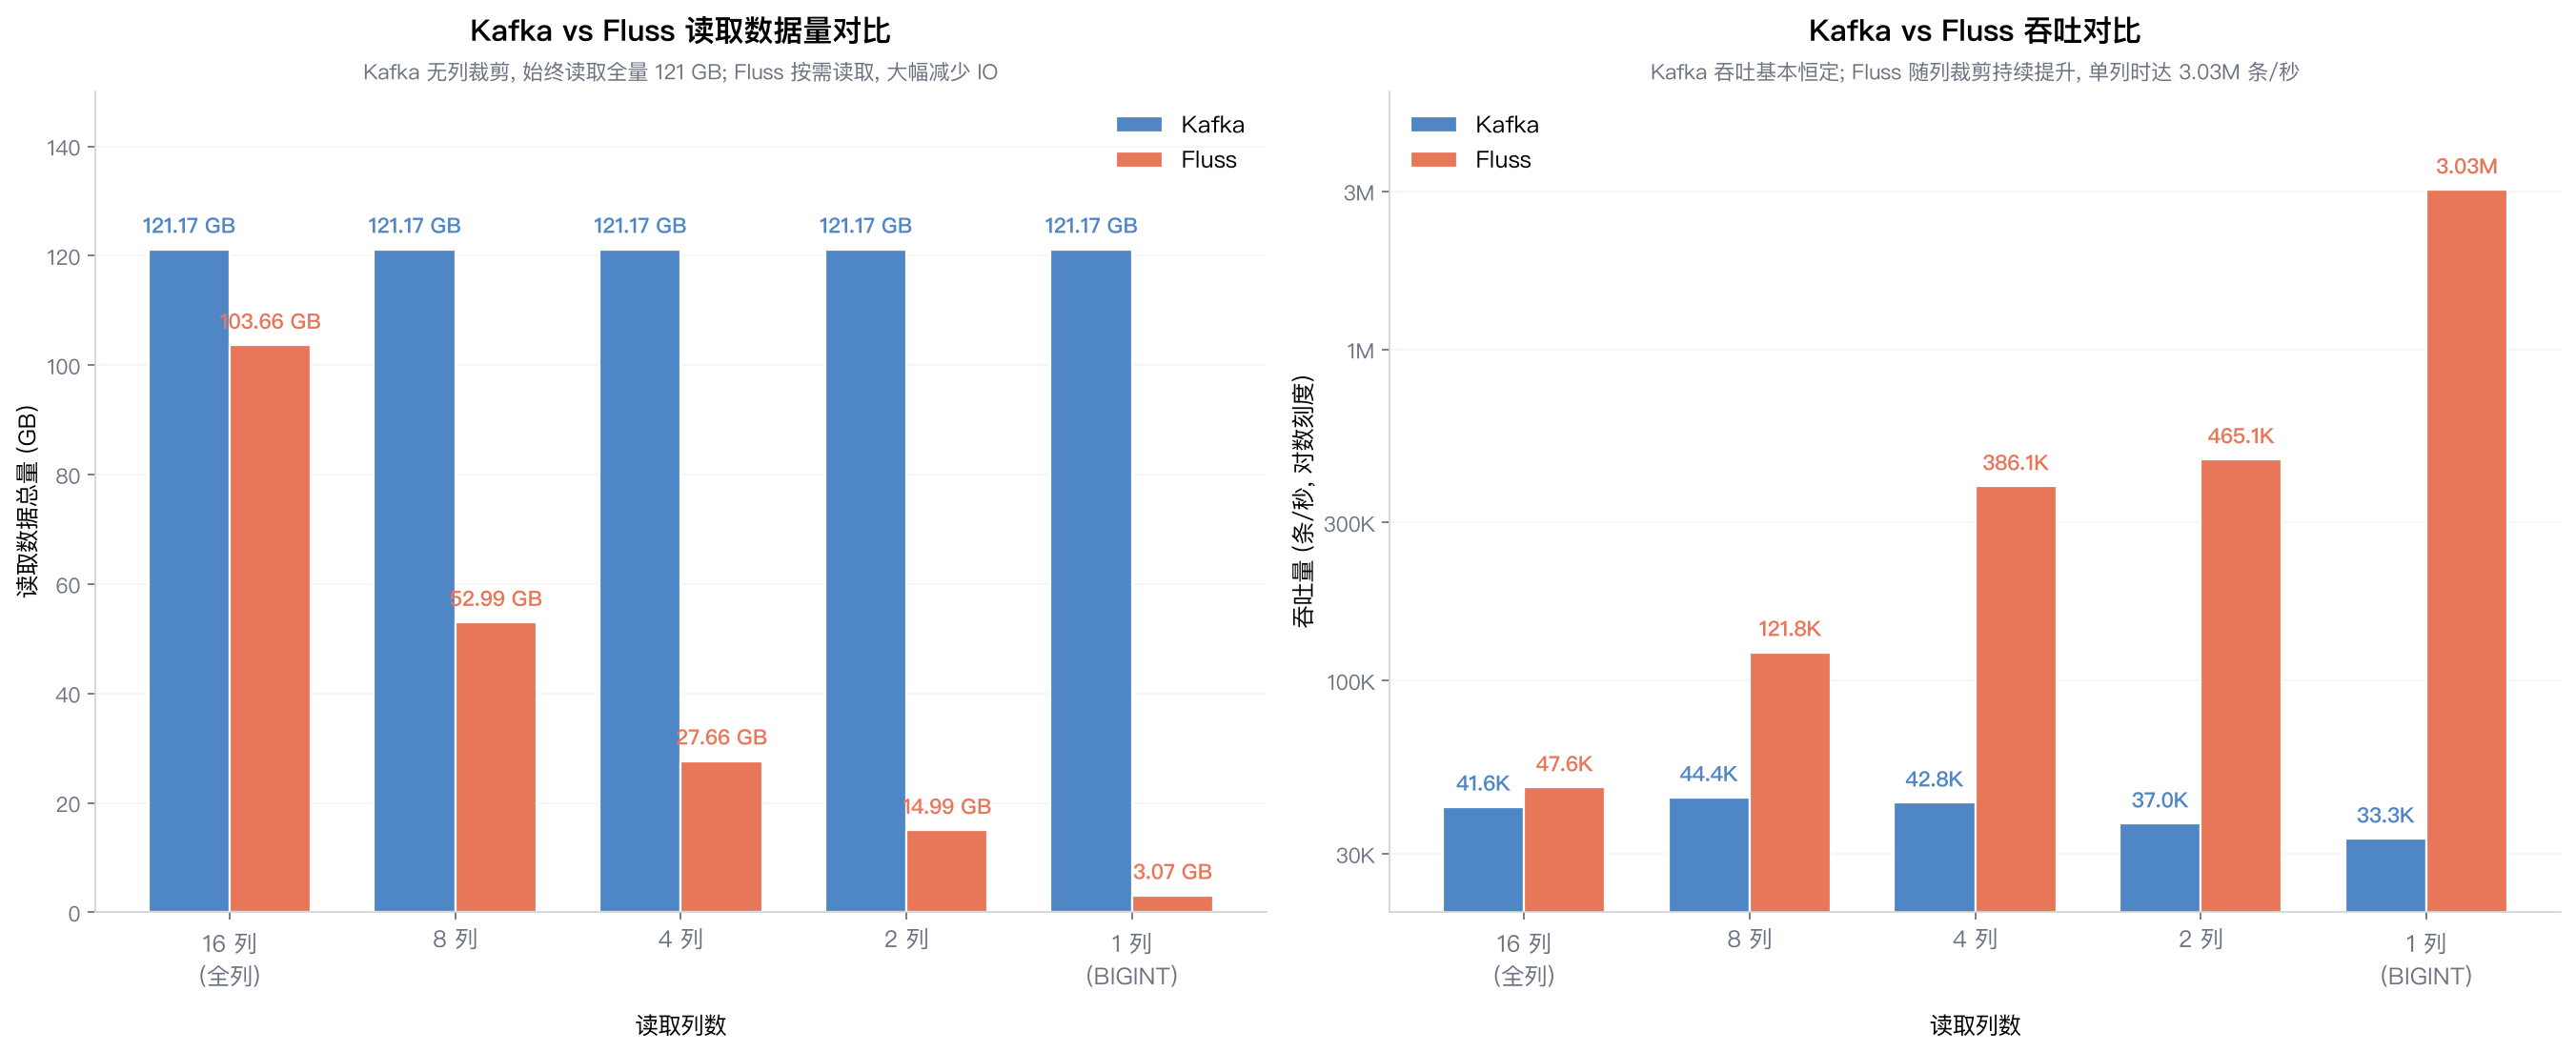
Kafka无列裁剪功能,无论读取多少列均需传输整行数据(121.17 GB)并在客户端完成反序列化,因此吞吐不随读取列数变化。
结论
列裁剪场景下,Fluss读取STRING列可比Kafka快10倍以上,BIGINT列可达63.7倍。读取性能随裁剪比例倍数提升,同时大幅降低网络传输成本。
原因分析:
Fluss基于Apache Arrow列式存储格式,支持在存储层只读取需要的列。
Kafka为行式存储,无论读取几列都需传输整行数据。
测试二:冷读(数据回追)
测试方法
Fluss:创建一张表,单个Bucket,预写入100 GB数据。本地仅保留2个Log Segment,绝大部分数据已同步到远程OSS存储。Flink任务1个并发读取。
Kafka:创建一个主题,单个Partition,预写入100 GB数据,全量本地存储。Flink任务1个并发读取。
分别测试有无写入负载对冷读性能的影响。
测试结果
场景 | Fluss(条/秒) | Kafka(条/秒) | 对比 |
冷读(无写入) | 平稳255K | 平稳33.3K | Fluss快8.6x |
冷读(有写入) | 平稳288K | 平稳23.6K | Fluss快12.3x |
性能衰减 | 影响极小 | 下降29.1% | - |
结论
Fluss冷读直读OSS,冷热数据物理分离,冷读不干扰热数据读写。
Kafka冷读受写入负载影响显著,吞吐下降29.1%。
Fluss更适合数仓回追场景,提供更快且更稳定的回追能力。
测试三:日志表读写吞吐
测试方法
使用OpenMessaging Benchmark(OMB)框架,消息大小1 KB,通过阶梯速率测试两组配置:
T1(单分片):1个分片,4生产并发,1消费并发。阶梯速率200/250/300/350/400/450/500 K msg/s。
T2(100分片):100个分片,4生产并发,4消费并发。阶梯速率200/250/300/350/400 K msg/s。
T1测试结果:单分片
单位:K msg/s
目标吞吐 | Fluss写入 | Fluss读取 | Kafka写入 | Kafka读取 |
200 | 199.90 | 200.03 | 200.10 | 200.10 |
250 | 250.05 | 250.10 | 250.12 | 250.12 |
300 | 299.96 | 300.03 | 300.16 | 300.16 |
350 | 350.19 | 350.17 | 350.17 | 350.17 |
400 | 400.05 | 400.05 | 400.20 | 400.20 |
450 | 449.95 | 450.14 | 450.24 | 450.24 |
500 | 499.89 | 500.07 | 500.32 | 500.31 |
T2测试结果:100分片
单位:K msg/s
目标吞吐 | Fluss写入 | Fluss读取 | Kafka写入 | Kafka读取 |
200 | 200.05 | 200.00 | 200.10 | 200.10 |
250 | 250.07 | 250.11 | 250.10 | 250.10 |
300 | 300.14 | 300.12 | 300.16 | 300.16 |
350 | 350.03 | 350.01 | 350.18 | 350.18 |
400 | 400.03 | 400.02 | 400.18 | 400.18 |
结论
在基础日志读写场景下,Fluss与Kafka均能稳定达到目标吞吐水平,基础流处理能力相当。
总结
测试场景 | Fluss vs Kafka |
列裁剪流读 | Fluss快10~63.7倍,列式存储原生优势 |
冷读稳定性 | Fluss更优,冷热分离无性能干扰;Kafka下降29.1% |
日志表读写吞吐 | 持平,基础流处理能力相当 |
核心优势:
列裁剪10x~63x加速:列式存储带来数量级提升,同时降低网络传输成本。
冷热分离更稳定:冷数据直读对象存储,不干扰热数据链路。
基础能力持平:纯流读写场景下与Kafka性能相当,可无缝替代。
本文测试数据基于特定硬件环境和软件版本,实际性能可能因部署环境、数据特征、访问模式等因素有所差异,测试结果仅供参考。
附件
各测试场景的详细复现步骤、配置参数和完整 SQL 语句,参见以下附件:
《Fluss列裁剪与冷读测试复现指南.pdf》——Flink SQL 测试步骤、数据准备与对照组配置。
《Fluss日志表读写吞吐测试复现指南.pdf》——OMB 框架搭建、负载配置与 Kafka 集群部署。