
录音文件识别是针对已经录制完成的录音文件,进行离线识别的服务。录音文件识别是非实时的,识别的文件需要提交基于HTTP可访问的URL地址,不支持提交本地文件。
计费和并发限制
使用限制
请在编码时严格遵循以下要求,否则可能导致识别失败(识别结果为空)。
支持单轨和双轨的WAV、MP3、MP4、M4A、WMA、AAC、OGG、AMR、FLAC格式录音文件识别。
音频文件大小不超过512 MB,视频文件大小不超过2 GB,文件总时长不超过12小时。
需要识别的录音文件必须存放在某服务上,可以通过URL访问。
上传的录音文件URL的访问权限需要设置为公开,URL中只能使用域名不能使用IP地址、不可包含空格,请尽量避免使用中文。
可用URL
不可用URL
https://gw.alipayobjects.com/os/bmw-prod/0574ee2e-f494-45a5-820f-63aee583045a.wav
http://127.0.0.1/sample.wav
D:\files\sample.wav
录音文件识别属于离线识别服务,对于并发数没有限制,对于QPS(Queries Per Second)的限制如下:
POST方式的录音文件识别请求调用接口,用户级别QPS限制为200。
GET方式的录音文件识别请求调用接口,用户级别QPS限制为500。
录音文件识别结果查询接口,同一Taskid QPS限制为1。
新用户试用期3个月内,每隔24小时可免费识别2小时时长的文件转写服务。免费额度用完后,间隔24小时后可继续试用。
提交录音文件识别请求后,免费用户的识别任务在24小时内完成并返回识别文本。 付费用户的识别任务在3小时内完成并返回识别文本。识别结果在服务端可保存72小时。
重要一次性上传大规模数据(半小时内上传超过500小时时长的录音)的除外。有大规模数据识别需求的用户,请联系售前专家。
支持调用方式:轮询方式和回调方式。
支持语言模型定制。更多信息请参见语言模型定制。
支持热词。更多信息请参见热词。
支持汉语普通话、方言、欧美英语等多种模型识别。语种和方言模型无法在编码时指定,需要在智能语音交互控制台的全部项目中对相关项目执行项目功能配置操作,选择对应的模型。详情请参见管理项目。
目前支持的语种和方言模型如下:
使用步骤
了解您的录音文件格式和采样率,根据业务场景在管控台选择合适的场景模型。
上传录音文件至OSS。
如果OSS中文件访问权限为公开,可参见公共读Object,获取文件访问链接;如果OSS中文件访问权限为私有,可参见私有Object,通过SDK生成有有效时间的访问链接。
重要您也可以把录音文件存放在自行搭建的文件服务器,提供文件下载。请保证HTTP的响应头(Header)中
Content-Length的长度值和Body中数据的真实长度一致,否则会导致下载失败。客户端提交录音文件识别请求。
正常情况下,服务端返回该请求任务的ID,用以查询识别结果。
客户端发送识别结果查询请求。
通过步骤3获取的请求任务ID查询录音文件识别的结果,目前识别的结果在服务端可保存72小时。
交互流程
客户端与服务端的交互流程如图所示。
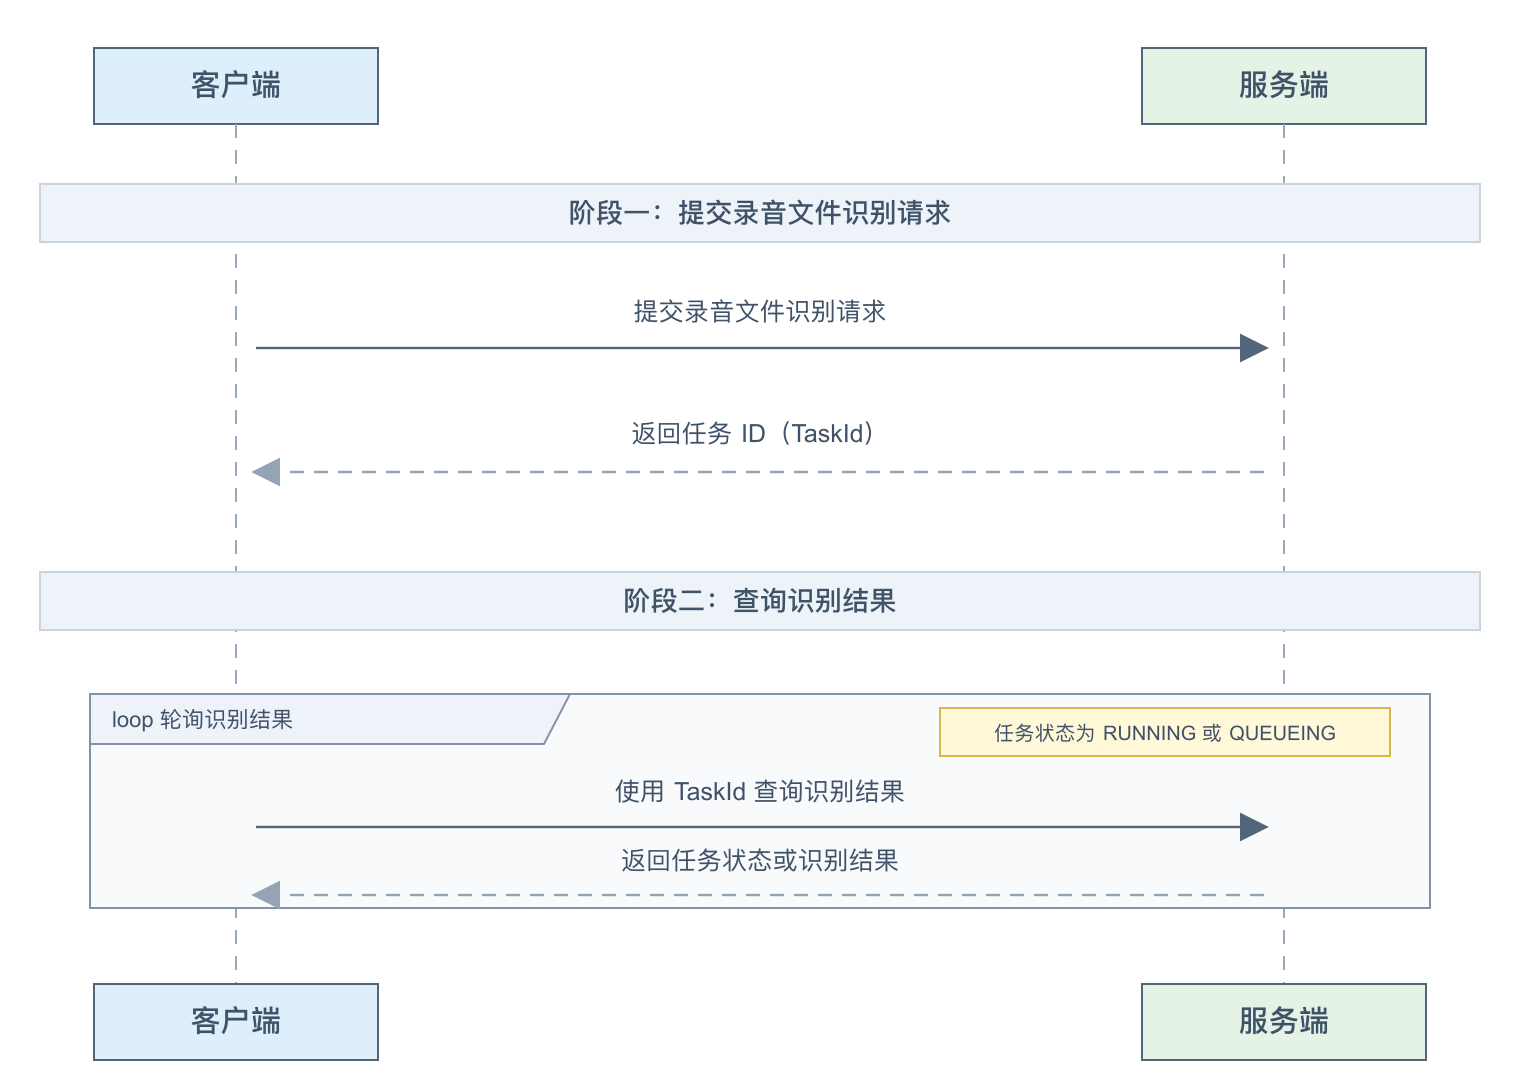
所有服务端的响应都会在返回信息的header包含表示本次识别任务的TaskId参数。
各地域POP调用参数
地域 | 调用参数 |
华东2(上海) |
|
华北2(北京) |
|
华南1(深圳) |
|
接口调用方式
录音文件识别服务是以RPC风格的POP API方式提供录音文件识别接口,将参数封装到每一个请求中,每个请求即对应一个方法,执行的结果放在response中。需要识别的录音文件必须存放在某服务上(推荐阿里云OSS),可以通过URL访问。使用阿里云OSS,同一地域可以通过内网访问,不计外网流量费用,具体方法请参见使用录音文件识别时如何设置OSS内网地址。
录音文件识别POP API包括两部分:POST方式的“录音文件识别请求调用接口”(用户级别QPS(queries per second)限制为200)、GET方式的“录音文件识别结果查询接口”(用户级别QPS限制为500)。
识别请求调用接口:
当采用轮询方式时,提交录音文件识别任务,获取任务ID,供后续轮询使用。
当采用回调方式时,提交录音文件识别任务和回调URL,任务完成后会把识别结果POST到回调地址,要求回调地址可接收POST请求。
说明由于历史原因,早期发布的录音文件识别服务(默认为2.0版本)的回调方式和轮询方式的识别结果在JSON字符串的风格和字段上均有不同,下文将作说明。录音文件识别服务在4.0版本对回调方式做了优化,使得回调方式的识别结果与轮询方式的识别结果保持一致,均为驼峰风格的JSON格式字符串。
如果您已接入录音文件识别服务,即没有设置录音文件识别服务的版本,默认为2.0版,可以继续使用;如果您新接入录音文件识别服务,请设置服务版本为4.0。
输入参数及说明:
提交录音文件识别请求时,需要设置输入参数,以JSON格式的字符串传入请求对象的Body,JSON格式如下:
{
    "appkey": "your-appkey",
    "file_link": "https://gw.alipayobjects.com/os/bmw-prod/0574ee2e-f494-45a5-820f-63aee583045a.wav",
    "auto_split":false,
    "version": "4.0",
    "enable_words": false,
    "enable_sample_rate_adaptive": true,
    // valid_times:获取语音指定时间段的识别内容,若不需要,则无需填写。
    "valid_times": [
        {
            "begin_time": 200,
            "end_time":2000,
            "channel_id": 0
        }
    ]
}
参数
值类型
是否必选
说明
appkey
String
是
管控台创建的项目Appkey。
file_link
String
是
存放录音文件的地址,需要在管控台中将对应项目的模型设置为支持该音频场景的模型。
version
String
否
设置录音文件识别服务的版本,默认为4.0。
enable_words
Boolean
否
是否开启返回词信息,默认为false,开启时需要设置version为4.0。
enable_sample_rate_adaptive
Boolean
否
大于16 kHz采样率的音频是否进行自动降采样(降为16 kHz),默认为false,开启时需要设置version为4.0。
enable_callback
Boolean
否
是否启用回调功能,默认值为false。
callback_url
String
否
回调服务的地址,enable_callback取值为true时,本字段必选。URL支持HTTP和HTTPS协议,host不可使用IP地址。
auto_split
Boolean
否
是否开启智能分轨(开启智能分轨,即可在两方对话的语音情景下,依据每句话识别结果中的ChannelId,判断该句话的发言人为哪一方。通常先发言一方ChannelId为0,8k双声道开启分轨后默认为2个人,声道channel0和channel1就是音轨编号)。
说明8000\16000 Hz采样率均支持,16k默认只分离首个声道。
supervise_type
Integer
否
说话人分离的确定人数方式,需要和auto_split、speaker_num这两个参数搭配使用。
默认为空:8k由用户指定,16k由算法决定。
1:用户指定人数,具体人数由参数speaker_num确认。
2:算法决定人数。
speaker_num
Integer
否
用于辅助指定声纹人数,取值范围为2至100的整数。8k音频默认为2,16k音频默认为100。
此参数只能辅助算法尽量输出指定人数,无法保证一定会输出此人数。需要和auto_split、supervise_type这两个参数搭配使用。
enable_inverse_text_normalization
Boolean
否
ITN(逆文本inverse text normalization)中文数字转换阿拉伯数字。设置为True时,中文数字将转为阿拉伯数字输出,默认值:False。
enable_disfluency
Boolean
否
过滤语气词,即声音顺滑,默认值false(关闭),开启时需要设置version为4.0。
enable_punctuation_prediction
Boolean
否
是否给句子加标点。默认值true(加标点)。
valid_times
List< ValidTime >
否
有效时间段信息,用来排除一些不需要的时间段。
max_end_silence
Integer
否
允许的最大结束静音,取值范围:200~6000,默认值800,单位为毫秒。
开启语义断句enable_semantic_sentence_detection后,此参数无效。
max_single_segment_time
Integer
否
允许单句话最大结束时间,最小值5000,默认值60000。单位为毫秒。
开启语义断句enable_semantic_sentence_detection后,此参数无效。
customization_id
String
否
通过POP API创建的定制模型ID,默认不添加。
class_vocabulary_id
String
否
创建的类热词表ID,默认不添加。
vocabulary_id
String
否
创建的泛热词表ID,默认不添加。
enable_semantic_sentence_detection
Boolean
否
是否启⽤语义断句,取值:true/false,默认值false。
enable_timestamp_alignment
Boolean
否
是否启用时间戳校准功能,取值:true/false,默认值false。
first_channel_only
Boolean
否
是否只识别首个声道,取值:true/false。(如果录音识别结果重复,您可以开启此参数。)
默认为空:8k处理双声道,16k处理单声道。
false:8k处理双声道,16k处理双声道。
true:8k处理单声道,16k处理单声道。
重要计费模式:
8k处理双声道,按单声道计费,即音频时长进行计费。
16k处理双声道,按双声道计费,即声道数×音频时长进行计费。
special_word_filter
String
否
敏感词过滤功能,支持开启或关闭,支持自定义敏感词。该参数可实现:
不处理(默认,即展示原文)、过滤、替换为*。
具体调用说明请见下文的自定义过滤词调用示例。
说明开启但未配置敏感词,则会过滤默认词表:敏感词表。
punctuation_mark
String
否
自定义标点断句。
不填默认使用句号、问号、叹号断句。如果用户填写此值,则会增加使用用户指定的标点符号断句。
示例:
按英文逗号断句填写","
按中文和英文逗号断句填写",,"
说明如果用户填写的不是标点符号则不生效。
此字段可填多个标点,且会区分中英文标点,标点间无空格。
sentence_max_length
Integer
否
每句最多展示字数,取值范围:[4,50]。默认为不启用该功能。启用后如不填写字数,则按照长句断句。该参数可用于字幕生成场景,控制单行字幕最大字数。
自定义过滤词调用示例如下:
// 以实时转写为例, JSONObject root = new JSONObject(); root.put("system_reserved_filter", true); // 将以下词语替换成空 JSONObject root1 = new JSONObject(); JSONArray array1 = new JSONArray(); array1.add("开始"); array1.add("发生"); root1.put("word_list", array1); // 将以下词语替换成* JSONObject root2 = new JSONObject(); JSONArray array2 = new JSONArray(); array2.add("测试"); root2.put("word_list", array2); // 可以全部设置,也可以部分设置 root.put("filter_with_empty", root1); root.put("filter_with_signed", root2); transcriber.addCustomedParam("special_word_filter", root);其中,ValidTime对象参数说明如下表所示。
参数
值类型
是否必选
说明
begin_time
Int
是
有效时间段的起始点时间偏移,单位为毫秒。
end_time
Int
是
有效时间段的结束点时间偏移,单位为毫秒。
channel_id
Int
是
有效时间段的作用音轨序号(从0开始)。
输出参数及说明:
服务端返回录音文件识别请求的响应,响应的输出参数为JSON格式的字符串:
{ "TaskId": "4b56f0c4b7e611e88f34c33c2a60****", "RequestId": "E4B183CC-6CFE-411E-A547-D877F7BD****", "StatusText": "SUCCESS", "StatusCode": 21050000 }返回HTTP状态:200表示成功,更多状态码请查阅HTTP状态码。
属性
值类型
是否必选
说明
Taskid
String
是
识别任务ID。
RequestId
String
是
请求ID,仅用于联调。
StatusCode
Int
是
状态码。
StatusText
String
是
状态说明。
识别结果查询接口:
提交完录音文件识别请求后,按照如下参数设置轮询识别结果。
输入参数:
通过提交录音文件识别请求获得的任务ID作为识别结果查询接口参数,获取识别结果。在接口调用过程中,需要设置一定的查询时间间隔。
重要查询接口有QPS限制(500QPS),超过QPS之后则可能报错:
Throttling.User : Request was denied due to user flow control.。建议查询接口的轮询间隔时长适当延长,不宜过短。属性
值类型
是否必选
说明
Taskid
String
是
识别任务ID。
输出参数及说明:
服务端返回识别结果查询请求的响应,响应的输出参数为JSON格式的字符串。
正常返回:以录音文件nls-sample-16k.wav(文件为单轨)识别结果为例。
{ "TaskId": "d429dd7dd75711e89305ab6170fe****", "RequestId": "9240D669-6485-4DCC-896A-F8B31F94****", "StatusText": "SUCCESS", "BizDuration": 2956, "SolveTime": 1540363288472, "StatusCode": 21050000, "Result": { "Sentences": [{ "EndTime": 2365, "SilenceDuration": 0, "BeginTime": 340, "Text": "北京的天气。", "ChannelId": 0, "SpeechRate": 177, "EmotionValue": 5.0 }] } }如果开启enable_callback/callback_url,且设置服务版本为4.0,回调识别结果为:
{ "Result": { "Sentences": [{ "EndTime": 2365, "SilenceDuration": 0, "BeginTime": 340, "Text": "北京的天气。", "ChannelId": 0, "SpeechRate": 177, "EmotionValue": 5.0 }] }, "TaskId": "36d01b244ad811e9952db7bb7ed2****", "StatusCode": 21050000, "StatusText": "SUCCESS", "RequestTime": 1553062810452, "SolveTime": 1553062810831, "BizDuration": 2956 }重要RequestTime为时间戳(单位为毫秒,例如1553062810452转换为北京时间为2019/3/20 14:20:10),表示录音文件识别提交请求的时间。
SolveTime为时间戳(单位为毫秒),表示录音文件识别完成的时间。
排队中:
{
        "TaskId": "c7274235b7e611e88f34c33c2a60****",
        "RequestId": "981AD922-0655-46B0-8C6A-5C836822****",
        "StatusText": "QUEUEING",
        "StatusCode": 21050002
}
识别中:
{
        "TaskId": "c7274235b7e611e88f34c33c2a60****",
        "RequestId": "8E908ED2-867F-457E-82BF-4756194A****",
        "StatusText": "RUNNING",
        "BizDuration": 0,
        "StatusCode": 21050001
}
异常返回:以文件下载失败为例。
{ "TaskId": "4cf25b7eb7e711e88f34c33c2a60****", "RequestId": "098BF27C-4CBA-45FF-BD11-3F532F26****", "StatusText": "FILE_DOWNLOAD_FAILED", "BizDuration": 0, "SolveTime": 1536906469146, "StatusCode": 41050002 }说明更多异常情况请查看下面的服务状态码的错误状态码及解决方案。
返回HTTP状态:200表示成功,更多状态码请查阅HTTP状态码。
属性
值类型
是否必选
说明
TaskId
String
是
识别任务ID。
StatusCode
Int
是
状态码。
StatusText
String
是
状态说明。
RequestId
String
是
请求ID,用于调试。
Result
Object
是
识别结果对象。
Sentences
List< SentenceResult >
是
识别的结果数据。当StatusText为SUCCEED时存在。
Words
List< WordResult >
否
词信息,获取时需设置enable_words为true,且设置服务version为”4.0”。
BizDuration
Long
是
识别的音频文件总时长,单位为毫秒。
SolveTime
Long
是
时间戳,单位为毫秒,录音文件识别完成的时间。
其中,单句结果SentenceResult参数如下。
属性
值类型
是否必选
说明
ChannelId
Int
是
该句所属音轨ID。
BeginTime
Int
是
该句的起始时间偏移,单位为毫秒。
EndTime
Int
是
该句的结束时间偏移,单位为毫秒。
Text
String
是
该句的识别文本结果。
EmotionValue
Float
是
情绪能量值,取值为音量分贝值/10。取值范围:[1,10]。值越高情绪越强烈。
SilenceDuration
Int
是
本句与上一句之间的静音时长,单位为秒。
SpeechRate
Int
是
本句的平均语速。
若识别语言为中文,则单位为:字数/分钟。
若识别语言为英文,则单位为:单词数/分钟。
开启返回词信息:
如果enable_words设置为true,且设置服务version为"4.0",服务端的识别结果将包含词信息。使用轮询方式和回调方式获得的词信息相同,以轮询方式的识别结果为例:
{ "StatusCode": 21050000, "Result": { "Sentences": [{ "SilenceDuration": 0, "EmotionValue": 5.0, "ChannelId": 0, "Text": "北京的天气。", "BeginTime": 340, "EndTime": 2365, "SpeechRate": 177 }], "Words": [{ "ChannelId": 0, "Word": "北京", "BeginTime": 640, "EndTime": 940 }, { "ChannelId": 0, "Word": "的", "BeginTime": 940, "EndTime": 1120 }, { "ChannelId": 0, "Word": "天气", "BeginTime": 1120, "EndTime": 2020 }] }, "SolveTime": 1553236968873, "StatusText": "SUCCESS", "RequestId": "027B126B-4AC8-4C98-9FEC-A031158F****", "TaskId": "b505e78c4c6d11e9a213e11db149****", "BizDuration": 2956 }Words对象说明:
属性
值类型
是否必选
说明
BeginTime
Int
是
词开始时间,单位为毫秒。
EndTime
Int
是
词结束时间,单位为毫秒。
ChannelId
Int
是
该词所属音轨ID。
Word
String
是
词信息。
服务状态码
通用错误码
状态码 | 状态消息 | 原因 | 解决方案 |
40000000 | 默认的客户端错误码,对应了多个错误消息。 | 用户使用了不合理的参数或者调用逻辑。 | 请参考官网文档示例代码进行对比测试验证。 |
40000001 | The token 'xxx' has expired; The token 'xxx' is invalid | 用户使用了不合理的参数或者调用逻辑。通用客户端错误码,通常是涉及Token相关的不正确使用,例如Token过期或者非法。 | 请参考官网文档示例代码进行对比测试验证。 |
40000002 | Gateway:MESSAGE_INVALID:Can't process message in state'FAILED'! | 无效或者错误的报文消息。 | 请参考官网文档示例代码进行对比测试验证。 |
40000003 | PARAMETER_INVALID; Failed to decode url params | 用户传递的参数有误,一般常见于RESTful接口调用。 | 请参考官网文档示例代码进行对比测试验证。 |
40000005 | Gateway:TOO_MANY_REQUESTS:Too many requests! | 并发请求过多。 | 如果是试用版调用,建议您升级为商用版本以增大并发。 如果已是商用版,可购买并发资源包,扩充您的并发额度。 |
40000009 | Invalid wav header! | 错误的消息头。 | 如果您发送的是WAV语音文件,且设置 |
40000009 | Too large wav header! | 传输的语音WAV头不合法。 | 建议使用PCM、OPUS等格式发送音频流,如果是WAV,建议关注语音文件的WAV头信息是否为正确的数据长度大小。 |
40000010 | Gateway:FREE_TRIAL_EXPIRED:The free trial has expired! | 试用期已结束,并且未开通商用版、或账号欠费。 | 请登录控制台确认服务开通状态以及账户余额,并按以下步骤排查:
|
40010001 | Gateway:NAMESPACE_NOT_FOUND:RESTful url path illegal | 不支持的接口或参数。 | 请检查调用时传递的参数内容是否和官网文档要求的一致,并结合错误信息对比排查,设置为正确的参数。 比如您是否通过curl命令执行RESTful接口请求, 拼接的URL是否合法。 |
40010003 | Gateway:DIRECTIVE_INVALID:[xxx] | 客户端侧通用错误码。 | 表示客户端传递了不正确的参数或指令,在不同的接口上有对应的详细报错信息,请参考对应文档进行正确设置。 |
40010004 | Gateway:CLIENT_DISCONNECT:Client disconnected before task finished! | 在请求处理完成前客户端主动结束。 | 无,或者请在服务端响应完成后再关闭链接。 |
40010005 | Gateway:TASK_STATE_ERROR:Got stop directive while task is stopping! | 客户端发送了当前不支持的消息指令。 | 请参考官网文档示例代码进行对比测试验证。若提示
|
40020105 | Meta:APPKEY_NOT_EXIST:Appkey not exist! | 使用了不存在的Appkey。 | 请确认是否使用了不存在的Appkey,Appkey可以通过登录控制台后查看项目配置。 |
40020106 | Meta:APPKEY_UID_MISMATCH:Appkey and user mismatch! | 调用时传递的Appkey和Token并非同一个账号UID所创建,导致不匹配。 | 请检查是否存在两个账号混用的情况,避免使用账号A名下的Appkey和账号B名下生成的Token搭配使用。 |
403 | Forbidden | 使用的Token无效,例如Token不存在或者已过期。 | 请设置正确的Token。Token存在有效期限制,请及时在过期前获取新的Token。 |
41000003 | MetaInfo doesn't have end point info | 无法获取该Appkey的路由信息。 | 请检查是否存在两个账号混用的情况,避免使用账号A名下的Appkey和账号B名下生成的Token搭配使用。 |
41010101 | UNSUPPORTED_SAMPLE_RATE | 不支持的采样率格式。 | 当前实时语音识别只支持8000 Hz和16000 Hz两种采样率格式的音频。 |
41040201 | Realtime:GET_CLIENT_DATA_TIMEOUT:Client data does not send continuously! | 获取客户端发送的数据超时失败。 | 客户端在调用实时语音识别时请保持实时速率发送,发送完成后及时关闭链接。 |
50000000 | GRPC_ERROR:Grpc error! | 受机器负载、网络等因素导致的异常,通常为偶发出现。 | 一般重试调用即可恢复。 |
50000001 | GRPC_ERROR:Grpc error! | 受机器负载、网络等因素导致的异常,通常为偶发出现。 | 一般重试调用即可恢复。 |
52010001 | GRPC_ERROR:Grpc error! | 受机器负载、网络等因素导致的异常,通常为偶发出现。 | 一般重试调用即可恢复。 |
录音文件识别/录音文件识别闲时版错误码
状态码 | 状态消息 | 原因 | 解决方案 |
21050000 | SUCCESS | 成功。 | 无。 |
21050001 | RUNNING | 录音文件识别任务运行中。 | 请稍后再发送GET方式的识别结果查询请求。 |
21050002 | QUEUEING | 录音文件识别任务排队中。 | 请稍后再发送GET方式的识别结果查询请求。 |
21050003 | SUCCESS_WITH_NO_VALID_FRAGMENT | 识别结果查询接口调用成功,但是VAD模块未检测到有效语音。 | 此种情况下可检查: 录音文件是否包含有效语音,如果都是无效语音,例如纯静音。上述情况下没有识别结果是正常现象。 |
ASR_RESPONSE_HAVE_NO_WORDS | 识别结果查询接口调用成功,但是最终识别结果为空。 | 此种情况下可检查: 录音文件是否包含有效语音,或有效语音是否都是语气词且开启了顺滑参数enable_disfluency,导致语气词被过滤。 上述情况下没有识别结果是正常现象。 | |
41050001 | USER_BIZDURATION_QUOTA_EXCEED | 单日时间超限(免费用户每日可识别不超过2小时时长的录音文件)。 | 建议从免费版升级到商用版。如业务量较大,请联系商务洽谈,邮件地址:nls_support@service.aliyun.com。 |
41050002 | FILE_DOWNLOAD_FAILED | 文件下载失败。 | 检查录音文件路径是否正确,以及是否可以通过外网访问和下载。 |
41050003 | FILE_CHECK_FAILED | 文件格式错误。 | 检查录音文件是否是单轨/双轨的WAV格式或MP3格式。 |
41050004 | FILE_TOO_LARGE | 文件过大。 | 检查录音文件大小是否超过512 MB,超过则需您对录音文件分段。 |
41050005 | FILE_NORMALIZE_FAILED | 文件归一化失败。 | 检查录音文件是否有损坏,是否可以正常播放。 |
41050006 | FILE_PARSE_FAILED | 文件解析失败。 | 检查录音文件是否有损坏,是否可以正常播放。 |
41050007 | MKV_PARSE_FAILED | MKV解析失败。 | 检查录音文件是否损坏,是否可以正常播放。 |
41050008 | UNSUPPORTED_SAMPLE_RATE | 采样率不匹配。 | 检查实际语音的采样率和控制台上Appkey绑定的ASR模型采样率是否一致,或者将本篇文档中自动降采样的参数enable_sample_rate_adaptive设置为true。 |
41050010 | FILE_TRANS_TASK_EXPIRED | 录音文件识别任务过期。 | TaskId不存在,或者已过期。 |
41050011 | REQUEST_INVALID_FILE_URL_VALUE | 请求file_link参数非法。 | 确认file_link参数格式是否正确。 |
41050012 | REQUEST_INVALID_CALLBACK_VALUE | 请求callback_url参数非法。 | 确认callback_url参数格式是否正确,是否为空。 |
41050013 | REQUEST_PARAMETER_INVALID | 请求参数无效。 | 确认请求task值为有效的JSON格式字符串。 |
41050014 | REQUEST_EMPTY_APPKEY_VALUE | 请求参数appkey值为空。 | 确认是否设置了appkey参数值。 |
41050015 | REQUEST_APPKEY_UNREGISTERED | 请求参数appkey未注册。 | 确认请求参数appkey值是否设置正确,或者是否与阿里云账号的AccessKey ID同一个账号。 |
41050021 | RAM_CHECK_FAILED | RAM检查失败。 | 检查您的RAM用户是否已经授权调用语音服务的API,具体操作,请参见RAM用户权限配置。 |
41050023 | CONTENT_LENGTH_CHECK_FAILED | content-length 检查失败。 | 检查下载文件时,HTTP response中的content-length与文件实际大小是否一致。 |
41050024 | FILE_404_NOT_FOUND | 需要下载的文件不存在。 | 检查需要下载的文件是否存在。 |
41050025 | FILE_403_FORBIDDEN | 没有权限下载需要的文件。 | 检查是否有权限下载录音文件。 |
41050026 | FILE_SERVER_ERROR | 请求的文件所在的服务不可用。 | 检查请求的文件所在的服务是否可用。 |
41050103 | AUDIO_DURATION_TOO_LONG | 请求的文件时长超过12小时。 | 建议将音频进行切分,分多次提交识别任务,切分命令参考。 |
40270003 | DECODER_ERROR | 检测音频文件信息失败。 | 确认文件下载链接中文件为支持的音频格式。 |
51050000 | INTERNAL_ERROR | 受机器负载、网络等因素导致的异常,通常为偶发出现。 | 一般重试调用即可恢复,如无法恢复,请联系技术支持人员。 |
历史版本说明
如果您已接入录音文件识别,即没有设置服务版本为4.0,默认会使用录音文件识别4.0版本。回调方式的识别结果与轮询方式的识别结果在JSON字符串的风格和字段上有所不同, 如果开启enable_callback/callback_url,回调识别结果为:
{
        "result": [{
                "begin_time": 340,
                "channel_id": 0,
                "emotion_value": 5.0,
                "end_time": 2365,
                "silence_duration": 0,
                "speech_rate": 177,
                "text": "北京的天气。"
        }],
        "task_id": "3f5d4c0c399511e98dc025f34473****",
        "status_code": 21050000,
        "status_text": "SUCCESS",
        "request_time": 1551164878830,
        "solve_time": 1551164879230,
        "biz_duration": 2956
}
语音质检场景选型推荐
外呼等业务的语音质检通常需要对通话录音进行事后分析,录音文件识别适用于此类场景。选型时建议重点关注以下能力:
核心能力:
说话人分离:区分通话双方的发言内容,便于分角色核查话术合规性。
高准确率转写:将录音转换为文本,作为质检规则匹配的基础。
时间戳:定位违规话术或关键信息在录音中的具体位置,便于复核取证。
辅助能力:热词定制、静音检测,可用于提升业务术语识别准确率、辅助识别通话中的异常停顿,支撑质检规则的精细化落地。
情绪识别、实时语音识别等能力可根据业务需要按需选配。