
本文介绍向量检索任务卡住、向量索引构建慢和向量索引检索慢三类性能问题的排查与调优方法。
向量检索任务卡住
典型现象:向量检索任务长时间没有进展,LogView 中
AnnIndexScan所在阶段无法拉起足够的 Worker,持续等待资源。调整后的资源与性能变化:将
bucket_num_per_index_file从默认值1调整为4后,索引文件数、检索 Worker 数及对应的资源申请量约降至原来的1/4,即减少约 75%。代价是检索并行度同步下降;在资源原本充足的情况下,检索阶段通常会变慢。如果原任务因资源不足一直卡住,减少并行度后能够正常启动,因此端到端耗时不一定更差。
问题现象
LogView 中向量检索阶段计划实例很多,但当前没有实例成功运行,如图所示:
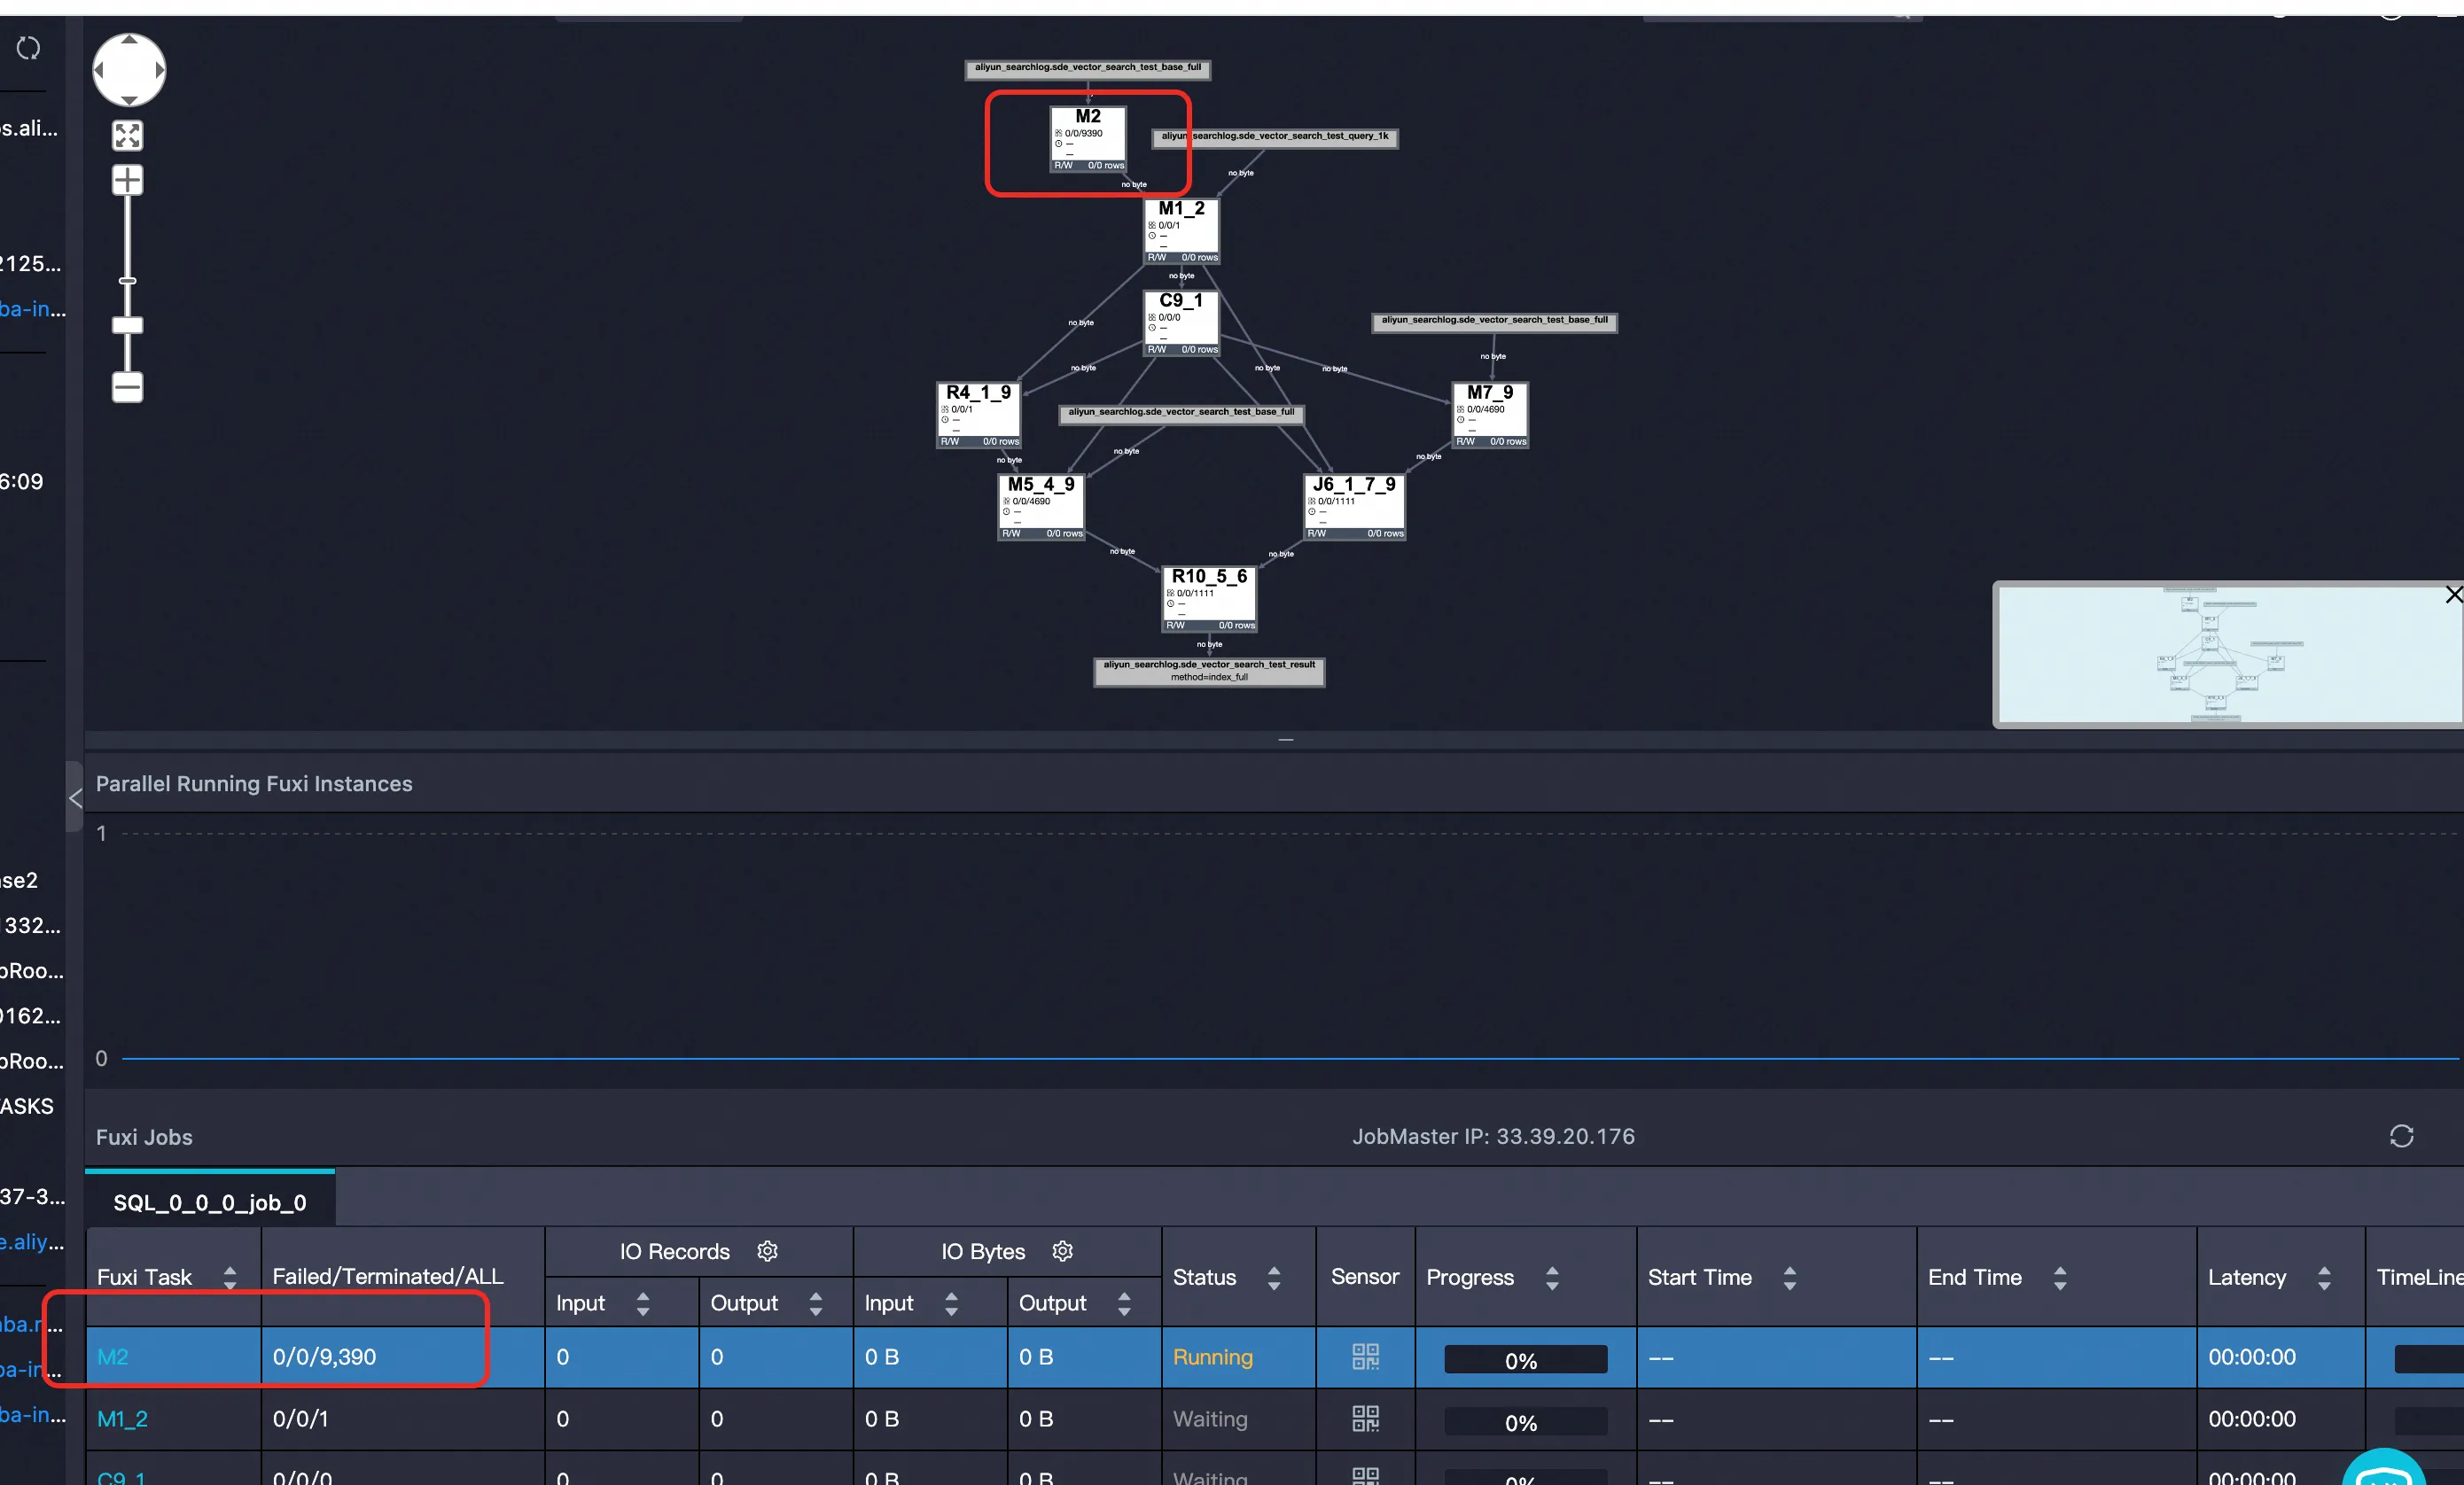
LogView 示例:向量检索阶段计划拉起大量实例,但实际运行数为 0,任务进度保持 0%。如图所示,ogView 中 AnnIndexScan 算子进度为 0%:
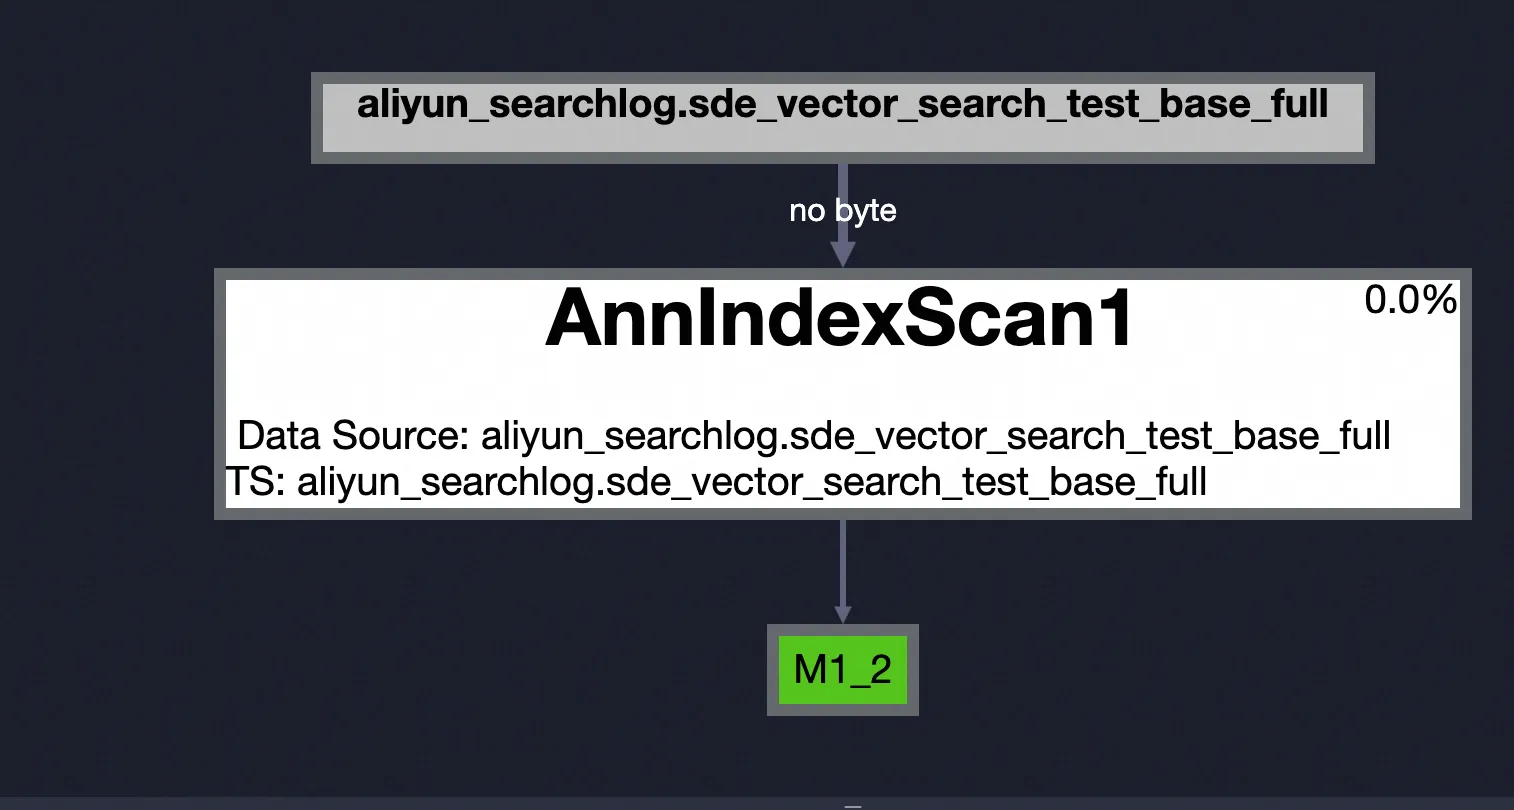
算子详情:AnnIndexScan 进度为 0%,下游阶段无法继续执行。
问题原因
通常是索引文件数量较多,检索阶段需要同时拉起的 AnnIndexScan Worker 数超过当前 Quota 能提供的资源,导致任务长时间等待。
创建索引时可以增大 bucket_num_per_index_file,让一个索引文件包含多个 Bucket,从而减少索引文件数和检索阶段所需的 Worker 数。
操作前请注意:删除索引会暂时影响依赖该索引的检索任务。建议在维护窗口执行,并先记录原索引的算法、距离类型和构建参数。除 bucket_num_per_index_file 外,其余参数应与原索引保持一致。
解决步骤
以下示例使用 doc_table、embedding 和 doc_vector_index。执行前请替换成实际表名、向量列名和索引名;每一步单独提交。
删除原向量索引
SET odps.sql.type.system.odps2=true;
SET odps.sql.type.vector.enable=true;

DROP INDEX doc_vector_index
ON TABLE doc_table;
重新创建索引并调整
bucket_num_per_index_fileSET odps.sql.type.system.odps2=true; SET odps.sql.type.vector.enable=true; CREATE VECTOR INDEX doc_vector_index ON doc_table (embedding) IDXPROPERTIES ( 'algorithm' = 'hgraph', 'distance_type' = 'cosine', 'bucket_num_per_index_file' = '4', 'build_params' = '{"max_degree":16,"ef_construction":128,"base_quantization_type":"fp16"}' );参数
bucket_num_per_index_file:默认值为1。本例设置为4,表示每个索引文件包含 4 个 Bucket。索引文件数、Worker 数和对应的资源申请量约降至原来的1/4。这里的
4是资源不足场景的调优示例,不是所有任务的固定值。减少 Worker 会降低资源申请量,但也会降低检索并行度,因此资源充足时性能通常会变慢。重新构建索引
SET odps.sql.type.system.odps2=true;
SET odps.sql.type.vector.enable=true;

ALTER TABLE doc_table
REBUILD INDEX doc_vector_index;
确认索引状态
SET odps.sql.type.system.odps2=true;

SHOW INDEXES ON doc_table;
确认新索引已经生效,再重新提交原向量检索任务。
验证结果:重新执行查询后,在 LogView 中检查
AnnIndexScan阶段。计划 Worker 数应明显下降,Worker 能够正常启动,任务不再持续等待资源。如果仍然卡住,请继续检查当前 Quota 的可用资源,并适当增大bucket_num_per_index_file。
向量索引构建慢
典型现象:执行
REBUILD INDEX构建向量索引时,构建阶段已经正常运行,但耗时较长。默认配置:
odps.sql.vector.index.build.cores默认值为4,即不设置该参数时,每个索引构建 Worker 默认使用 4 个 CPU Core。显式设置为4不会带来额外提速。调整后的资源与性能变化:将构建 CPU 核数从默认的
4提高到8,可以提高单个构建 Worker 的处理能力,但其 CPU 申请量也会增加一倍。构建耗时不一定按核数等比例下降;如果 Quota 资源不足,作业可能因等待资源而变得更慢。
先确认是否适合增加 CPU
在 LogView 中确认索引构建阶段已经拉起并持续运行。如果主要耗时是资源等待,先解决 Quota 不足;只有构建阶段本身运行较慢时,才适合增加构建 CPU 核数。
解决方法
将 odps.sql.vector.index.build.cores 与实际执行的 REBUILD INDEX 放在同一次提交中。以下示例将每个索引构建 Worker 从默认的 4 Core 提高到 8 Core:
SET odps.sql.type.system.odps2=true;
SET odps.sql.type.vector.enable=true;
SET odps.sql.vector.index.build.cores=8;

ALTER TABLE doc_table
REBUILD INDEX doc_vector_index;
参数odps.sql.vector.index.build.cores:控制每个索引构建 Worker 使用的 CPU 核数。默认值为 4,上限为 16。本例设置为 8;具体值需要结合数据规模和可用 Quota 调整。
注意:设置为 4 等同于使用默认配置,不会加速构建。该参数也不会修改已经运行中的构建任务。不要只在另一个会话中执行 SET,再单独提交 REBUILD INDEX;否则新值可能没有应用到实际构建任务。参数设置过大还可能增加排队时间。
验证结果:在 LogView 中确认构建 Worker 获得了设置的 CPU 核数,并分别记录资源等待时间、构建阶段耗时和总耗时。只有构建阶段耗时下降且排队时间没有明显增加,才说明本次调整有效。
向量索引检索慢
典型现象:任务已经使用持久化向量索引,
AnnIndexScanWorker 也能正常运行,但检索阶段耗时较长。调优原则:先区分是索引 Server 处理能力不足、Query 侧请求供给不足,还是结果合并与写出较慢。索引 Worker 数、每个 Worker 的检索线程数和 Query Worker 数是三种不同的并发,不能用一个参数同时解决。
先判断慢在哪里
LogView 现象 | 判断 | 优先处理 |
| 资源不足,不是搜索计算慢 | 按第 1 节减少索引文件和 Worker 数,或增加可用 Quota |
索引 Server CPU 较高,Query 侧持续等待响应 | 索引 Server 是瓶颈 | 在 Quota 允许时增加每个 Server 的检索线程;必要时重新规划索引 Worker 数 |
索引 Server CPU 较低,Query Worker 数较少或请求不连续 | Query 侧供给不足 | 增加 Query 表的扫描切分并发 |
向量检索阶段已结束,但下游仍耗时很长 | 候选合并或结果写出是瓶颈 | 检查 TopK、输出列、结果行数和下游算子,不再盲目增加搜索线程 |
方法 1:调整每个索引 Server 的检索能力
以下参数必须与实际的 VECTOR_SEARCH 查询放在同一次提交中。本例为每个索引 Server 配置 2 个检索线程,并按约 1 个 CPU Core 对应 1 个检索线程申请资源:
SET odps.sql.type.system.odps2=true;
SET odps.sql.type.vector.enable=true;
SET odps.sql.vector.search.service.thread.count=2;

-- 在同一次提交中执行实际的 VECTOR_SEARCH 查询
参数 | 作用 | 调大或调小的影响 |
| 设置每个索引 Server Worker 的检索线程数,不是整个作业的总 Core 数。 | 调大后单个 Server 可以并行处理更多请求,同时会增加每个 Server 的 CPU 申请和线程竞争。Query 请求不足时,调大通常不会带来收益。 |
例如 16 个索引 Server、每个 2 个线程,仅索引 Server 侧就需要约 32 Core;还必须为 Query、合并和写出阶段预留资源。
注意:增加 service.thread.count 不会增加索引 Server Worker 数。Worker 数主要由 Base 表的 Bucket 和索引文件布局决定。Worker 已经很多时继续增加线程,可能因 Quota 排队或 CPU 竞争而更慢。
方法 2:增加 Query 侧并发
当索引 Server 仍有空闲 CPU,而 Query Worker 数较少时,可以在当前环境和表类型支持的前提下,按 Query 表行数设置扫描切分大小:
SET odps.sql.type.system.odps2=true;
SET odps.sql.type.vector.enable=true;
SET odps.sql.split.row.count={"project_name.query_table":600000};

-- 在同一次提交中执行实际的 VECTOR_SEARCH 查询
参数 | 作用 | 计算与风险 |
| 按表设置每个扫描 Split 的目标行数。数值越小,通常会产生更多 Query Worker,从而更持续地向索引 Server 发送请求。 |
|
参数中的键必须使用执行计划实际扫描的全限定表名,例如 project_name.query_table。设置参数后,需要在 LogView 中确认 Query Worker 数确实发生变化;目标 Split 数不等于同时运行的 Worker 数,实际并发仍受文件布局和 Quota 限制。
方法 3:调整索引布局
如果单个索引 Server 已经持续满载,而 Quota 仍有余量,可以增加索引 Server Worker 数。但索引分片并不是越多越快:每条 Query 需要访问更多索引 Server,并合并更多候选,额外的 RPC 和合并开销可能抵消并行收益。
建议从少量 Worker 建立基线,再按 1 → 2 → 4 或相近梯度测试。对于带类目条件的检索,应让 Base 数据按类目字段分布并排序,避免单个 Bucket 包含过多热点类目;重新布局后需要重新构建向量索引。
结果量也会影响性能
TopK 越大,索引 Server 返回的数据、跨分片候选合并和最终写出量越大。只选择业务需要的 ID、距离及必要字段,不要把向量列重复写入结果;无全局排序需求时,不额外增加 ORDER BY。
验证结果:每次只调整一个主要变量,并为不同测试写入独立结果表或分区。对比 LogView 中的实际 Server Worker 数、每个 Server 的 CPU、Query Worker 数、资源等待、搜索阶段耗时、合并写出耗时和端到端耗时。耗时下降但资源明显增加时,还需要结合 Quota 和资源成本判断是否值得采用。