
本文介绍 PTU(预置吞吐)部署的长输入和前缀缓存能力,包括额度消耗规则、预置吞吐额度计算器使用方法和 API 响应字段说明。
概述
PTU(Provisioned Throughput Unit,预置吞吐)通过平台预留资源,保障特定 TPM 吞吐能力的模型部署方式;在保障额度内不限速。适用于高吞吐、高性能、高负载生产环境,提供稳定的吞吐容量、更低的延迟和更强的资源确定性。相比按 Token 用量计费,TPS(每秒生成的 Token 数)通常提升约 1.5~2.0 倍。
适用场景:
- 银行App的智能客服(流量稳定,需保障并发体验)。
- 社交平台的实时内容审核(需稳定处理可预估的流水线任务)。
- 公有云翻译API(为标准套餐用户提供基线服务保障)。
也常见于长文档分析(合同、研报摘要)和多轮对话(客服、编程助手)等输入超 32K token 的场景。创建 PTU 时可选溢出策略:自动溢出(默认,超量自动转按量计费)或仅使用 PTU 容量(超量返回 429),详见计费规则。
PTU 还支持长输入阶梯容量系数和缓存折扣,详见长输入与前缀缓存。关于前缀缓存的工作原理,请参见上下文缓存。
计费规则
费用 = 使用时长 × (输入 TPM 单价 × 输入 TPM + 输出 TPM 单价 × 输出 TPM)
后付费按小时计算:使用时长单位为小时,单价取下表"持续 1 小时"列;预付费按天计算:使用时长单位为天,单价取下表"持续 1 天"列。
- 预付费订单支付后实时生效,有效期 N 天至第 N 天 23:59 结束。若在 22:00 后下单,到期日将自动顺延1天。
- 预付费订单到期后,将延后2小时停止服务,停止后资源保留14小时后释放。
- 预付费订单支持提前终止服务,已使用部分按 1.2 倍系数结算退费。详见降配退款规则说明。
- 后付费时,如果账户欠费,部署的资源将继续保留并计费 24 小时,在这 24 小时内服务仍可正常使用。超过 24 小时后系统停止计费,模型部署进入欠费状态,底层资源将被删除,但模型部署任务仍会保留。补足欠费后,系统将重新分配资源并恢复使用(恢复后继续产生费用)。如果您不希望继续产生费用,可删除模型部署任务,删除成功后将不再计费。
当模型输入超过最长输入 Token 时,相关调用将自动切换为当前模型的按量计费模式;超出购买的 TPM 量时,按创建时选择的溢出策略处理(「自动溢出」切换为按量计费,「仅使用 PTU 容量」返回 429)。此时,推理性能可能下降,将受业务空间中当前快照模型的公共流量的管控,费用按模型调用(按量计费)标准计收。
- 此时(仅「自动溢出」策略下),调用 API 返回 Header 将包含:
x-dashscope-ptu-overflow:true。 - TPM 统计请前往:模型监控(北京)。
缩容场景(降配)的具体降费退费规则请参考:降配退款规则说明。
说明PTU 部署支持长输入阶梯容量系数和缓存折扣,详见长输入与前缀缓存。
支持模型与价格
华北2(北京)
千问
模型名称 | 模型代码 | 最长输入Token | 后付费输入 Per 10K TPM/小时 | 后付费输出 Per 1K TPM/小时 | 预付费输入 Per 10K TPM/天 | 预付费输出 Per 1K TPM/天 |
|---|---|---|---|---|---|---|
千问3.8-Max | qwen3.8-max | 1M | ¥28.8 | ¥8.64 | ¥345.6 | ¥103.68 |
千问3.7-Flash-2026-07-15 联系商务经理开通 | qwen3.7-flash-2026-07-15 | 128K | ¥0.48 | ¥0.19 | ¥5.76 | ¥2.3 |
千问3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | ¥28.8 | ¥8.64 | ¥345.6 | ¥103.68 |
千问3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | ¥4.8 | ¥1.92 | ¥57.6 | ¥23.04 |
千问3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | ¥4.8 | ¥2.88 | ¥57.6 | ¥34.56 |
千问3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | ¥1.92 | ¥1.15 | ¥23.04 | ¥13.82 |
千问3-Max-2025-09-23 | qwen3-max-2025-09-23 | 128K | ¥7.68 | ¥3.08 | ¥92.16 | ¥36.96 |
千问-Flash-2025-07-28 | qwen-flash-2025-07-28 | 128K | ¥0.36 | ¥0.36 | ¥4.32 | ¥4.32 |
千问-Plus-2025-12-01 | qwen-plus-2025-12-01 | 128K | ¥1.92 | 非思考:¥0.48 思考:¥1.92 | ¥23.04 | 非思考:¥5.76 思考:¥23.04 |
DeepSeek
模型名称 | 模型代码 | 最长输入Token | 后付费输入 Per 10K TPM/小时 | 后付费输出 Per 1K TPM/小时 | 预付费输入 Per 10K TPM/天 | 预付费输出 Per 1K TPM/天 |
|---|---|---|---|---|---|---|
DeepSeek-v4-Flash | deepseek-v4-flash | 256K | ¥3.6 | ¥0.72 | ¥43.2 | ¥8.64 |
DeepSeek-v4-Flash-0731 | deepseek-v4-flash-0731 | 64K | ¥7.2 | ¥1.44 | ¥86.4 | ¥17.28 |
DeepSeek-v4-Pro | deepseek-v4-pro | 256K | ¥43.2 | ¥8.64 | ¥518.4 | ¥103.68 |
DeepSeek-v3 | deepseek-v3 | 64K | ¥7.2 | ¥2.88 | ¥86.4 | ¥34.56 |
千问VL
模型名称 | 模型代码 | 最长输入Token | 后付费输入 Per 10K TPM/小时 | 后付费输出 Per 1K TPM/小时 | 预付费输入 Per 10K TPM/天 | 预付费输出 Per 1K TPM/天 |
|---|---|---|---|---|---|---|
千问3-VL-Plus-2025-09-23 | qwen3-vl-plus-2025-09-23 | 128K | ¥2.4 | ¥2.4 | ¥28.8 | ¥28.8 |
GLM
模型名称 | 模型代码 | 最长输入Token | 后付费输入 Per 10K TPM/小时 | 后付费输出 Per 1K TPM/小时 | 预付费输入 Per 10K TPM/天 | 预付费输出 Per 1K TPM/天 |
|---|---|---|---|---|---|---|
GLM-5.2 | glm-5.2 | 1M | ¥28.8 | ¥10.08 | ¥345.6 | ¥120.96 |
新加坡
千问
模型名称 | 模型代码 | 最长输入Token | 后付费输入 Per 10K TPM/小时 | 后付费输出 Per 1K TPM/小时 | 预付费输入 Per 10K TPM/天 | 预付费输出 Per 1K TPM/天 |
|---|---|---|---|---|---|---|
千问3.8-Max | qwen3.8-max | 1M | ¥35.97 | ¥10.79 | ¥431.7 | ¥129.5 |
千问3.7-Flash-2026-07-15 联系商务经理开通 | qwen3.7-flash-2026-07-15 | 128K | ¥0.54 | ¥0.23 | ¥6.47 | ¥2.81 |
千问3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | ¥44.97 | ¥13.49 | ¥539.6 | ¥161.87 |
千问3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | ¥7.19 | ¥2.88 | ¥86.3 | ¥34.53 |
千问3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | ¥9 | ¥5.4 | ¥107.9 | ¥64.75 |
千问3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | ¥7.2 | ¥4.32 | ¥86.3 | ¥51.8 |
千问3-Max-2025-09-23 | qwen3-max-2025-09-23 | 128K | 以控制台为准 | 以控制台为准 | 以控制台为准 | 以控制台为准 |
千问-Flash-2025-07-28 | qwen-flash-2025-07-28 | 128K | 以控制台为准 | 以控制台为准 | 以控制台为准 | 以控制台为准 |
千问-Plus-2025-12-01 | qwen-plus-2025-12-01 | 128K | 以控制台为准 | 非思考:以控制台为准 思考:以控制台为准 | 以控制台为准 | 非思考:以控制台为准 思考:以控制台为准 |
DeepSeek
模型名称 | 模型代码 | 最长输入Token | 后付费输入 Per 10K TPM/小时 | 后付费输出 Per 1K TPM/小时 | 预付费输入 Per 10K TPM/天 | 预付费输出 Per 1K TPM/天 |
|---|---|---|---|---|---|---|
DeepSeek-v4-Flash | deepseek-v4-flash | 256K | ¥5.4 | ¥1.08 | ¥64.8 | ¥12.95 |
DeepSeek-v4-Flash-0731 | deepseek-v4-flash-0731 | 64K | ¥10.79 | ¥2.16 | ¥129.5 | ¥25.9 |
DeepSeek-v4-Pro | deepseek-v4-pro | 256K | ¥64.75 | ¥12.95 | ¥777 | ¥155.4 |
千问VL
模型名称 | 模型代码 | 最长输入Token | 后付费输入 Per 10K TPM/小时 | 后付费输出 Per 1K TPM/小时 | 预付费输入 Per 10K TPM/天 | 预付费输出 Per 1K TPM/天 |
|---|---|---|---|---|---|---|
千问3-VL-Plus-2025-09-23 | qwen3-vl-plus-2025-09-23 | 128K | ¥3.6 | ¥2.88 | ¥43.2 | ¥34.53 |
GLM
模型名称 | 模型代码 | 最长输入Token | 后付费输入 Per 10K TPM/小时 | 后付费输出 Per 1K TPM/小时 | 预付费输入 Per 10K TPM/天 | 预付费输出 Per 1K TPM/天 |
|---|---|---|---|---|---|---|
GLM-5.2 | glm-5.2 | 1M | ¥37.8 | ¥11.87 | ¥453.3 | ¥142.45 |
长输入与前缀缓存
长输入阶梯系数和缓存折扣按模型不同,以下为当前支持的模型参数:
模型 | 类型 | 输入长度上限 | 缓存折扣 | 长输入阶梯系数 |
|---|---|---|---|---|
glm-5.2 | PTU | (0,1M) | 0.25 | 1 |
qwen3.8-max | PTU | (0,1M) | 0.125 | 1 |
qwen3.7-flash-2026-07-15 | PTU | (0,1M) | 0.2 | 输入输出相同 |
deepseek-v4-flash-0731 | PTU | (0,1M) | 0.1 | 1 |
qwen3.7-plus-2026-05-26 | PTU | PTU | 1 Million | 0.2(缓存命中部分按 20% 折算容量) |
glm-5.1 | PTU | PTU | 200K | 0.2(缓存命中部分按 20% 折算容量) |
deepseek-v4-pro | PTU | PTU | 256K | 0.08(缓存命中部分按 8% 折算容量) |
其他模型 | PTU | PTU | 以控制台为准 | 以控制台为准 |
计算示例(以 glm-5.1 为例)
场景 1:短输入(10K token,无缓存)
  输入消耗:10K × 1.0 = 10KTPM

场景 2:长输入(50K token,无缓存)
  输入消耗:32K × 1.0 + 18K × 1.33 = 55.94 KTPM
  输出消耗(假设 1K token):1K × 1.17 = 1.17 KTPM

场景 3:长输入 + 缓存命中(50K token,前 30K 命中缓存)
  缓存部分输入(前 30K,均在 [0,32K) 阶梯内):
    30K × 1.0 × 0.2 = 6  KTPM
  非缓存部分输入(后 20K):
    2K × 1.0 + 18K × 1.33 = 25.94 KTPM
  输入合计 = 31.940 KTPM(比无缓存节省 43%)
预置吞吐额度计算器
说明建议在创建或扩容前使用计算器评估长输入场景的额度需求,避免额度不足导致请求转为按量计费。购买上限以控制台实际展示为准。
前提条件:已开通百炼服务并具备 PTU 部署权限。登录百炼控制台,在专属部署 > 部署新模型页面(或在已有部署详情页单击扩容),选择可部署的PTU(预置吞吐)模型后,展开预置吞吐额度计算器。
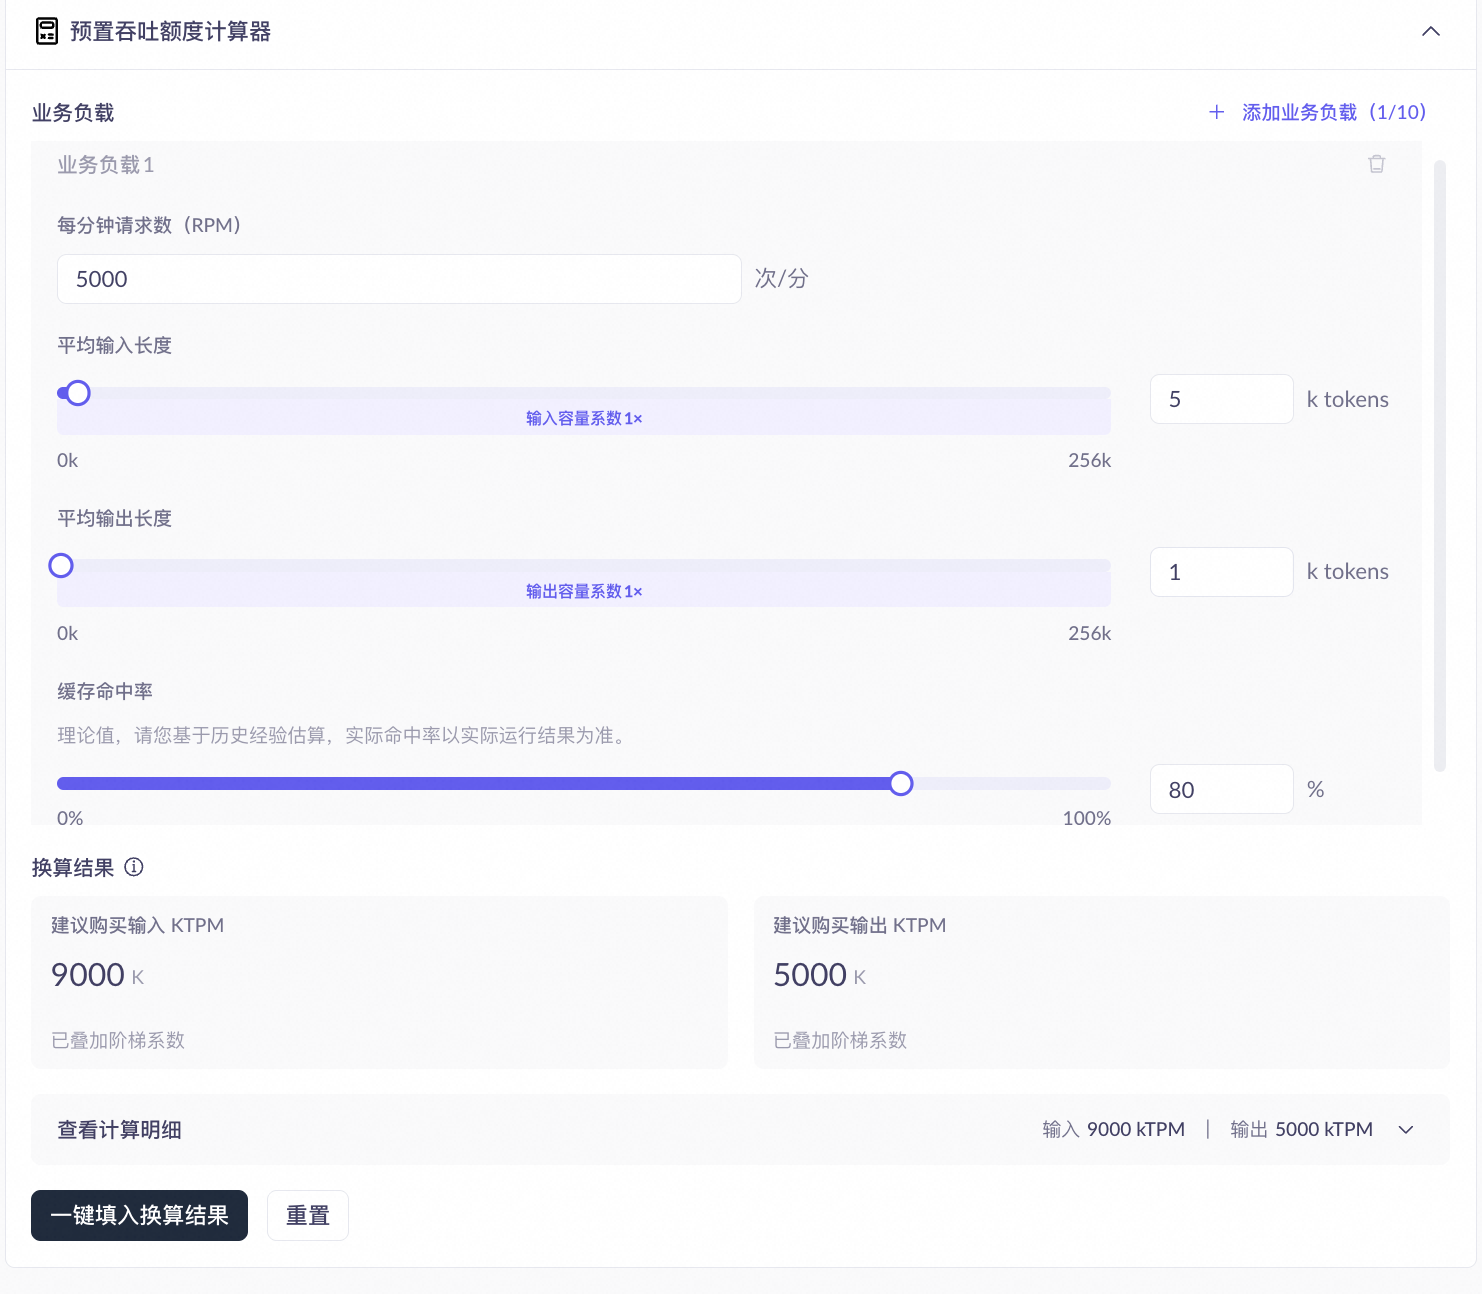
预置吞吐额度计算器根据业务负载自动推荐额度。填写以下参数后,计算器输出建议购买的输入 KTPM 和输出 KTPM。
参数 | 说明 | 对结果的影响 |
|---|---|---|
每分钟请求数(RPM) | 业务高峰期每分钟的请求数。 | RPM 越大,建议购买输入 KTPM 和输出 KTPM 同比增大。 |
平均输入长度(token) | 每条请求的平均输入 token 数。 | 输入越长,所处阶梯越高,系数越大,建议购买输入 KTPM 越高。不同模型的阶梯边界不同,以控制台实际展示为准。 |
平均输出长度(token) | 每条请求的平均输出 token 数。 | 输出越长,系数可能越大,建议购买输出 KTPM 越高。 |
缓存命中率(%) | 请求中重复前缀被缓存命中的比例。实际命中率取决于请求内容的重复程度,以运行结果为准。 | 命中率越高,输入容量消耗越慢,建议购买输入 KTPM 越低。仅影响输入 KTPM,不影响输出 KTPM。 |
API 响应字段
PTU 部署的 API 响应包含以下额度相关字段,用于标识计费方式和额度消耗:
字段 | 类型 | 说明 |
|---|---|---|
| String | 响应体顶层字段(所有 API 格式一致)。值为 |
| Integer | 折算后实际消耗的 PTU 额度 token 数(已含阶梯系数和缓存折扣) |
| Integer | 前缀缓存命中的 token 数,详见上下文缓存 |
不同 API 格式下上述字段的 JSON 路径存在差异:
OpenAI Chat 兼容
字段 | JSON 路径 | 说明 |
|---|---|---|
|
| 输入侧缓存命中数 |
|
| 输入侧 PTU 额度消耗 |
|
| 输出侧 PTU 额度消耗 |
OpenAI Responses
字段 | JSON 路径 | 说明 |
|---|---|---|
|
| 输入侧缓存命中数 |
|
| 输入侧 PTU 额度消耗 |
|
| 输出侧 PTU 额度消耗 |
Anthropic 兼容
字段 | JSON 路径 | 说明 |
|---|---|---|
|
| 输入侧 PTU 额度消耗 |
|
| 输出侧 PTU 额度消耗 |
说明Anthropic 兼容格式暂不返回 cached_tokens 字段,可通过 provisioned_tokens 间接判断缓存效果。
DashScope
字段 | JSON 路径 | 说明 |
|---|---|---|
|
| 输入侧缓存命中数 |
|
| 输入侧 PTU 额度消耗 |
|
| 输出侧 PTU 额度消耗 |
各字段的完整定义和取值范围,请参见API 参考文档。
监控与验证
PTU 部署的运行监控通过百炼平台的模型监控功能实现,支持查看以下与长输入和缓存相关的指标:
- PTU 利用率:输入/输出/思考模式输出三条独立曲线。长输入场景下阶梯系数会使利用率超过 100%,属于正常现象。
- Token 用量与缓存命中:包含
cached_tokens数据系列,可查看缓存命中量占总输入的比例。 - 配额内/外调用次数:了解超出 PTU 额度后的请求占比(自动溢出策略下转为按量计费,仅使用 PTU 容量策略下返回 429)。
更多监控指标和操作方式,请参见模型监控。
扩缩容
点击扩缩容按钮,自助、手动调节吞吐量(实例数量)。具体降费退费规则请参考:降配退款规则说明。
此外,您还可以通过操作列的伸缩配置按钮,配置自动伸缩策略(包括伸缩阈值、最小/最大副本数、定时伸缩等)。
常见问题
Q: 超出 PTU 额度时会怎样?
取决于创建时选择的溢出策略:「自动溢出」策略下,请求自动转为按量计费,API 响应中 service_tier 字段不返回或返回 default,同时响应头包含 x-dashscope-ptu-overflow:true,业务不会中断;「仅使用 PTU 容量」策略下,超出请求返回 429 错误,不产生额外费用。
Q: 单次输入超过模型上限时会怎样?
千问系列模型输入上限为 128K token,DeepSeek 系列为 64K token。超过上限的请求同样自动转为按量计费。
Q: 如何确认缓存是否生效?
检查 API 响应中 cached_tokens 字段,值大于 0 表示前缀缓存命中。缓存命中部分按模型对应的折扣系数消耗额度(具体折扣率见长输入与前缀缓存)。也可在控制台监控页面的 Token 用量图表中查看趋势。
Q: cached_tokens 始终为 0,缓存未生效怎么办?
常见原因:请求间的输入前缀不一致(如 System Message 变化)、两次请求间隔超过缓存有效期、输入 token 数不足以触发缓存。排查方法和缓存使用限制详见上下文缓存。
Q: 利用率为什么超过 100%?
部分模型(如 glm-5.1)的长输入阶梯系数使实际额度消耗高于原始 token 数。利用率 = 折算后消耗 ÷ 购买额度。超过 100% 表示消耗速度超过购买额度,超出部分按溢出策略处理(自动溢出则转为按量计费、不影响服务可用性;仅使用 PTU 容量则返回 429)。