
本文介绍千问实时语音/音视频翻译模型的能力、支持的模型和接入方式。模型可结合音频与图像输入进行实时翻译,输出目标语种的文本或语音,适用于实时语音交流和视频翻译等场景。
在线体验参见通过函数计算一键部署。
功能特性
- 多语言支持:支持 60 种语言互译,其中 29 种支持音频+文本输出、31 种仅支持文本输出,覆盖中文、英语、法语、德语、俄语、日语、韩语、西班牙语、葡萄牙语、阿拉伯语等主流语种。
- 视觉增强:利用视觉内容提升翻译准确性。模型通过分析画面中的口型、动作和文字,改善在嘈杂环境下或一词多义场景中的翻译效果。
- 2.3 秒时延:实现低至 2.3 秒的同传时延。
- 实时说话人分离:支持在多人交替发言时区分不同说话人及其发言内容,让听众清晰了解“谁说了什么”。
- 无损同传:通过语义单元预测技术,解决跨语言语序问题。实时翻译质量接近离线翻译结果。
- 音色自然:生成音色自然的拟人语音。模型能根据源语音内容,自适应调节语气和情感。
- 配置热词:通过热词提升特定词汇的翻译准确性。
- 声音复刻:支持复刻发言人音色用于翻译播报,让输出听起来像本人说外语。支持实时复刻和使用预先复刻的固定音色。
如何使用
1. 配置连接
连接时通过 model 指定支持的模型。以下连接示例使用 qwen3.8-livetranslate-flash-realtime。
通过 WebSocket 接入时,需要以下配置项:
说明支持通过 AOQ、WebRTC 和 WebSocket 协议接入。如果是客户端对接,且更看重稳定的延迟、弱网下的交互能力、实时双工的降噪与回声消除,可优先考虑 AOQ,协议对比与选型请参见Realtime API 概述。
| 配置项 | 说明 |
|---|---|
调用地址 | 华北2(北京)地域:wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/realtime 新加坡地域:wss://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api-ws/v1/realtime 调用时请将 |
查询参数 | 查询参数为model,需指定为访问的模型名。示例: |
消息头 | 使用 Bearer Token 鉴权:Authorization: Bearer DASHSCOPE_API_KEY
|
可通过以下 Python 示例代码建立连接。
WebSocket 连接 Python示例代码
# pip install websocket-client
import json
import websocket
import os

API_KEY=os.getenv("DASHSCOPE_API_KEY")
# 以下为华北2(北京)地域的URL。请将 {WorkspaceId} 替换为您的百炼业务空间ID,各地域的URL不同。
API_URL = "wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/realtime?model=qwen3.8-livetranslate-flash-realtime"

headers = [
    "Authorization: Bearer " + API_KEY
]

def on_open(ws):
    print(f"Connected to server: {API_URL}")
def on_message(ws, message):
    data = json.loads(message)
    print("Received event:", json.dumps(data, indent=2))
def on_error(ws, error):
    print("Error:", error)

ws = websocket.WebSocketApp(
    API_URL,
    header=headers,
    on_open=on_open,
    on_message=on_message,
    on_error=on_error
)

ws.run_forever()
2. 配置语种、输出模态与音色
通过 session.update 配置会话:
-
目标语种:通过
session.translation.language配置,例如en表示英语。使用qwen3.8-livetranslate-flash-realtime时,源语种由模型自动识别。说明使用
qwen3.5-livetranslate-flash-realtime时,如需指定源语种,需通过session.input_audio_transcription.language配置;省略时自动识别。 -
输出模态:使用
qwen3.8-livetranslate-flash-realtime时,通过session.output_modalities配置,["text"]为仅文本,["text", "audio"]为文本和音频(默认)。说明使用
qwen3.5-livetranslate-flash-realtime时,输出模态字段为session.modalities,可选值及默认值相同。 -
原文识别:使用
qwen3.8-livetranslate-flash-realtime时,原文识别始终开启,不支持关闭。通过conversation.item.input_audio_transcription.delta接收识别增量,通过conversation.item.input_audio_transcription.completed接收完整结果。说明使用
qwen3.5-livetranslate-flash-realtime时,原文识别默认开启。如需调整,需通过session.input_audio_transcription.model配置:qwen3-asr-flash-realtime表示开启,null表示关闭。识别增量通过conversation.item.input_audio_transcription.text返回,完整结果通过conversation.item.input_audio_transcription.completed返回。 -
音频与音色:使用
qwen3.8-livetranslate-flash-realtime时,默认输入为 16000 Hz PCM,输出为 24000 Hz PCM,默认音色为Tina。可通过 session.created 返回的session.audio.output.voice查看音色。如需保留说话人的音色,参见声音复刻。说明使用
qwen3.5-livetranslate-flash-realtime时,通过session.sample_rate、session.input_audio_format和session.output_audio_format配置音频,通过session.voice配置音色,默认音色同样为Tina。 -
热词:通过
session.translation.corpus.phrases配置固定译法,详见配置热词。说明建议热词不超过1000个。
3. 输入音频与图片
客户端通过 input_audio_buffer.append 和 input_image_buffer.append 事件发送 Base64 编码的音频和图片数据。音频输入是必需的;图片输入是可选的。
图片可以来自本地文件,或从视频流中实时采集。
使用 qwen3.8-livetranslate-flash-realtime 时,默认采用 session.audio.input.turn_detection.type = speaker_detection,持续发送音频后由服务端自动检测语音起止并生成翻译响应,无需逐句手动提交。配置方法及说话人标识的处理见区分发言人。
qwen3.5-livetranslate-flash-realtime:VAD 与 Manual 模式
模型判断一段语音"说完了"的方式,取决于turn_detection参数配置的 VAD 模式或 Manual 模式:
- VAD 模式(默认):客户端持续发送input_audio_buffer.append事件;服务端检测到语音开始/结束时,分别返回input_audio_buffer.speech_started、input_audio_buffer.speech_stopped事件,并自动提交音频缓冲区、触发翻译。翻译响应基于流式语音同步生成,通常在语音输入过程中就已开始,无需等待语音结束。
- Manual 模式:将
session.turn_detection设为null。客户端发送完一段完整的语音后,主动发送input_audio_buffer.commit事件提交音频缓冲区;服务端返回input_audio_buffer.committed事件确认后,自动开始生成翻译响应,客户端无需再发送其他事件触发响应。提交前若需清空未提交的音频,可发送input_audio_buffer.clear事件。
4. 接收模型响应
使用 qwen3.8-livetranslate-flash-realtime 时,根据输出模态接收响应:
- 仅文本:累加
response.text.delta的delta字段获得译文。 - 文本和音频:累加
response.audio_transcript.delta的delta字段获得译文,并对response.audio.delta的delta字段进行 Base64 解码,获取音频分片。
收到 response.done 表示本次响应结束。事件字段参见服务端事件。
qwen3.5-livetranslate-flash-realtime:响应事件差异
-
输出源语言识别结果
通过
session.input_audio_transcription.model参数配置。设置为qwen3-asr-flash-realtime后,服务端会在翻译的同时返回输入音频的语音识别结果(源语言原文)。启用后,服务端会返回以下事件:
conversation.item.input_audio_transcription.text:流式返回识别结果。conversation.item.input_audio_transcription.completed:识别完成后返回最终结果。conversation.item.input_audio_transcription.failed:识别失败时返回错误信息。
翻译响应基于流式语音同步生成,通常无需等待语音结束(参见上一节 VAD/Manual 模式说明)。模型的响应格式取决于配置的输出模态。
-
仅输出文本
服务端通过response.text.text事件流式返回增量翻译文本(含已确认文本和待确认的预测文本);翻译完成后,通过response.text.done事件返回完整的翻译文本。
-
输出文本+音频
-
文本
通过response.audio_transcript.text事件流式返回增量翻译文本;翻译完成后,通过response.audio_transcript.done事件返回完整的翻译文本。
-
音频
通过response.audio.delta事件返回 Base64 编码的增量音频数据。
-
文本
重要qwen3.5-livetranslate-flash-realtime 使用 response.text.text 事件返回增量文本,与全双工语音对话(Omni)模型的 response.text.delta 事件不同,两者字段结构和语义有差异,请勿混用。
5. 结束会话
音频发送完毕后,客户端必须发送 session.finish 事件通知服务端,然后等待服务端返回 session.finished 事件后再关闭 WebSocket 连接。
重要如果不发送 session.finish,服务端无法得知音频输入已完成,会导致最后一段语音的识别和翻译结果丢失,连接也可能长时间处于等待状态。请务必在关闭连接前发送该事件。
支持的模型
推荐模型
| 模型名称 | 版本 | 上下文长度 | 最大输入 | 最大输出 |
|---|---|---|---|---|
| (Token数) | ||||
| qwen3.8-livetranslate-flash-realtime | 稳定版 | 53248 | 49152 | 4096 |
qwen3.5-livetranslate-flash-realtime
| 稳定版 | 53248 | 49152 | 4096 |
qwen3.5-livetranslate-flash-realtime-2026-05-19 | 快照版 | |||
快速开始
实时翻译麦克风输入
-
使用 Python 3.10 或更高版本,安装
pyaudio:macOS
brew install portaudio && pip install pyaudioDebian/Ubuntu
sudo apt-get install python3-pyaudioCentOS
sudo yum install -y portaudio portaudio-devel && pip install pyaudioWindows
pip install pyaudio安装 WebSocket 依赖:
pip install websocket-client。 -
设置以下环境变量,API Key 和业务空间需属于连接地址所用的地域:
DASHSCOPE_API_KEY: 对应地域和业务空间的 API Key,获取方式见获取 API Key。DASHSCOPE_WORKSPACE_ID: 业务空间 ID,详见业务空间与地域。
-
将下面的代码保存为
livetranslate_client.py,运行python livetranslate_client.py,然后对着麦克风说话。
示例使用 qwen3.8-livetranslate-flash-realtime,将麦克风输入翻译为英语,实时打印译文并播放译音。输入为 16000 Hz、单声道、16 位 PCM,播放的译音为 24000 Hz、单声道、16 位 PCM。按 Ctrl+C 停止录音后,示例发送 session.finish,继续接收并播放剩余结果,收到 session.finished 后关闭连接。建议使用耳机,避免译音再次进入麦克风。
import base64
import json
import os
import signal
import threading
import time

import pyaudio
import websocket

model = "qwen3.8-livetranslate-flash-realtime"
workspace_id = os.environ["DASHSCOPE_WORKSPACE_ID"]
api_key = os.environ["DASHSCOPE_API_KEY"]
url = (
    f"wss://{workspace_id}.cn-beijing.maas.aliyuncs.com"
    f"/api-ws/v1/realtime?model={model}"
)
stop_recording = False
send_errors = []
ws = None
audio = None
input_stream = None
output_stream = None
sender = None
previous_sigint_handler = None


def receive():
    event = json.loads(ws.recv())
    if event.get("type") == "error" or event.get("code"):
        raise RuntimeError(event)
    return event


def stop_input(signum, frame):
    global stop_recording
    stop_recording = True


def send_audio():
    try:
        while not stop_recording:
            chunk = input_stream.read(1600)
            ws.send(json.dumps({
                "type": "input_audio_buffer.append",
                "audio": base64.b64encode(chunk).decode("ascii"),
            }))
    except Exception as error:
        send_errors.append(error)
    finally:
        try:
            ws.send(json.dumps({"type": "session.finish"}))
        except Exception as error:
            send_errors.append(error)
            ws.close()


def receive_translation():
    while True:
        event = receive()
        event_type = event.get("type")
        if event_type in ("response.text.delta", "response.audio_transcript.delta"):
            print(event["delta"], end="", flush=True)
        elif event_type == "response.audio.delta":
            output_stream.write(base64.b64decode(event["delta"]))
        elif event_type == "response.done":
            if event["response"]["status"] != "completed":
                raise RuntimeError(event["response"])
            print()
        elif event_type == "session.finished":
            return


try:
    ws = websocket.create_connection(
        url, header={"Authorization": f"Bearer {api_key}"}, timeout=30
    )
    while receive().get("type") != "session.created":
        pass
    ws.send(json.dumps({
        "type": "session.update",
        "session": {
            "output_modalities": ["text", "audio"],
            "translation": {"language": "en"},
        },
    }))
    while receive().get("type") != "session.updated":
        pass
    audio = pyaudio.PyAudio()
    input_stream = audio.open(
        format=pyaudio.paInt16, channels=1, rate=16000,
        input=True, frames_per_buffer=1600,
    )
    output_stream = audio.open(
        format=pyaudio.paInt16, channels=1, rate=24000, output=True,
    )
    print("请开始说话;按 Ctrl+C 停止录音并等待剩余翻译。")
    previous_sigint_handler = signal.signal(signal.SIGINT, stop_input)
    sender = threading.Thread(target=send_audio, daemon=True)
    sender.start()
    receive_translation()
    stop_recording = True
    sender.join()
    if send_errors:
        raise send_errors[0]
except Exception:
    if send_errors:
        raise send_errors[0]
    raise
finally:
    stop_recording = True
    if ws is not None:
        ws.close()
    if sender is not None:
        sender.join()
    for stream in (input_stream, output_stream):
        if stream is not None:
            stream.stop_stream()
            stream.close()
    if audio is not None:
        audio.terminate()
    if previous_sigint_handler is not None:
        signal.signal(signal.SIGINT, previous_sigint_handler)
配置热词
对于需要固定译法或区分同音词的翻译场景,添加热词可以提升翻译准确性。例如:
- 固定译法:阿里云 slogan“计算,为了无法计算的价值。”约定的英文是“Computing, for the value beyond computation.”,需要保留措辞和语序。
- 同音品牌名:Qoder 与普通词 coder 发音相同。如果说的是产品 Qoder,译文需要保留品牌拼写。
下面是两组测试的输出对照,每组使用相同音频,仅改变热词配置。
| 输入音频内容 | 未配置热词 | 配置热词 |
|---|---|---|
| 计算,为了无法计算的价值。 | Calculate. For values that cannot be calculated. | Computing, for the value beyond computation. |
| Qoder 是面向真实工作的 Agentic 平台。 | Coder is an agentic system designed for real-world work. platform. | Qoder, is an agentic platform designed for real-world work. |
配置方法
热词通过 session.translation.corpus.phrases 配置,以 key-value 形式将源语言词语或短语映射为目标译法。
在快速开始的首次 session.update 请求中,将下列 translation 对象合入现有 session,保留会话已有的输出模态、音色等设置。
{
  "event_id": "configure-hotwords",
  "type": "session.update",
  "session": {
    "translation": {
      "language": "en",
      "corpus": {
        "phrases": {
          "计算,为了无法计算的价值。": "Computing, for the value beyond computation.",
          "Qoder": "Qoder"
        }
      }
    }
  }
}
发送音频前完成配置,收到服务端的 session.updated 后,再开始发送 input_audio_buffer.append。
区分发言人
qwen3.8-livetranslate-flash-realtime 可识别不同发言人,通过 speaker_id 标识。根据该标识关联原文和译文后,可以按发言人展示字幕。
在 session.update 中保留默认 speaker_detection,或显式配置如下。threshold 用于区分静音和有效人声,低于阈值的声音会被过滤,不会输入模型。该阈值固定为 0.5。
{
  "type": "session.update",
  "session": {
    "audio": {
      "input": {
        "turn_detection": {"type": "speaker_detection", "threshold": 0.5}
      }
    }
  }
}
收到事件后,按以下顺序关联:
- 从
input_audio_buffer.speech_started获取speaker_id和item_id,记录原文消息项对应的说话人。 - 从
conversation.item.input_audio_transcription.delta获取同一item_id的原文。 - 从译文的
conversation.item.created获取item.id和事件顶层的previous_item_id,把译文消息项关联到原文消息项。 - 收到译文增量后,通过其
item_id找到原文和说话人,再更新对应字幕。
将以下变量和函数放在快速开始的麦克风示例中,位于 def receive_translation(): 之前。在该函数内,紧接 event = receive() 调用 handle_speaker_event(event),并将原来的 print(event["delta"], end="", flush=True) 替换为 pass,由下面的片段统一输出字幕。每次原文或译文更新时,片段会打印发言人标识、原文和译文,便于按发言人展示字幕。保留原有音频处理和会话结束逻辑。
speaker_by_source = {}
source_by_translation = {}
source_text = {}
translation_text = {}


def show_subtitle(translation_id):
    source_id = source_by_translation.get(translation_id)
    if source_id not in speaker_by_source or translation_id not in translation_text:
        return
    print({
        "speaker_id": speaker_by_source[source_id],
        "source": source_text.get(source_id, ""),
        "translation": translation_text[translation_id],
    })


def handle_speaker_event(event):
    event_type = event.get("type")
    if event_type in ("response.text.delta", "response.audio_transcript.delta"):
        item_id = event["item_id"]
        translation_text[item_id] = translation_text.get(item_id, "") + event["delta"]
        show_subtitle(item_id)
        return
    if event_type == "conversation.item.created":
        item = event["item"]
        if any(part.get("type") == "input_audio" for part in item.get("content", [])):
            return
        source_id = event.get("previous_item_id")
        if item.get("role") == "assistant" and source_id is not None:
            source_by_translation[item["id"]] = source_id
            show_subtitle(item["id"])
        return
    if event_type == "input_audio_buffer.speech_started" and "speaker_id" in event:
        source_id = event["item_id"]
        speaker_by_source[source_id] = event["speaker_id"]
    elif event_type == "conversation.item.input_audio_transcription.delta":
        source_id = event["item_id"]
        source_text[source_id] = source_text.get(source_id, "") + event["delta"]
    elif event_type == "conversation.item.input_audio_transcription.completed":
        source_id = event["item_id"]
        source_text[source_id] = event["transcript"]
    else:
        return
    for translation_id, mapped_source in source_by_translation.items():
        if mapped_source == source_id:
            show_subtitle(translation_id)
利用图像提升翻译准确率
千问实时翻译系列模型支持图像输入,辅助音频翻译,适用于同音异义、低频专有名词识别场景。建议每秒发送不超过2张图片。
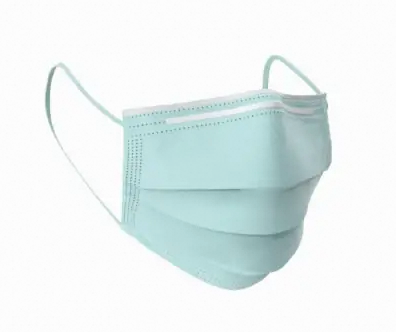
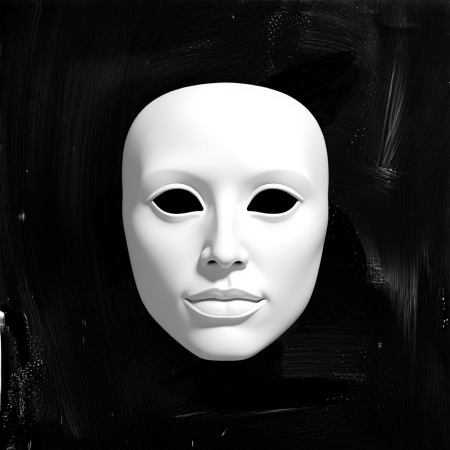
复用快速开始的麦克风输入和连接配置:
- 安装图像处理依赖:
pip install Pillow。 - 将目标语种
translation.language改为zh,运行示例时对着麦克风说What is mask?。 - 在麦克风示例的
def send_audio():之前加入下面的图像读取代码,并用新的send_audio()替换原函数。片段使用已有的input_stream、stop_recording、ws、send_errors和导入项。
import io
from PIL import Image

IMAGE_PATH = "口罩.png"
# IMAGE_PATH = "面具.png"
with Image.open(IMAGE_PATH) as image:
    buffer = io.BytesIO()
    image.convert("RGB").save(buffer, format="JPEG")
image_bytes = buffer.getvalue()
if len(image_bytes) > 500_000:
    raise ValueError("JPEG > 500 KB")
image_b64 = base64.b64encode(image_bytes).decode("ascii")


def send_audio():
    try:
        last_image_time = None
        while not stop_recording:
            chunk = input_stream.read(1600)
            ws.send(json.dumps({
                "type": "input_audio_buffer.append",
                "audio": base64.b64encode(chunk).decode("ascii"),
            }))
            now = time.monotonic()
            if last_image_time is None or now - last_image_time >= 0.5:
                ws.send(json.dumps({
                    "type": "input_image_buffer.append",
                    "image": image_b64,
                }))
                last_image_time = now
    except Exception as error:
        send_errors.append(error)
    finally:
        try:
            ws.send(json.dumps({"type": "session.finish"}))
        except Exception as error:
            send_errors.append(error)
            ws.close()
图片与音频交错发送,每 0.5 秒最多发送一帧。分别使用口罩和面具图片,对照译文中的 mask 是否译成对应物品;按 Ctrl+C 停止录音后,示例会请求结束会话并接收剩余结果。
声音复刻
模型支持发言人声音复刻功能,支持使用预先复刻的固定音色,也支持在翻译过程中实时复刻,让翻译播报听起来像本人说外语。适用于跨语言演讲、个人主播、视频翻译等需要保留个人音色的场景。
实时复刻:qwen3.8-livetranslate-flash-realtime 和 qwen3.5-livetranslate-flash-realtime 在翻译过程中从输入音频复刻音色,不额外收取复刻费用;模型调用仍按 Token 用量计费。
提前创建音色:通过声音复刻 API提前创建音色,按 0.01 元/个计费,创建失败不计费;免费额度的地域、次数与有效期见该计费说明。使用已创建的音色翻译时,仍按模型调用的 Token 用量计费。
在 session.update 中设置以下参数启用:
-
session.enable_voice_clone:设置为true,启用声音复刻。 -
session.voice_clone_options.frequency:控制声音复刻时机,取值如下:never:使用预先准备的固定音色,不在本次翻译过程中重新提取音色。此时session.voice需设置为用户自己的复刻音色 ID。once:在会话开始时从输入音频提取一次音色,本次会话后续的翻译输出复用这一音色。“一次”指提取次数,并非只生成一次译音。适合单人演讲场景。此时session.voice需设置为default。always:每次生成翻译音频前,从输入音频重新提取音色;发言人变化时,译音的音色也随之变化。适合双人及以上对话场景。此时session.voice需设置为default。
-
session.voice:指定输出音色,取值取决于frequency的设置。- 设置为
default:搭配frequency为once或always使用,复刻输入音频的音色,复刻完成前使用默认音色过渡。 - 设置为用户复刻的音色 ID(如
qwen-translate-vc-xxx-yyy-zzz):搭配frequency为never使用。需提前通过声音复刻API准备音色,target_model需指定为实际使用的翻译模型。
- 设置为
当
frequency为once或always时,voice必须设置为default,不可设置为其他预设音色,否则服务端会返回错误。
声音复刻配置示例
使用 qwen3.8-livetranslate-flash-realtime 时,将对应的 session.update 配置替换到快速开始的该模型示例中。
说明使用 qwen3.5-livetranslate-flash-realtime 时,将示例中的 session.output_modalities 替换为 session.modalities,其余复刻参数相同。连接时需将 model 指定为该模型,并按接收模型响应中的对应说明处理响应事件。
使用预先复刻的音色(适合需要固定音色的场景):
{
    "type": "session.update",
    "session": {
        "output_modalities": ["text","audio"],
        "voice": "qwen-translate-vc-xxx-yyy-zzz",
        "translation": {
            "language": "en"
        },
        "enable_voice_clone": true,
        "voice_clone_options": {
            "frequency": "never"
        }
    }
}
在当前会话中复用同一音色(适合单人演讲):
{
    "type": "session.update",
    "session": {
        "output_modalities": ["text","audio"],
        "voice": "default",
        "translation": {
            "language": "en"
        },
        "enable_voice_clone": true,
        "voice_clone_options": {
            "frequency": "once"
        }
    }
}
让译音跟随发言人变化(适合多人对话):
{
    "type": "session.update",
    "session": {
        "output_modalities": ["text","audio"],
        "voice": "default",
        "translation": {
            "language": "en"
        },
        "enable_voice_clone": true,
        "voice_clone_options": {
            "frequency": "always"
        }
    }
}
通过函数计算一键部署
控制台暂不支持体验。可通过以下方式一键部署:
-
打开我们写好的函数计算模板,填入 API Key, 单击创建并部署默认环境即可在线体验。
-
等待约一分钟,在 环境详情 > 环境信息 中获取访问域名,将访问域名的
http改成https(例如https://qwen-livetranslate-flash-realtime.fcv3.xxx.cn-hangzhou.fc.devsapp.net/),通过该链接与模型交互。重要此链接使用自签名证书,仅用于临时测试。首次访问时,浏览器会显示安全警告,这是预期行为,请勿在生产环境使用。如需继续,请按浏览器提示操作(如点击“高级” → “继续前往(不安全)”)。
如需开通访问控制权限,请跟随页面指引操作。
通过资源信息-函数资源查看项目源代码。
函数计算与阿里云百炼均为新用户提供免费额度,可以覆盖简单调试所需成本,额度耗尽后按量计费。只有在访问的情况下会产生费用。
交互流程
使用 qwen3.8-livetranslate-flash-realtime 时,默认通过服务端断句生成响应,主要交互环节如下。事件字段详见服务端事件。
阶段 | 客户端操作 | 服务端事件 |
|---|---|---|
创建和配置会话 | 建立连接,发送 |
|
输入音频 |
| 原文通过 |
接收译文与音频 | 持续接收服务端事件 | 译文通过 |
结束会话 |
| 收到 |
qwen3.5-livetranslate-flash-realtime:交互流程
实时语音翻译的交互流程遵循标准的 WebSocket 事件驱动模型。语音起止的判断方式取决于 VAD 模式或 Manual 模式(参见3. 输入音频与图片),下表以 VAD 模式(默认)为主线,并标注了 Manual 模式下不同的服务端事件。
| 生命周期 | 客户端事件 | 服务端事件 |
|---|---|---|
会话初始化 | session.update
| session.created
session.updated
|
用户音频输入 | input_audio_buffer.append
input_image_buffer.append
input_audio_buffer.commit
| VAD 模式: input_audio_buffer.speech_started
input_audio_buffer.speech_stopped
Manual 模式: input_audio_buffer.committed
|
服务端音频输出 | 无 | response.created
response.output_item.added
conversation.item.created
response.content_part.added
response.text.text
response.audio_transcript.text
response.audio.delta
response.text.done
response.audio_transcript.done
response.audio.done
response.content_part.done
response.output_item.done
response.done
|
会话结束 | session.finish
| session.finished
|
重要音频发送结束后,必须发送 session.finish 事件并等待 session.finished 响应后再断开连接。如果直接关闭 WebSocket 而不发送 session.finish,服务端无法得知音频输入已结束,将导致最后一段语音的识别和翻译结果丢失。
API 参考
通过 AOQ 接入的流程和示例,请参见AOQ 接入。支持的模型及版本请参见模型与协议支持范围。
- 实时音视频翻译(Qwen-Livetranslate-Realtime)。
- Realtime API 概述(WebRTC 协议说明)
计费说明
-
Qwen3.8-LiveTranslate-Flash-Realtime、Qwen3.5-LiveTranslate-Flash-Realtime
- 音频:输入每秒音频消耗 7 Token,输出每秒音频消耗 12.5 Token。
- 图片:每输入 32*32 像素消耗 0.5 Token。 各模型的 Token 单价请参见模型调用计费。
实时复刻:qwen3.8-livetranslate-flash-realtime 和 qwen3.5-livetranslate-flash-realtime 在翻译过程中从输入音频复刻音色,不额外收取复刻费用;模型调用仍按 Token 用量计费。
提前创建音色:通过声音复刻 API提前创建音色,按 0.01 元/个计费,创建失败不计费;免费额度的地域、次数与有效期见该计费说明。使用已创建的音色翻译时,仍按模型调用的 Token 用量计费。
限流说明
模型的限流规则请参见限流。
支持的语种
下表中的语种代码可用于指定源语种与目标语种。
部分目标语种仅支持输出文本,不支持输出音频。
语种代码 | 语种 | 支持的输出模态 |
|---|---|---|
zh | 中文 | 音频+文本 |
en | 英语 | 音频+文本 |
ar | 阿拉伯语 | 音频+文本 |
de | 德语 | 音频+文本 |
fr | 法语 | 音频+文本 |
es | 西班牙语 | 音频+文本 |
pt | 葡萄牙语 | 音频+文本 |
id | 印度尼西亚语 | 音频+文本 |
it | 意大利语 | 音频+文本 |
ko | 韩语 | 音频+文本 |
ru | 俄语 | 音频+文本 |
th | 泰语 | 音频+文本 |
vi | 越南语 | 音频+文本 |
ja | 日语 | 音频+文本 |
tr | 土耳其语 | 音频+文本 |
hi | 印地语 | 音频+文本 |
ms | 马来语 | 音频+文本 |
nl | 荷兰语 | 音频+文本 |
ur | 乌尔都语 | 音频+文本 |
nb | 挪威语 | 音频+文本 |
sv | 瑞典语 | 音频+文本 |
da | 丹麦语 | 音频+文本 |
he | 希伯来语 | 音频+文本 |
fi | 芬兰语 | 音频+文本 |
pl | 波兰语 | 音频+文本 |
is | 冰岛语 | 音频+文本 |
cs | 捷克语 | 音频+文本 |
fil | 菲律宾语 | 音频+文本 |
fa | 波斯语 | 音频+文本 |
yue | 粤语 | 文本 |
el | 希腊语 | 文本 |
af | 南非荷兰语 | 文本 |
ast | 阿斯图里亚斯语 | 文本 |
be | 白俄罗斯语 | 文本 |
bg | 保加利亚语 | 文本 |
bn | 孟加拉语 | 文本 |
bs | 波斯尼亚语 | 文本 |
ca | 加泰罗尼亚语 | 文本 |
ceb | 宿务语 | 文本 |
et | 爱沙尼亚语 | 文本 |
gl | 加利西亚语 | 文本 |
gu | 古吉拉特语 | 文本 |
hr | 克罗地亚语 | 文本 |
hu | 匈牙利语 | 文本 |
jv | 爪哇语 | 文本 |
kk | 哈萨克语 | 文本 |
kn | 卡纳达语 | 文本 |
ky | 柯尔克孜语 | 文本 |
lv | 拉脱维亚语 | 文本 |
mk | 马其顿语 | 文本 |
ml | 马拉雅拉姆语 | 文本 |
mr | 马拉地语 | 文本 |
pa | 旁遮普语 | 文本 |
ro | 罗马尼亚语 | 文本 |
sk | 斯洛伐克语 | 文本 |
sl | 斯洛文尼亚语 | 文本 |
sw | 斯瓦希里语 | 文本 |
tg | 塔吉克语 | 文本 |
az | 阿塞拜疆语 | 文本 |
uk | 乌克兰语 | 文本 |
支持的音色
实时翻译支持的音色与voice参数取值参见音色列表。