
本文介绍通过 AOQ Client SDK 接入 Realtime API 的通用流程:获取连接凭证、初始化 SDK、配置媒体方向、建立连接、按目标模型协议交互,以及释放资源。
AOQ 将音视频媒体与模型事件分轨传输。SDK 负责媒体采集、编解码、传输和播放;应用通过 Data 轨发送模型事件并处理回复。接入不同模型时,需要分别选择媒体方向和模型事件协议。
前提条件
-
已完成接入概览中的准备工作,并确认目标模型、地域和 AOQ 支持范围。
-
已从 SDK 下载导入对应平台 SDK;使用 Opus 时,导入对应插件。
-
业务 AppServer 已实现 Token 鉴权。API Key 保存在 AppServer,客户端使用临时连接凭证。
说明仅在需要采集时申请麦克风或摄像头权限。例如,语音合成不需要这两项权限。
整体流程
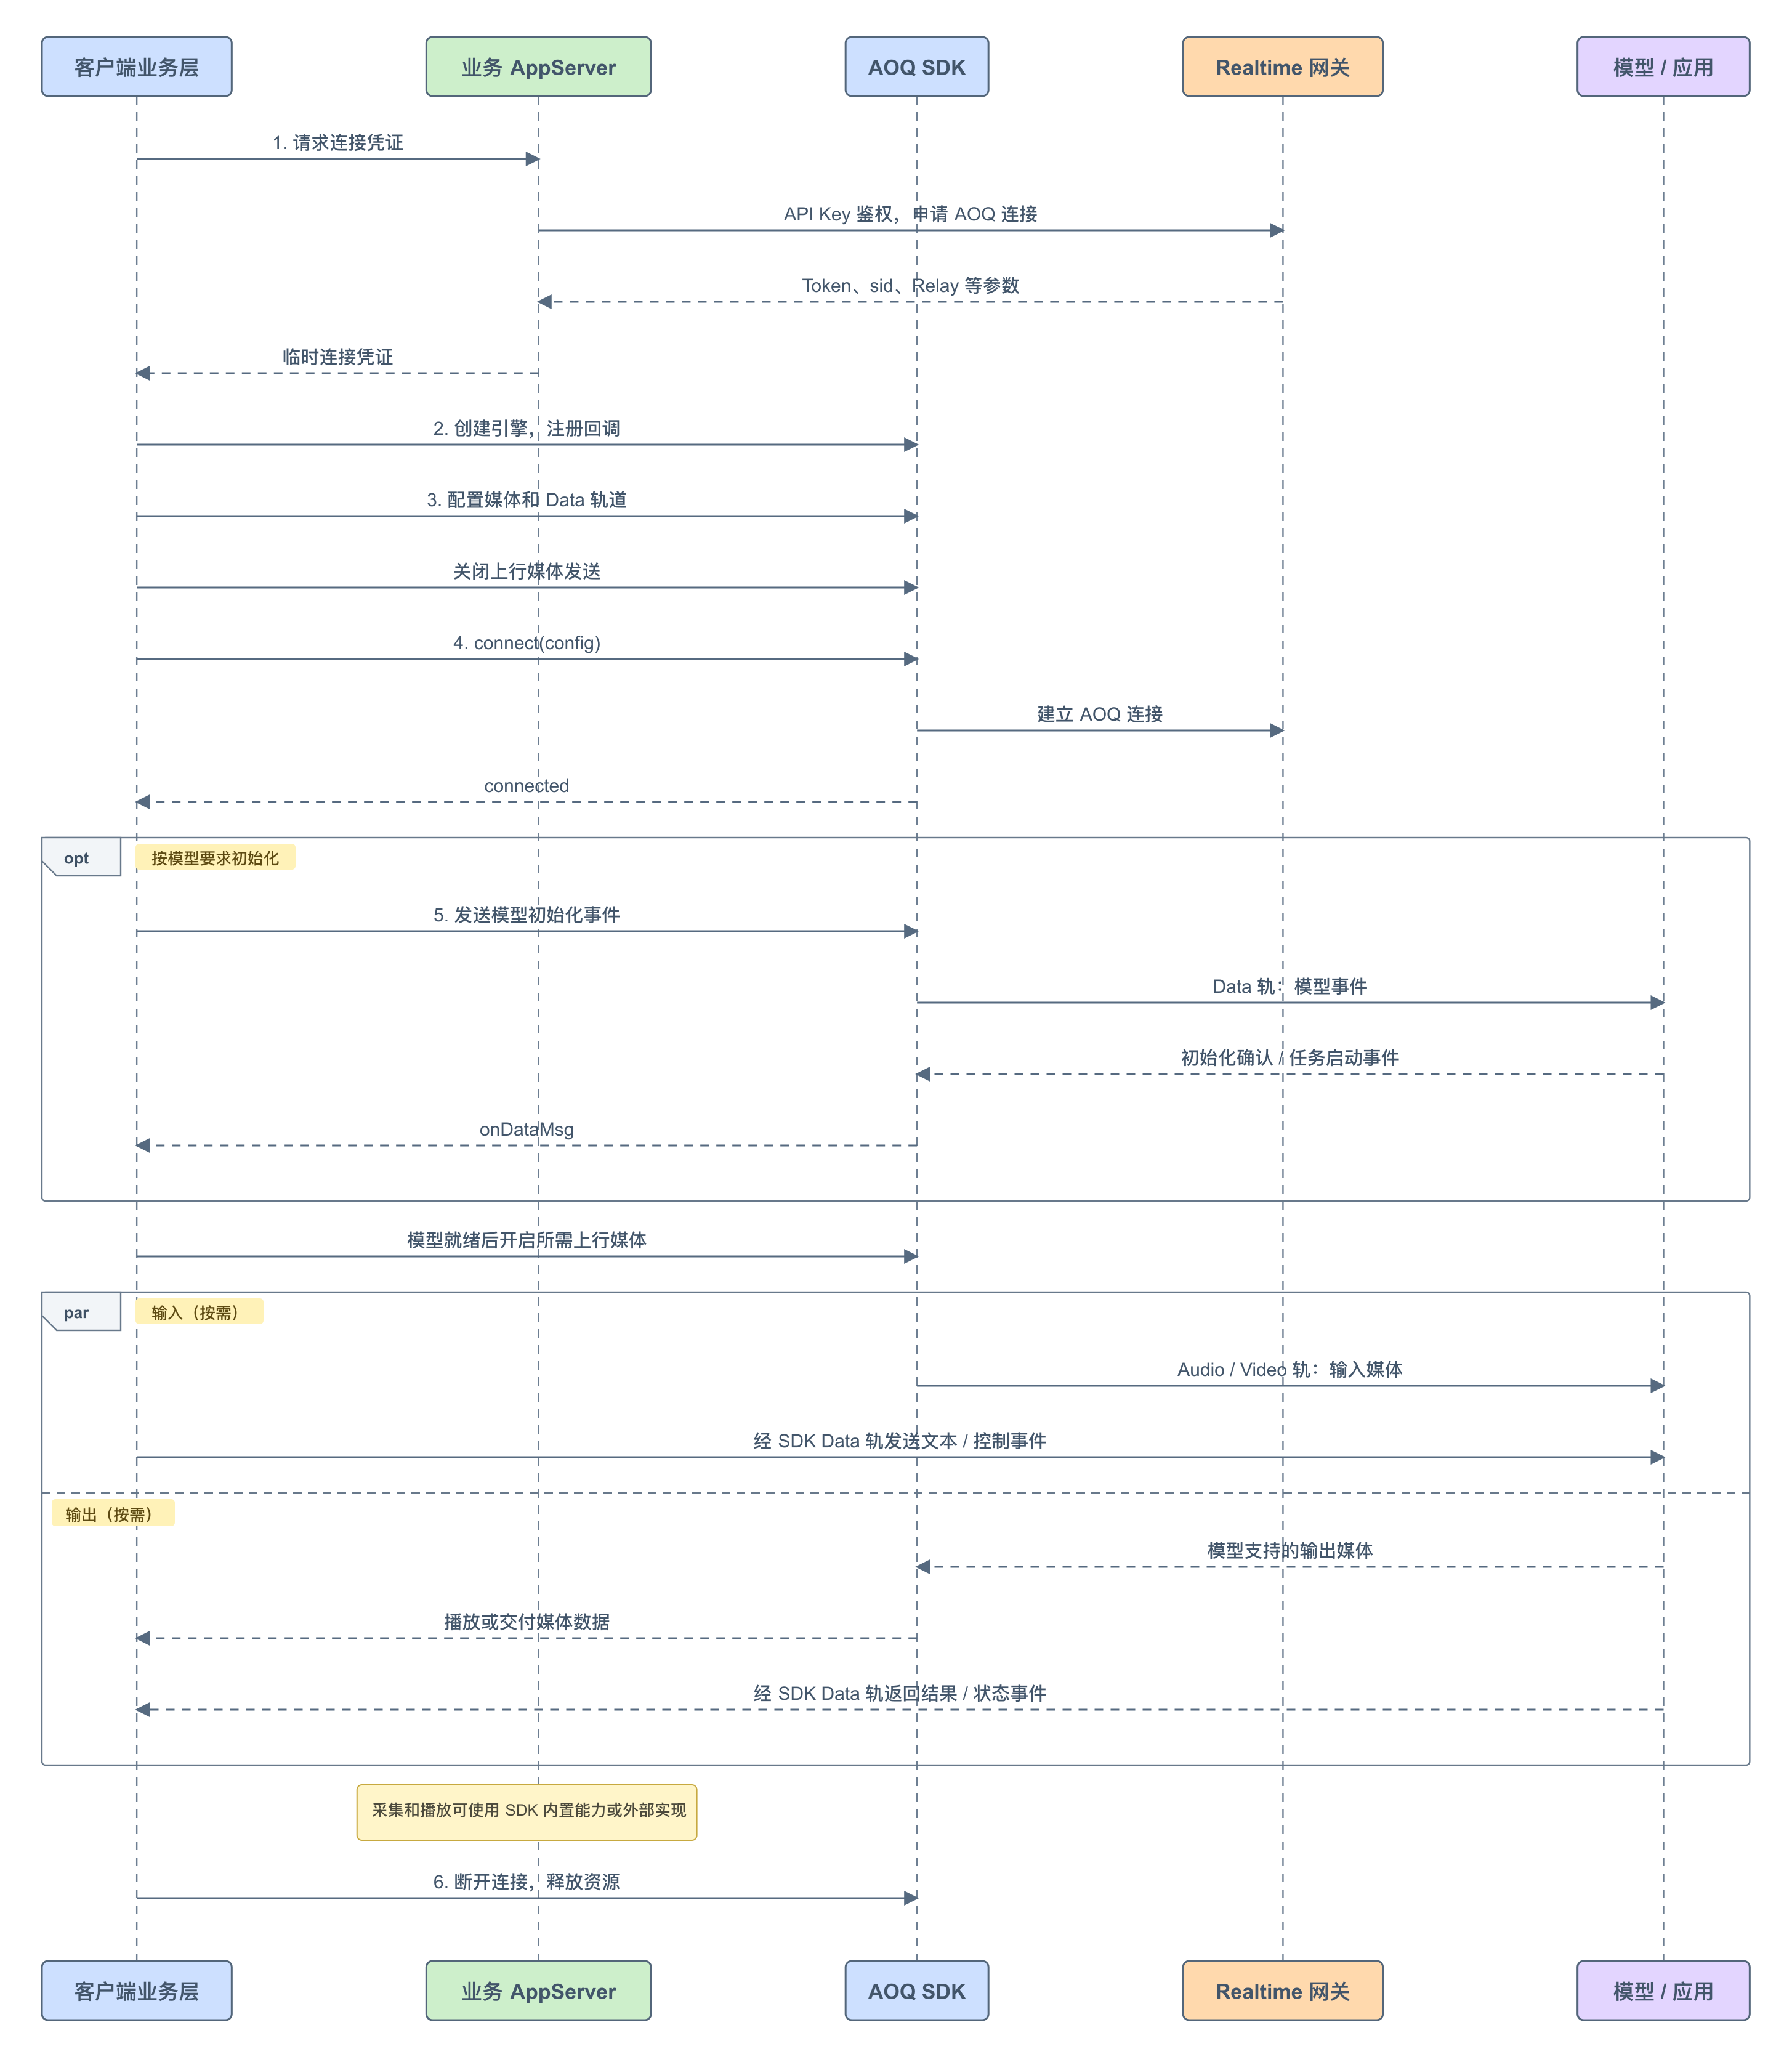
- 客户端通过业务 AppServer 获取连接凭证。
- 创建 SDK 引擎并注册回调。
- 配置媒体和 Data 轨道,关闭上行媒体发送。
- 建立 AOQ 连接,等待连接成功。
- 按模型协议完成配置,收到确认后开启所需媒体发送。
- 完成交互后断开连接并释放资源。
说明
-
音视频媒体数据由 AOQ SDK 接管,负责采集、处理、发送、接收和播放;Data 数据需要调用方遵循目标模型的事件定义进行发送和接收。
-
连接成功表示与模型的传输通道已建立。如果业务需要配置音色等前置操作,应先完成模型配置,再启动媒体发送。例如,Realtime 模型需要等待
session.updated,Inference 模型需要等待task-started。因此,客户端应在模型初始化成功后,才能开启所需的上行媒体。
1. 获取连接凭证
客户端向业务 AppServer 请求凭证。AppServer 根据目标模型选择 Realtime 或 Inference 建连地址,并携带 API Key 和 x-dashscope-rtc-transport: moq 请求网关。完整地址、请求和字段说明见 Token 鉴权。
将响应映射到 AoqConnectConfig:
| 网关响应 | SDK 配置 |
|---|---|
aoqTokenForClient | token |
sid | sid |
clientRelayCertFingerprint | certFingerprint |
clientRelayEndpoints | relayEndpoints,按结构转换各接入点 |
extraInfo.workspaceIdHash | workspaceIdHash |
新建连接时获取新的连接凭证。同一连接内能否复用会话或启动下一轮任务,由目标模型协议决定。
2. 初始化 SDK 并注册回调
创建引擎并注册连接状态、Data 消息和错误回调。以 iOS Swift 为例:
let createConfig = AoqCreateConfig()
createConfig.workDir = workDir
createConfig.enableDumpAudio = false
engine = AoqClientEngine.createEngine(createConfig, delegate: self)
实现 AoqEngineDelegate,在 onConnectionStatusChange 中维护连接状态,在 onDataMsg 中解析目标模型事件,在 onError 中处理 SDK 错误。模型返回的错误事件也需要在 Data 消息处理逻辑中单独处理。SDK 接口及错误说明请参见 AOQ 客户端 SDK。
3. 配置 SDK
选择四个媒体方向
以下“推”和“拉”均以客户端为视角。按业务实际使用的输入、输出模态配置,不需要的方向不添加媒体轨道。
| 方向 | 配置内容 | 典型用途 |
|---|---|---|
| 推音频 | 发布 Audio 轨,设置音频编码器,配置内置或外部采集 | 语音识别、语音对话、语音翻译 |
| 拉音频 | 订阅 Audio 轨,设置音频解码器,配置播放器或外部播放 | 语音合成、语音回复 |
| 推视频 | 发布 Video 轨,配置摄像头或外部视频输入及编码参数 | 向支持视觉输入的模型发送画面 |
| 拉视频 | 仅当目标模型/应用明确支持视频输出时配置订阅及接收处理 | 以目标模型/应用文档为准 |
Data 轨独立于这四个方向:发布 Data 轨用于发送模型事件,订阅 Data 轨用于接收回复。纯文本输入或输出也需要 Data 轨。
各模型如何选择
下表是典型场景的媒体配置建议。具体模型及版本的支持范围以 Realtime API 概述和模型文档为准。
| 模型/应用 | 推音频 | 拉音频 | 推视频 | 拉视频 |
|---|---|---|---|---|
| Qwen-Omni-Realtime | 语音输入时开启 | 需要语音回复时开启 | 需要视觉输入时开启 | 不支持开启 |
| Qwen-Audio-Realtime | 语音对话时开启 | 需要语音回复时开启 | 不支持开启 | 不支持开启 |
| Qwen-Audio-TTS、CosyVoice | 不支持开启 | 开启 | 不支持开启 | 不支持开启 |
| Qwen-Audio-ASR-Flash-Streaming、Fun-ASR-Realtime | 开启 | 不支持开启 | 不支持开启 | 不支持开启 |
| Qwen-LiveTranslate-Realtime | 语音输入时开启 | 需要语音译文时开启 | 按所选版本及场景配置 | 不支持开启 |
| multimodal-dialog | 按应用输入配置 | 按应用输出配置 | 按应用能力配置 | 仅在应用明确支持时配置 |
配置媒体参数和轨道
音频上行和下行应分别配置:上行使用 setAudioEncoderConfig,下行使用 setAudioDecoderConfig。这些参数用于网络传输,网关会将音频转换为模型所需的格式。传输编码配置与模型事件中的音频格式参数应分别按 SDK 和目标模型的要求设置。
按方向启动 startAudioCapture、startAudioPlayer 或 startVideoCapture。自定义输入输出见下文高阶能力。
publishTracks 表示客户端发送的轨道,subscribeTracks 表示客户端接收的轨道:
| 场景 | publishTracks | subscribeTracks |
|---|---|---|
| 语音对话 | Audio、Data | Audio、Data |
| 带画面输入的语音对话 | Audio、Video、Data | Audio、Data |
| 语音识别 | Audio、Data | Data |
| 语音合成 | Data | Audio、Data |
在建连前关闭上行媒体发送,避免模型尚未就绪时收到输入:
engine.enableSendMediaStream(.audio, enable: false)
engine.enableSendMediaStream(.video, enable: false)
采集、发布轨道和允许发送是不同的操作。关闭发送不等于停止本地采集,也不影响 Data 轨事件收发。未添加的轨道不会因开启发送而自动创建。
4. 建立连接
将凭证与轨道配置填入 AoqConnectConfig,调用:
engine.connect(connectConfig)
等待 onConnectionStatusChange 返回 .connected,再进入模型初始化流程。connect 调用返回不等于连接成功。
5. 按模型协议交互并收发媒体
发送和解析模型事件
客户端通过 Data 轨发送事件。iOS Swift 示例:
// eventJSON 由目标模型的客户端事件协议构造。
let msg = AoqDataMsg()
msg.data = eventJSON.data(using: .utf8)!
engine.send(msg)
在 onDataMsg 中解析回复。不要统一假定事件类型位于 type:Realtime 事件通常使用 type,Inference 服务端事件使用 header.event。完整字段、参数及结束条件应遵循目标模型文档。
就绪后开启所需媒体
满足当前模型、当前会话或任务的就绪条件后,仅开启已配置的上行方向。例如,需要语音输入时调用:
engine.enableSendMediaStream(.audio, enable: true)
需要视频输入时再开启 .video。TTS 场景输入文本,无需开启上行音视频。
音视频通过对应媒体轨道传输;模型事件和文本通过 Data 轨传输。例如,Omni 的 AOQ 接入无需使用 input_audio_buffer.append 或 input_image_buffer.append 重复发送媒体。下行音频由已配置的播放器或外部播放逻辑处理。
6. 结束交互并释放资源
不再使用连接时,由客户端业务层调用AOQ SDK 的断开连接和释放资源接口:
engine.disconnect()
AoqClientEngine.destroy()
异常断开后清理业务层就绪状态,按连接状态管理处理后续连接;重新建连后按模型协议重新初始化。
Data 通道发送和接收事件
客户端通过AOQ SDK 的 Data 轨发送和接收模型事件。连接时需要发布和订阅 Data 轨;发送时将模型事件序列化后放入 AoqDataMsg,调用 engine.send(msg);接收时在 onDataMsg 回调中解析消息。
发送事件的名称、字段、参数和调用时机遵循目标模型的客户端事件定义;收到消息后的解析方式、状态变更、结果和错误处理遵循该模型的服务端事件定义。初始化事件根据模型要求按需发送,后续文本和控制事件按照业务需要发送。
| 模型/应用 | 客户端事件定义(发送) | 服务端事件定义(接收) |
|---|---|---|
| Qwen-Omni-Realtime | 客户端事件 | 服务端事件 |
| Qwen-Audio-Realtime | 客户端事件 | 服务端事件 |
| Qwen-Audio-TTS、CosyVoice | 客户端事件 | 服务端事件 |
| Qwen-Audio-ASR-Flash-Streaming、Fun-ASR-Realtime | 客户端事件 | 服务端事件 |
| Qwen-LiveTranslate-Realtime | 客户端事件 | 服务端事件 |
| multimodal-dialog | 交互协议中的 Input Message | 交互协议中的 Output Message |
多模态交互套件的双向事件定义在同一篇交互协议中。请按实际接入的模型版本选择事件定义,不同模型之间不共用一套固定事件。
模型事件的发送与接收还应遵循以下规则:
-
按模型定义识别事件类型和关联标识。例如,Realtime 事件通常使用
type;Inference 客户端使用header.action、服务端使用header.event,通过task_id关联任务。 -
模型要求的初始化确认、输入提交、响应取消和任务结束等操作,均在 Data 通道中按对应协议处理;它们属于模型交互语义,与断开传输连接是不同操作。
-
例如,Inference 模型使用
finish-task结束任务,并通过task-finished确认任务结束;如需完整结果,应在收到剩余结果后再释放连接,需要完整播放时还应处理完本地待播音频。 -
音视频数据通过媒体轨道传输。引用模型事件文档时,媒体封装和可用交互模式仍遵循本文的接入方式,不直接套用 WebSocket 的媒体发送方式。
高阶能力
| 能力 | 使用场景 | 文档 |
|---|---|---|
| 独立控制音视频发送 | 等待模型就绪、暂停上行、按需开启视频 | 媒体流发送管理 |
| 音频设备与处理 | 编解码、扬声器、文件混音、音频帧回调 | 音频常用功能 |
| 外部音频输入 | 使用业务侧音频源 | 自定义音频采集 |
| 外部音频输出 | 由业务侧处理或播放输出音频 | 自定义音频播放 |
| 视频采集与输入 | 摄像头及业务侧画面输入 | 视频常用功能、自定义视频输入 |
媒体发送控制只控制媒体传输。模型响应取消、轮次提交等行为仍需使用目标模型的事件协议。
最佳实践
-
Omni 实时通话:音视频输入、语音回复和会话事件。
-
Omni 按键语音对话:按键控制输入及手动轮次。
-
Qwen-Audio 实时语音对话:双向音频交互。
-
Qwen-Audio 语音合成:Data 轨输入文本,Audio 轨输出语音。
-
Fun-ASR 实时语音识别:Audio 轨输入语音,Data 轨输出识别结果。