
PolarDB Agent LakeBase是为AI Agent规模化运行而设计的Workspace基础设施,为海量Agent提供持久化工作空间。每个Agent拥有完全隔离的文件系统视图,统一承载其运行期间的各类数据资产。基于云原生共享底座架构,支持百万级Agent即起即停,并提供秒级快照、秒级挂载恢复与生命周期管理等Agent Native的工作空间管理能力。产品可对接云服务器ECS、容器服务Kubernetes版ACK、函数计算(FC)等多种计算形态,并联动外部数据分析生态。
如需使用或您对PolarDB Agent LakeBase功能有任何问题,可通过钉钉搜索群号入群咨询。您可以直接@群内专家,并附上您要咨询的问题。
钉钉群号:28000021116
产品定位
在AI Agent的运行架构中,基础设施可以划分为以下几个部分:
LLM作为CPU,负责推理与决策。
MCP等各类Tool作为外设,连接外部工具。
Context Window作为内存,承载当前会话的临时工作区。
Workspace则作为Agent的持久化工作空间,像硬盘一样承载Agent的各类持久化状态与数据。
随着AI Agent逐步走向规模化,Agent对Workspace提出了全新要求,传统存储基础设施已难以满足Agent在海量接入、弹性支撑、安全隔离、轻量化部署以及各类Agent原生能力等方面的需求。
PolarDB Agent LakeBase面向AI Agent规模化运行而打造,为海量Agent提供持久化工作空间。每个Agent拥有完全隔离的工作空间视图,统一承载其工作过程中使用与产生的各类数据,在支撑海量活跃Agent稳定接入的同时,确保Agent数据资产的安全可控。产品核心能力包括:
Agent Native的独立视图支持:每个Agent看到一个完整、独立的工作空间文件视图,承载Agent运行期间使用与产生的各类文件数据,契合LLM以文件为原生交互界面的范式趋势。工作空间视图相互独立,满足Agent的隔离要求。
Agent Native的接入能力:POSIX与S3双协议兼容,既支持云服务器ECS、容器服务Kubernetes版ACK、容器计算服务(ACS)Sandbox、函数计算(FC)Sandbox等多种云上计算形态接入,也支持IDC内各类自建系统接入,实现云端一体。
Agent Native的弹性支撑:百万级Agent即起即停,基于对象存储构建的完全弹性的存储空间,从容应对Agent数量突变与数据爆发。
Agent Native的工作空间管理能力:支持秒级快照、秒级挂载恢复、工作空间粒度的生命周期管理、配额管理、流量控制、文件级权限控制等功能,完整覆盖Agent工作空间从创建、版本管理到休眠唤起的全生命周期需求。
Agent Native的生态支撑:支持直接运行SQLite、LanceDB、DuckDB等各类嵌入式数据处理组件,满足Agent的各种数据处理需求。同时支持联动外部企业级数据处理与分析系统,数据可直接交付PolarDB生态组件进行清洗、检索、分析等操作。
产品架构
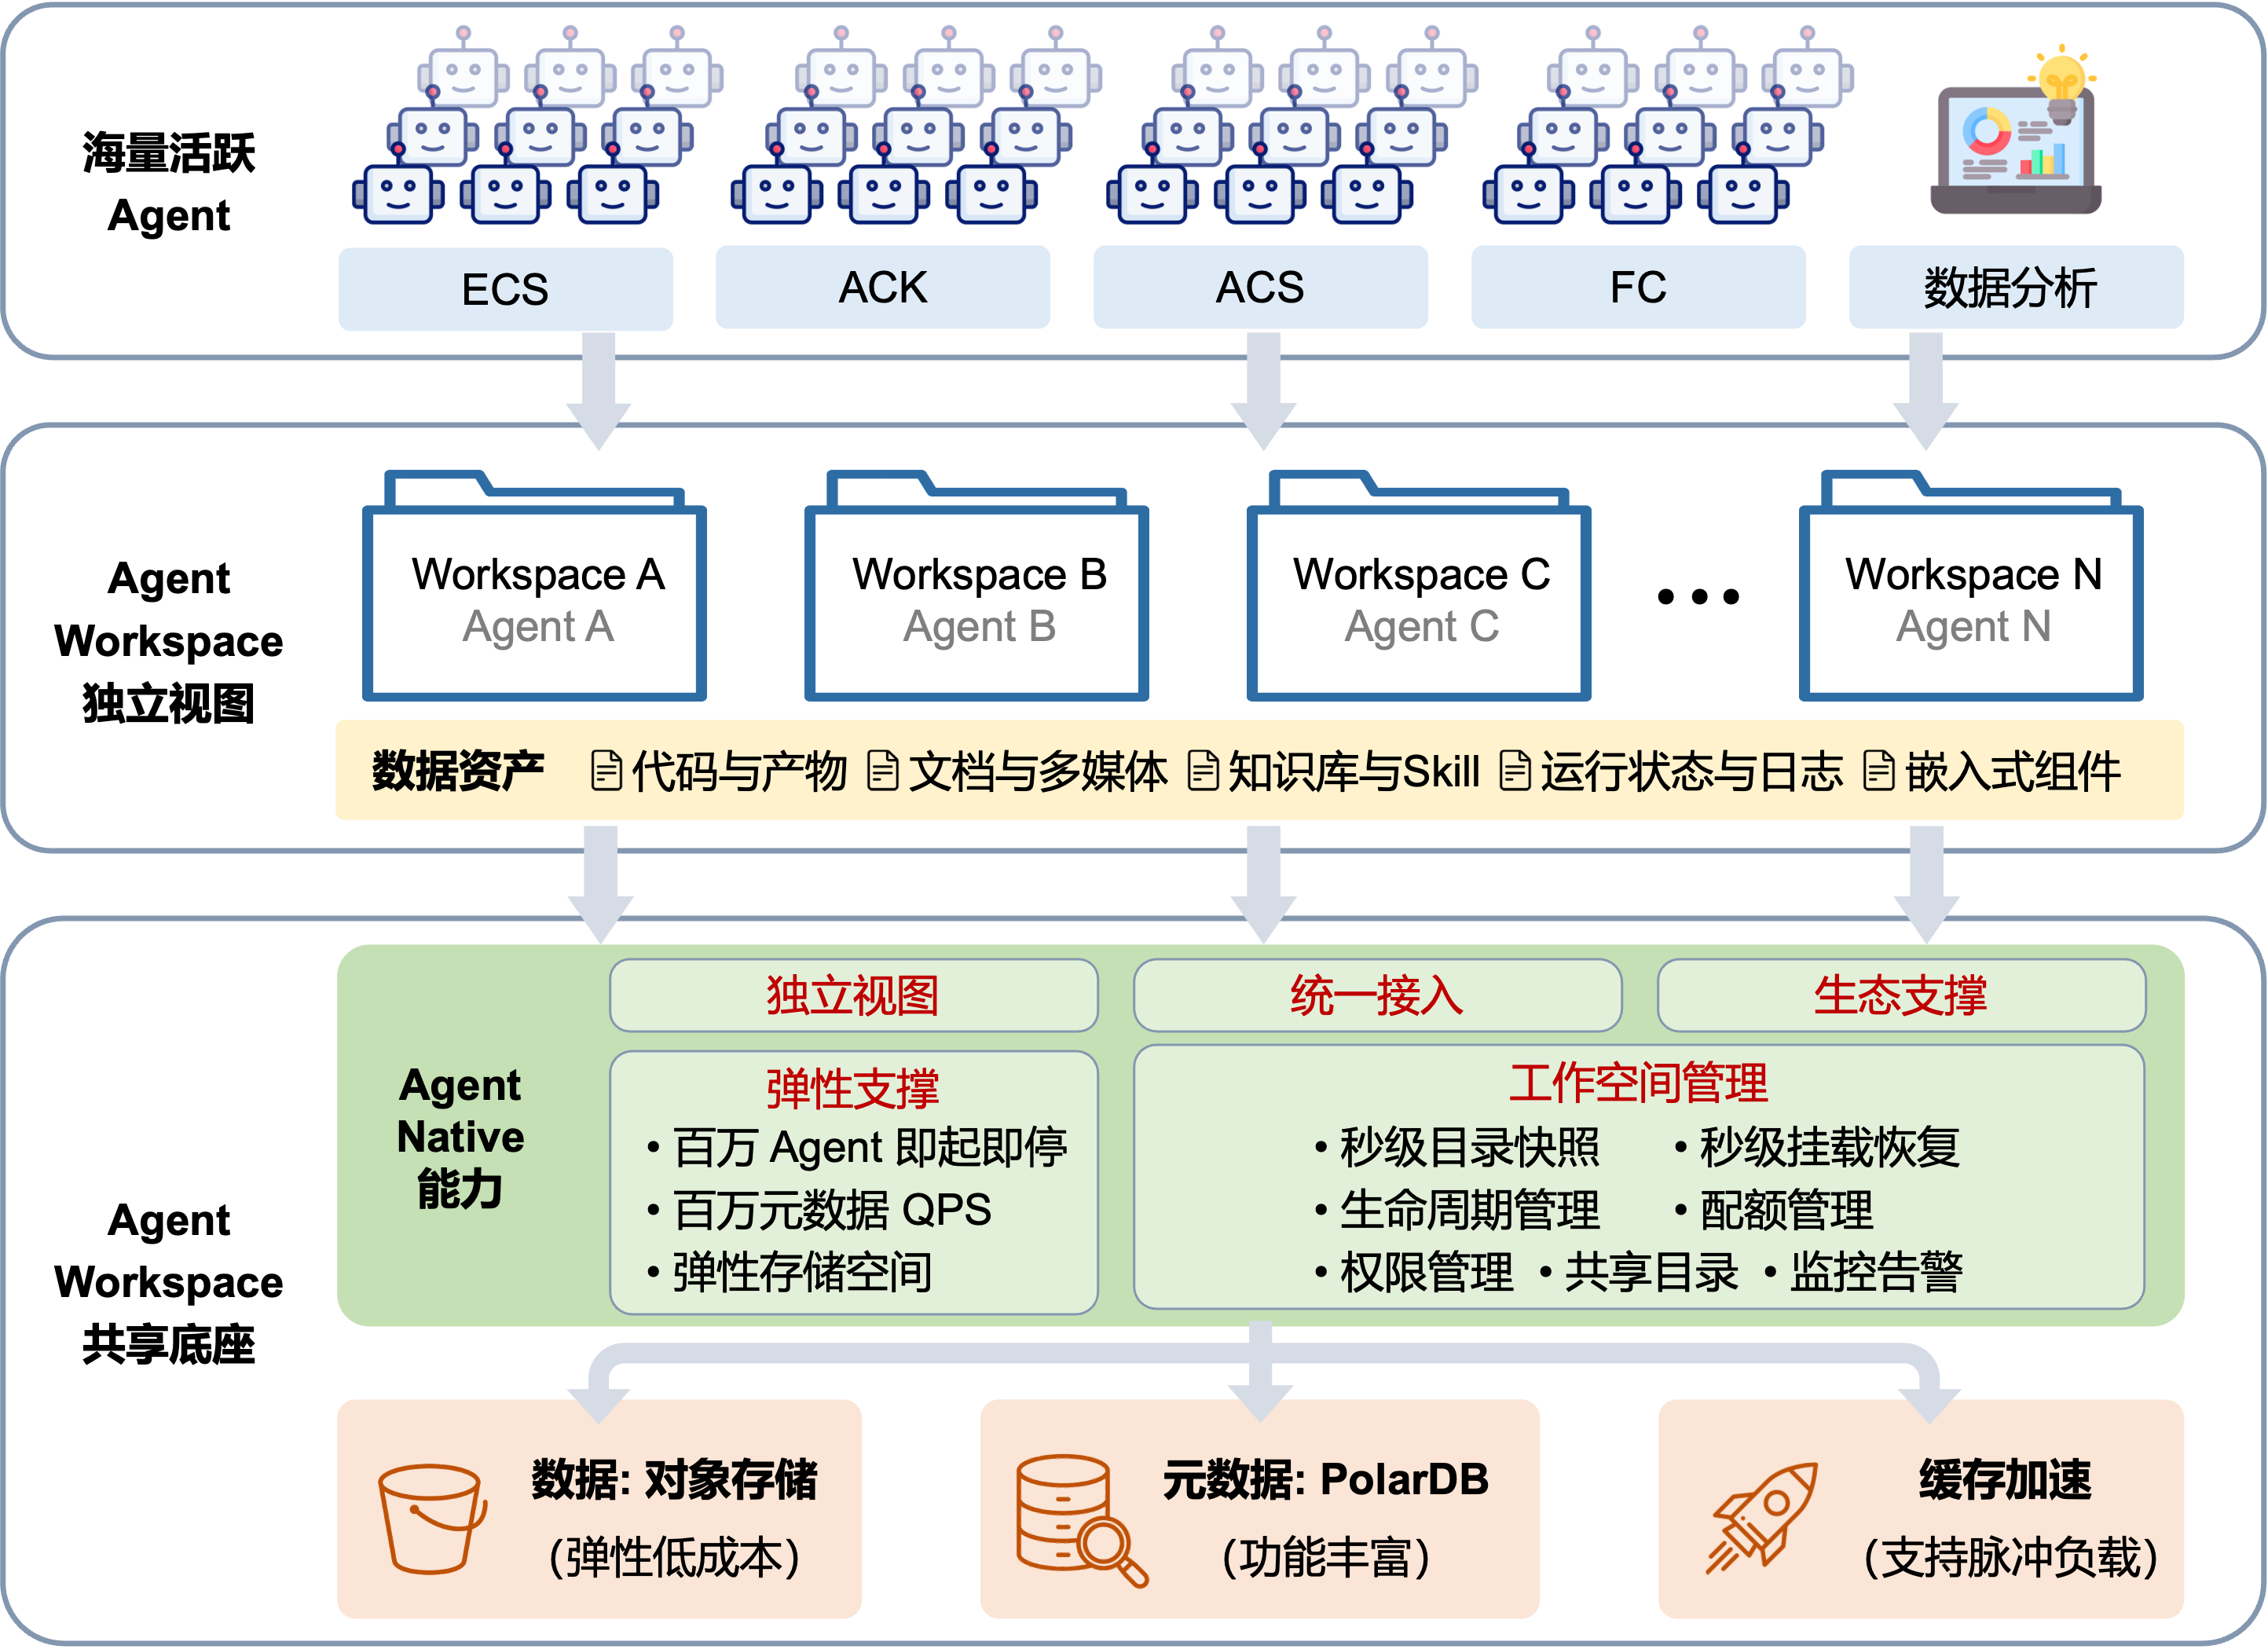
PolarDB Agent LakeBase的整体架构如上图所示,主要由以下三层构成:
海量活跃Agent:Workspace存储与Agent计算完全解耦,支持云服务器ECS、容器服务Kubernetes版ACK、容器计算服务(ACS)Sandbox、函数计算(FC)Sandbox等多种计算形态接入,支撑百万级Agent同时在线。
Agent Workspace独立视图:每个Agent看到一个完整、独立的工作空间视图,可以读写文件、组织目录,使用方式与本地文件系统一致。Workspace中可存放Agent运行过程中产生与使用的各类数据,典型包括:
代码与产物:源码、脚本、应用文件、网站Demo等。
文档与多模态数据:文本、Markdown、PDF、演示稿、设计文档、图片、视频、音频等。
知识库与Skill:参考文档集、RAG语料、共享文档、Agent能力定义、Prompt模板等。
运行状态与日志:状态快照、会话历史、临时文件、执行日志等。
各类数据组件:Agent在工作空间内就地读写的嵌入式数据库(如SQLite、DuckDB、LanceDB)、列式数据集(如Lance、Parquet)、包管理依赖目录(如node_modules、Python site-packages)等。
Agent Workspace共享底座:所有Agent的工作空间数据由一套云原生共享底座统一承载,由三层组件构成:
元数据库:基于PolarDB提供高性能元数据服务,支撑海量小文件。PolarDB的事务能力、连接池、高并发与丰富索引机制,是海量连接、快照、配额、生命周期等高级能力的支撑基础。
数据存储:基于弹性低成本的对象存储,按实际使用容量计费。
缓存加速:针对Agent场景的访问模式优化,热点数据缓存在靠近计算节点的位置,显著降低读取延迟。
核心能力
Agent Native的独立视图支持
为每个Agent提供独立的命名空间,保证访问隔离:
每个Agent独立根目录:每个Agent看到一个完整的文件系统视图,可以像在本地文件系统一样读写文件、组织目录,实现Agent代码在本地与云上的无缝迁移。
Agent之间命名空间隔离:不同Agent的文件、目录、数据库相互不可见,杜绝跨Agent数据泄露,满足多租户、多Agent场景下的数据安全要求。
Agent Native的接入能力
为Agent多样化的运行形态提供统一的接入方式:
兼容POSIX协议:PolarDB Agent LakeBase通过FUSE提供标准文件系统接口,契合LLM基于文件原语进行读写的架构趋势,满足嵌入式数据库、列式数据集、包管理工具等组件对文件锁、原子重命名操作、符号链接等语义的要求。
兼容S3协议:同一份数据既可以通过POSIX文件接口被Agent进程直接读写,也可以通过S3对象接口被外部应用访问。Agent产生的网站、报告等产物无需数据迁移即可对外提供服务。
支持多种计算形态接入:原生支持云服务器ECS、容器服务Kubernetes版ACK、容器计算服务(ACS)Sandbox、函数计算(FC)Sandbox等多种云上计算形态接入,同时支持IDC内各类自建系统接入。
Agent Native的弹性支撑
应对百万级Agent即起即停、Agent数量突变与数据爆发的负载特征:
百万级Agent即起即停:支撑海量Agent同时接入,覆盖大规模Agent集群同时在线的场景。
百万级元数据QPS:基于PolarDB的元数据服务,支持高并发的文件查找、目录列举与权限校验,支撑百万级元数据QPS,避免大规模Agent场景下元数据成为性能瓶颈。
弹性存储空间:基于对象存储的完全弹性的存储空间,按实际使用量计费,无需为容量预留付费。Agent计算资源释放后,仅保留实际数据的存储成本。
缓存加速:热点数据缓存在靠近计算节点的位置,显著降低读取延迟,支撑大规模并行读取。
Agent Native的工作空间管理
覆盖Agent工作空间从启动、版本管理到深度睡眠唤起的完整生命周期:
秒级目录快照:支持目录粒度的快照能力,秒级完成创建,适用于Agent工作空间版本管理、模板克隆、状态回滚等场景。基于元数据级实现,新Workspace可基于已有模板秒级初始化,仅复制元数据无需拷贝实际数据,大幅降低初始化延迟与存储开销。
秒级挂载恢复:基于元数据服务与连接池技术,新Agent进程可秒级完成挂载与就绪。经过深度睡眠的Agent,在计算就绪后,其工作空间可在亚秒级内完整恢复,满足Agent频繁启动与切换的体验要求。
配额管理:支持容量与IO性能双维度配额,可在目录级灵活配置,确保多租户场景下的服务质量。
权限控制:支持文件级权限管理和ACL,以及租户级别的访问策略。
工作空间粒度的生命周期管理:支持目录级TTL配置,可按策略将冷数据自动归档到低成本存储或清理过期数据,让Agent工作空间的数据治理无需人工介入。
共享目录:支持跨Agent共享指定目录,用于沉淀团队级或租户级的共用知识库、Skill资产与公共模板。
监控告警:提供细粒度的访问监控、容量趋势、性能指标与异常告警。
Agent Native的生态支撑
支持在工作空间内就地运行各类数据处理组件,并与外部企业级数据处理和分析系统无缝接入:
直接运行嵌入式数据组件:支持SQLite、LanceDB、DuckDB等嵌入式数据处理组件就地读写,承载Agent的应用数据库、向量索引、列式分析等典型数据处理需求。
联动外部数据处理和分析生态:工作空间数据可直接交付PolarDB系列产品进行清洗、检索、分析等企业级数据处理。
典型应用场景
Agent任务执行平台
Agent平台为终端客户提供“自然语言驱动的任务自动化”服务,例如帮助您完成报告生成、数据分析、网站搭建等端到端任务。这类场景的特征是:
海量客户同时驱动Agent工作,每个Agent任务需要独立的数据空间存放中间文件与最终产物(图片、视频、文档等多模态内容)。
任务轮次与对话粒度较多,对数据版本管理要求高。
闲置Agent数量大,对成本敏感。
PolarDB Agent LakeBase通过支持百万级Agent同时在线、秒级目录快照、弹性容量与按量计费,能够支撑这类高并发、长尾型的Agent任务执行平台。
Agent建站与应用部署
Agent帮助客户生成完整可上线的网站或应用,并由平台持续托管运行。这类场景的特征是:
Agent生成的网站需要持续在线服务,对接后端数据库与静态资源。
同时面临大量长尾流量与脉冲式访问,需要灵活的资源弹性Agent经过深度睡眠后需要快速唤起,对挂载恢复延迟敏感。
PolarDB Agent LakeBase通过POSIX和S3协议支持网站后端进程直接读写工作空间数据。多级缓存保证用户请求的低延迟响应。亚秒级挂载恢复能力支持Agent从深度休眠中快速唤起。
Agent工作空间快速初始化
新Agent上线时需要快速准备工作环境,包括克隆项目模板、加载Skill文件、初始化知识库、预安装依赖包等。这类场景的特征是:
新Agent频繁创建与销毁,工作空间初始化的延迟直接影响体验。
模板数据可能很大,重复拷贝成本高。
多Agent需要复用预热的计算资源以缩短启动时间。
PolarDB Agent LakeBase通过目录快照能力支持新Agent工作空间基于模板秒级初始化,仅复制元数据无需拷贝实际数据。
Agent数据资产的分析与训练
Agent在工作过程中产生的海量数据(任务轨迹、产物、交互记录、多模态素材等)本身具有分析与训练价值,可用于业务洞察、模型微调、Skill优化等下游用途。这类场景的特征是:
分析与训练任务通常运行在GPU集群上,对数据并行读取的吞吐要求高。
分析任务与Agent在线业务共享同一份原始数据。
数据规模随Agent业务增长而持续累积,传统“导出—迁移—再加载”的方式成本高、链路长。
PolarDB Agent LakeBase可直接挂载到GPU集群,让分析与训练任务直接读取Agent原始数据,无需任何数据搬运。底座的缓存加速设计可支撑大规模并行读取。按量计费的弹性容量让长期累积的历史数据保留在低成本存储中,需要时按需访问。
产品优势
为Agent场景原生设计
PolarDB Agent LakeBase从Agent场景的真实诉求出发设计:海量活跃Agent同时接入、脉冲式负载、对话粒度的版本管理、与Agent运行时的紧密集成。核心能力对应Agent场景的真实痛点,而非传统文件系统能力的简单延伸。
成本随业务弹性而非Agent数量增长
通过Per-Agent独立视图与共享底座的架构解耦,Agent数量的增长不再线性传导到基础设施成本。相同规模的Agent业务,部署成本相比“每Agent一套独立实例”的方案可大幅下降。空闲时低成本,高峰时无需手动扩容。
一份数据、多种使用方式
POSIX协议面向Agent进程读写,S3协议面向应用与外部系统访问。Agent产生的数据既能被Agent自身处理,也能直接对外服务,还可以用于数据分析与训练,无需冗余存储或繁琐的数据搬运。
与PolarDB Agent生态深度集成
PolarDB Agent LakeBase与PolarDB数据库以及其他PolarDB Agent系列产品原生协同,构成完整的Agent数据基础设施。
计费说明
PolarDB Agent LakeBase采用按量付费模式,根据实际使用的资源按小时计费。计费项包括元数据库存储、元数据库计算资源(PCU)、加速空间和冷数据存储,各计费项独立计量。
冷数据存储仅在创建时选择了冷数据+加速空间存储类型时才会产生。如果选择加速空间(不含冷存储),则不会产生冷数据存储费用。
PCU作为PolarDB Agent LakeBase元数据库计算资源的管理单位,1PCU约等于1核2 GB内存的标准服务能力。
地域 | 元数据库存储(元/GB/小时) | 元数据库计算资源(元/PCU/小时) | 加速空间(元/GB/小时) | 冷数据存储(元/GB/小时) |
中国内地 | 0.00486 | 0.4 | 0.00104 | 0.00021 |
中国香港 | 0.00542 | 0.76 | 0.001042 | 0.000294 |
新加坡 | 0.00542 | 0.76 | 0.001979 | 0.000294 |
日本(东京) | 0.00542 | 0.64 | 0.0016672 | 0.000294 |
韩国(首尔) | 0.00542 | 0.64 | 0.0017 | 0.000294 |
印度尼西亚(雅加达) | 0.00542 | 0.7 | 0.001823 | 0.000294 |
德国(法兰克福) | 0.00542 | 0.68 | 0.0017714 | 0.000294 |
美国(硅谷) | 0.00542 | 0.62 | 0.0017714 | 0.000294 |
美国(弗吉尼亚) | 0.00542 | 0.52 | 0.0017714 | 0.000294 |