
Designer使用工作流构建模型。您先创建一个工作流,再按建模需求在工作流中排布各组件的处理调度逻辑。以下以创建空白工作流、构建二分类模型预测心脏疾病为例,带您完成从0~1的可视化模型构建和部署。
前提条件
已开通PAI并创建工作空间,详情请参见开通并创建默认工作空间。
工作空间已关联MaxCompute资源,详情请参见快速入门-准备工作。
步骤一:新建工作流
前往可视化建模(Designer),选择工作空间并进入Designer页面。单击页面右上方的新建工作流,在弹出的对话框中输入工作流名称后单击确定,即可创建空白工作流并进入编辑页面。
|
参数 |
说明 |
|
工作流名称 |
自定义名称。 |
|
工作流数据存储 |
建议您将该参数配置为OSS Bucket存储路径,用于存储运行中产出的临时数据和模型。若不设置,则使用工作空间的默认存储。 系统会在每次运行时自动创建 |
|
可见范围 |
|
步骤二:数据准备与预处理
构建模型前,您需要准备数据源并完成数据预处理,以便后续按业务需求训练模型。
准备数据
在工作流中添加源/目标类型组件即可读取数据,支持MaxCompute、OSS等数据源,详情可参见组件参考:源/目标下的具体组件文档。以下示例直接使用读数据表组件读取PAI提供的心脏病案例公开数据,数据集详情请参见Heart Disease Data Set。
选择合适的源/目标组件读取数据。
在左侧组件列表中,单击源/目标,将读数据表组件拖入右侧画布,用于读取MaxCompute表数据。画布中会自动生成名称为读数据表-1的工作流节点。
在节点配置页面配置源数据表名。
在画布中选中读数据表-1节点,在右侧节点配置页面的表名中填写要读取的MaxCompute表名。以下示例填写为
pai_online_project.heart_disease_prediction,即PAI提供的心脏病案例公开数据表。将右侧节点配置页面切换到字段信息页签,查看该公开数据的字段详情,确认各字段的名称和类型,为后续数据预处理做准备。
数据预处理
心脏病预测示例属于二分类问题。本示例使用的逻辑回归模型组件要求输入数据为DOUBLE(或BIGINT)类型,因此需要完成数据类型转换等预处理,为模型训练做准备。
数据预处理:将非数值类型字段转换为数值类型。
搜索SQL脚本组件并拖入画布,画布中会生成名称为SQL脚本-1的工作流节点。
将读数据表-1节点连线到SQL脚本-1节点的t1输入源。
配置节点。
单击SQL脚本-1节点,在右侧配置页面输入以下代码。此时右侧参数设置面板的输入源为t1,对应上一步连线的上游节点。
select age, (case sex when 'male' then 1 else 0 end) as sex, (case cp when 'angina' then 0 when 'notang' then 1 else 2 end) as cp, trestbps, chol, (case fbs when 'true' then 1 else 0 end) as fbs, (case restecg when 'norm' then 0 when 'abn' then 1 else 2 end) as restecg, thalach, (case exang when 'true' then 1 else 0 end) as exang, oldpeak, (case slop when 'up' then 0 when 'flat' then 1 else 2 end) as slop, ca, (case thal when 'norm' then 0 when 'fix' then 1 else 2 end) as thal, (case status when 'sick' then 1 else 0 end) as ifHealth from ${t1};单击画布左上方的保存,保存工作流配置。
右键单击SQL脚本-1组件,单击从根节点执行到此处,调试运行本工作流。该操作只运行当前节点及其上游节点,便于快速定位问题。
工作流按节点顺序依次运行各节点。节点运行成功后,节点右上角会显示
 。说明
您也可以单击画布左上方的
 (运行)图标,直接运行整个工作流。工作流较复杂时,建议分模块运行某个节点或部分节点,方便调试。运行失败时,右键单击对应节点,选择查看日志排查失败原因。
运行成功后,右键单击目标节点(例如SQL脚本-1),选择,确认当前节点的输出数据是否正确。
数据预处理:将字段转换为DOUBLE类型,使字段满足逻辑回归模型的输入要求。
参考上一步,拖入类型转换组件并连线,使其作为SQL脚本-1节点的下游节点。单击该节点,在字段设置页签单击转换为double类型的列下的选择字段,全选所有字段并转换为DOUBLE类型。
数据预处理:归一化处理,将每个特征的数值范围转换为0~1,去除量纲对结果的影响。
参考上一步,拖入归一化组件并连线,使其作为类型转换-1节点的下游节点。单击该节点,在字段设置页签选择所有字段。
数据预处理:将数据拆分为训练集和预测集,为后续模型训练和预测做准备。
拖入拆分组件并连线,使其作为归一化-1节点的下游节点。该组件会输出2个数据表。
拆分组件默认按4:1将数据拆分为模型训练集和模型预测集。您可以单击拆分组件,在右侧参数设置页签设置切分比例,其他参数详情请参见拆分。
右键单击类型转换-1组件,单击从此处开始执行,运行工作流中的剩余节点。
步骤三:模型训练
每个样本只会患病或健康,因此心脏病预测属于二分类问题。以下步骤使用逻辑回归二分类组件构建心脏病预测模型。
拖入逻辑回归二分类组件并连线,使其作为拆分-1节点输出表1的下游节点。
配置节点。
单击逻辑回归二分类-1节点,在右侧字段设置页签,将目标列设置为ifhealth,即模型要预测的健康标签;将训练特征列设置为除目标列以外的所有列,即用于训练模型的输入字段。更多参数请参见逻辑回归二分类。
说明如果您需要完成后续的步骤六:模型部署(可选),请选中逻辑回归二分类节点,在右侧字段设置页签勾选是否生成PMML复选框。未勾选则无法生成部署所需的模型文件。
运行该节点。
步骤四:模型预测
运行预测节点并查看预测结果。
运行成功后,右键单击预测节点,选择查看数据 > 预测结果输出,查看预测数据。
预测结果数据包含以下字段:ifhealth(实际健康标签,值为1.0或0.0)、prediction_result(预测结果)、prediction_score(预测置信度分数)和prediction_detail(各分类的预测概率,JSON格式)。
步骤五:模型评估
拖入二分类评估组件并连线,使其作为预测-1节点的下游节点。
单击二分类评估-1节点,在右侧字段设置页签,将原始标签列列名设置为ifhealth。
运行评估节点并查看模型评估结果。
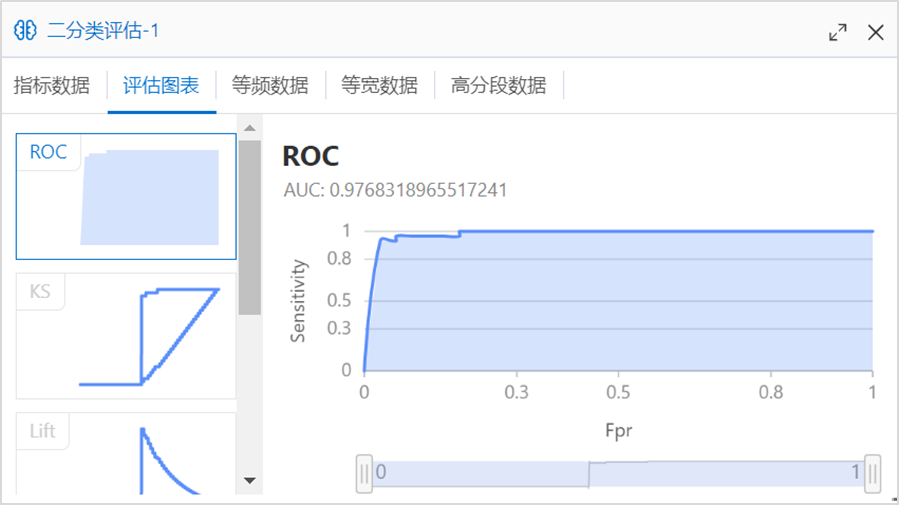
运行结束后,右键单击二分类评估组件,选择可视化分析,以图表方式查看各项评估指标数据。
步骤六:模型部署(可选)
Designer和EAS已在使用链路上无缝对接。完成离线训练、离线预测和评估后,您可以将单个模型部署至EAS,创建在线模型服务。
工作流运行成功后,单击模型列表,选择要部署的模型,单击部署至EAS。
确认配置参数,详情请参见单模型部署在线服务。
在EAS部署页面,模型文件和Processor种类已默认配置完成,其他参数请根据实际需要配置。
单击部署。
当服务状态从创建中变为运行中时,表示模型部署成功。
重要如果后续不使用已部署的在线模型,请单击操作列的停止,避免产生不必要的费用。
相关文档
Designer提供丰富的工作流模板,您也可以直接基于模板快速构建模型,详情请参见模板工作流。
您可以通过DataWorks调度离线工作流,周期性更新模型,详情请参见使用DataWorks离线调度Designer工作流。
您可以在工作流中配置全局变量,用于在线工作流和DataWorks离线调度工作流,提升工作流的灵活性和效率,详情请参见全局变量。