
在ComfyUI中进行AI绘图和视频生成时,为提升模型推理效率,可以安装并使用ComfyUI-deepgpu加速插件,该插件能显著缩短生成时间,最高可将性能提升5倍。
ComfyUI-deepgpu插件介绍
ComfyUI-deepgpu是一款免费插件,将阿里云DeepGPU推理加速技术以插件的形式集成至ComfyUI,提升在阿里云服务器上运行 ComfyUI工作流时的模型推理速度。该插件优势如下:
较高的性能提升:DeepGPU能够有效降低模型的推理时间。
较好的兼容与叠加能力:DeepGPU 可与
fp8、sage-attention、TeaCache或WaveSpeed等其他流行的开源优化技术同时使用,可在享有社区最新成果的同时,获得额外的性能增益。便捷的动态部署:与一些需要预先编译模型的优化方案不同,DeepGPU无需预编译,即时启用加速,并且在工作流中切换不同的图像或视频尺寸时,不会产生额外开销。
适用范围
支持的模型 | 推荐GPU型号 |
|
其他GPU型号同样支持,但性能提升幅度可能不及推荐型号。 |
使用限制
运行环境要求:ComfyUI必须部署在阿里云的云服务实例上,仅阿里云上的云服务实例可使用DeepGPU的加速能力。
插件兼容性:本插件兼容ComfyUI官方工作流及大多数第三方节点。但暂不支持由
WanVideoWrapper插件提供的工作流。
安装插件
安装基础依赖。
Ubuntu
apt-get install which curl iputils-ping -yAlibaba Cloud Linux 3
yum install -y which curl iputils安装PyTorch依赖(推荐
2.11.0版本)。# 安装 PyTorch 及其相关组件 pip3 install torch==2.11.0 torchvision==0.26.0 torchaudio==2.11.0安装
deepgpu-torch依赖。请根据已安装的torch版本,选择对应后缀的软件包。# 如果是安装的torch2.11 pip3 install deepgpu-torch==0.3.5+torch2.11.0cu130 -f https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/deepytorch/index.html # 如果是安装的torch其他版本,选择安装以下合适后缀的deepgpu-torch软件包 # pip3 install deepgpu-torch==0.3.5+torch2.10.0cu128 -f https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/deepytorch/index.html下载并安装插件。
# 1. 切换到ComfyUI的自定义节点目录,使用时请替换为实际路径 cd ~/ComfyUI/custom_nodes/ # 2. 下载插件压缩包并解压 wget https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/nodes/20260827/ComfyUI-deepgpu.tar.gz tar zxf ComfyUI-deepgpu.tar.gz # 3. 安装插件的Python依赖 pip3 install deepgpu-comfyui==2.0.0 -f https://aiacc-inference-public-v2.oss-cn-hangzhou.aliyuncs.com/deepgpu/comfyui/index.html重启ComfyUI服务。
使用插件
安装完插件及相关依赖后,您可以在工作流中添加DeepGPU优化节点,获得模型推理加速效果。
添加DeepGPU优化节点
在工作流中添加 ApplyDeepyTorchToModel 节点,可获得针对特定模型的深度优化。该节点接收一个模型对象(MODEL),对其应用DeepGPU的优化策略,然后输出一个优化后的模型对象。
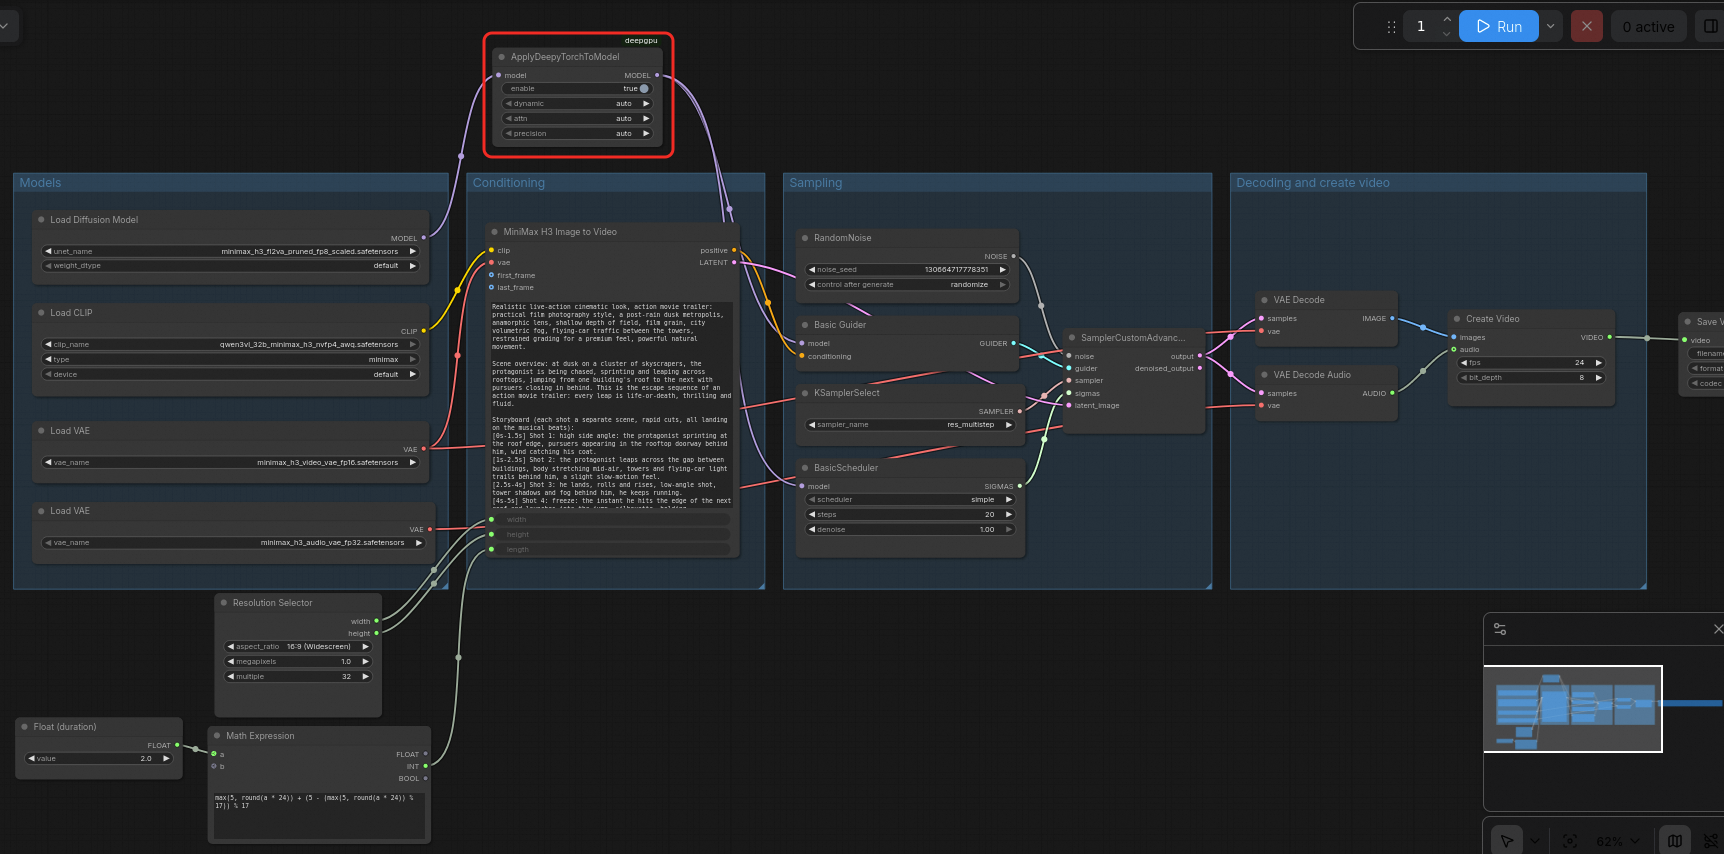
针对MiniMax-H3模型,DeepGPU还提供了支持多卡并行推理的专用节点,请参见下文。
节点在工作流中的位置
为确保优化生效,ApplyDeepyTorchToModel节点应遵循一个核心原则:将其放置在整个工作流最后一个对模型进行处理或加载的节点之后,但需在采样器(KSampler)之前。
例如在示例工作流中,ApplyDeepyTorchToModel在Load Diffusion Model节点之后

ApplyDeepyTorchToModel节点参数说明
删除或禁用ApplyDeepyTorchToModel节点,需重启ComfyUI服务才能生效。参数 | 用途 | 默认值 | 说明 |
| 是否启用DeepGPU优化 |
| 设置为 |
| 是否使用动态尺寸优化 |
| 保持默认的 |
| Attention模块优化策略 |
| 保持默认的 |
| 运算精度优化 |
| 保持默认的 |
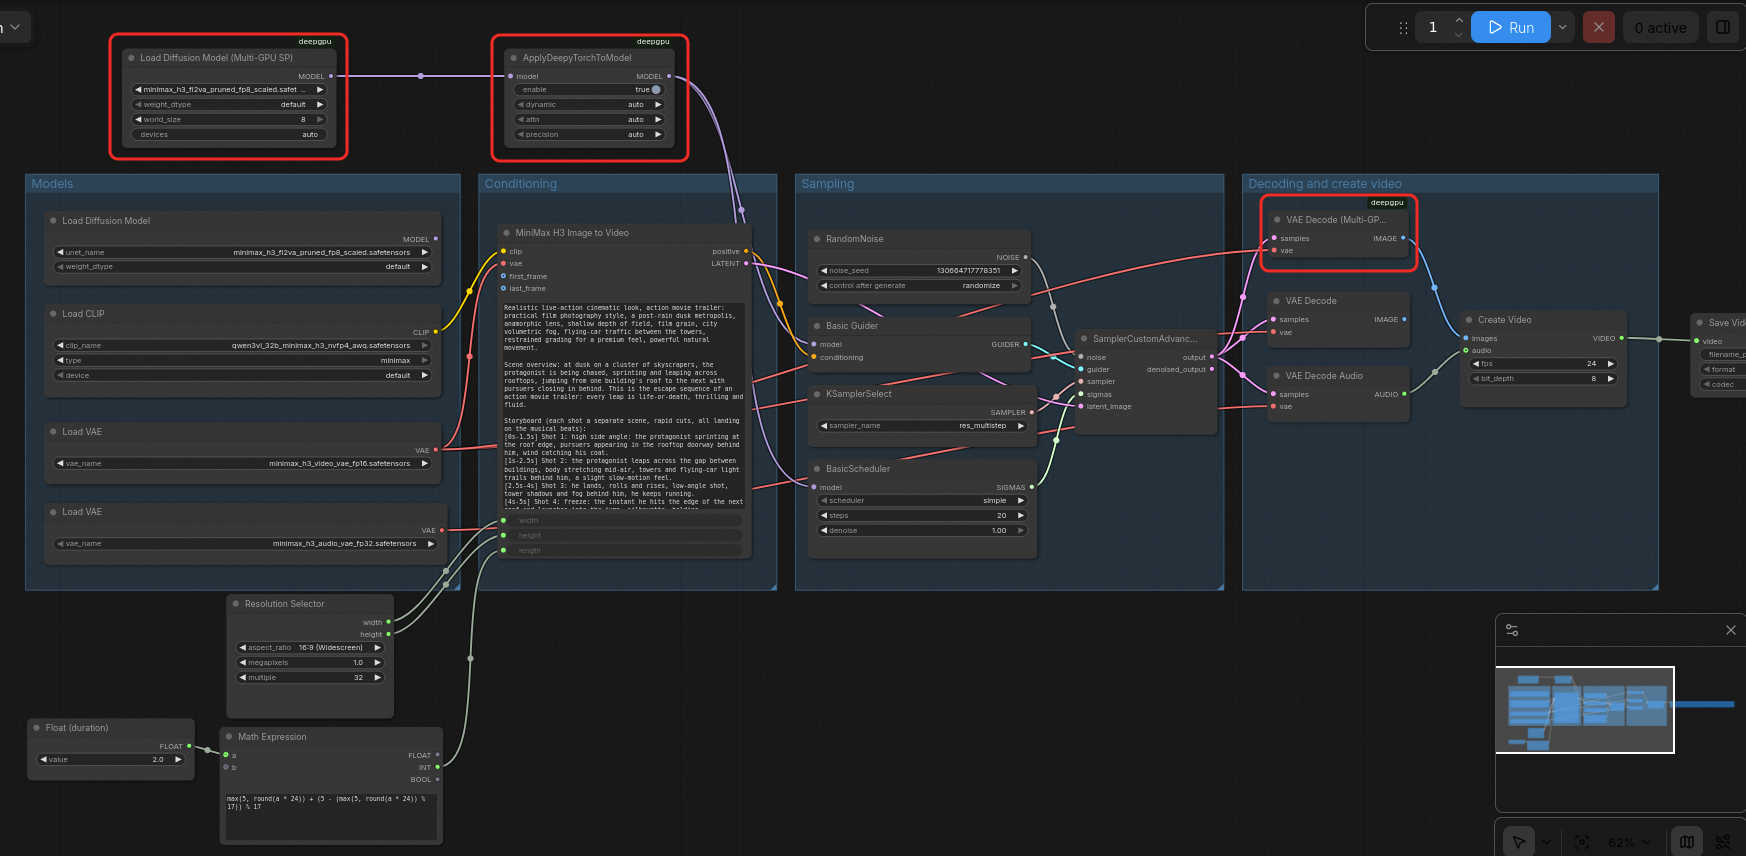
Load Diffusion Model(Multi-GPU SP)节点
用于多卡并行推理场景,替换工作流中的Load Diffusion Model节点即可,目前仅支持MiniMax-H3模型。
参数 | 用途 | 默认值 | 说明 |
第一个参数 | 加载模型 | 无 | 与 |
| 权重加载类型 |
| 与 |
| 并发推理卡数 |
| 根据需要可设置为1、2、4或8。 |
| 并发推理占用的GPU ID |
| 自动分配。例如机器有8卡,只想使用最后2卡时,可设置为 |
VAE Decode(Multi-GPU SP)节点
用于多卡并行推理场景,替换工作流中的VAE Decode节点即可,目前仅支持MiniMax-H3模型,无额外配置参数。
典型应用场景与工作流示例
本章节提供了多个即刻可用的工作流(Workflow)示例,覆盖主流模型,并展示了如何将DeepGPU与社区热门插件协同使用。
可下载对应示例的.json 文件,并将其拖拽到ComfyUI界面中直接加载使用。场景一:加速FLUX.1模型
基础加速:在
Load Diffusion Model后直接接入ApplyDeepyTorchToModel。
叠加LoRA:在最后一个
LoraLoaderModelOnly节点后接入ApplyDeepyTorchToModel。
叠加TeaCache插件:在
TeaCache节点后接入ApplyDeepyTorchToModel。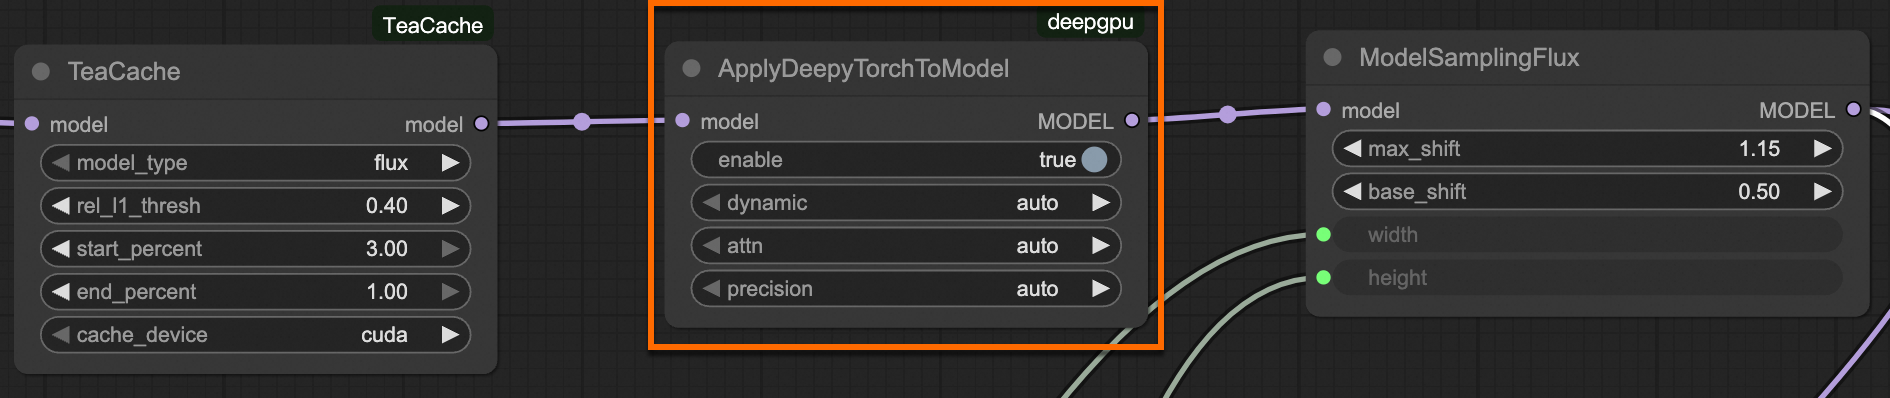
叠加PuLID插件:在
Apply PuLID Flux节点后接入ApplyDeepyTorchToModel。
叠加WaveSpped插件:在
Apply First Block Cache节点后接入ApplyDeepyTorchToModel。

场景二:加速Wan2.1视频生成
基础加速:在
Load Diffusion Model节点后接入ApplyDeepyTorchToModel。叠加TeaCache插件:在
TeaCache节点后接入ApplyDeepyTorchToModel。


场景三:加速Wan2.2视频生成
基础加速:在处理模型的最后一个节点后、送入
KSampler之前,接入ApplyDeepyTorchToModel。
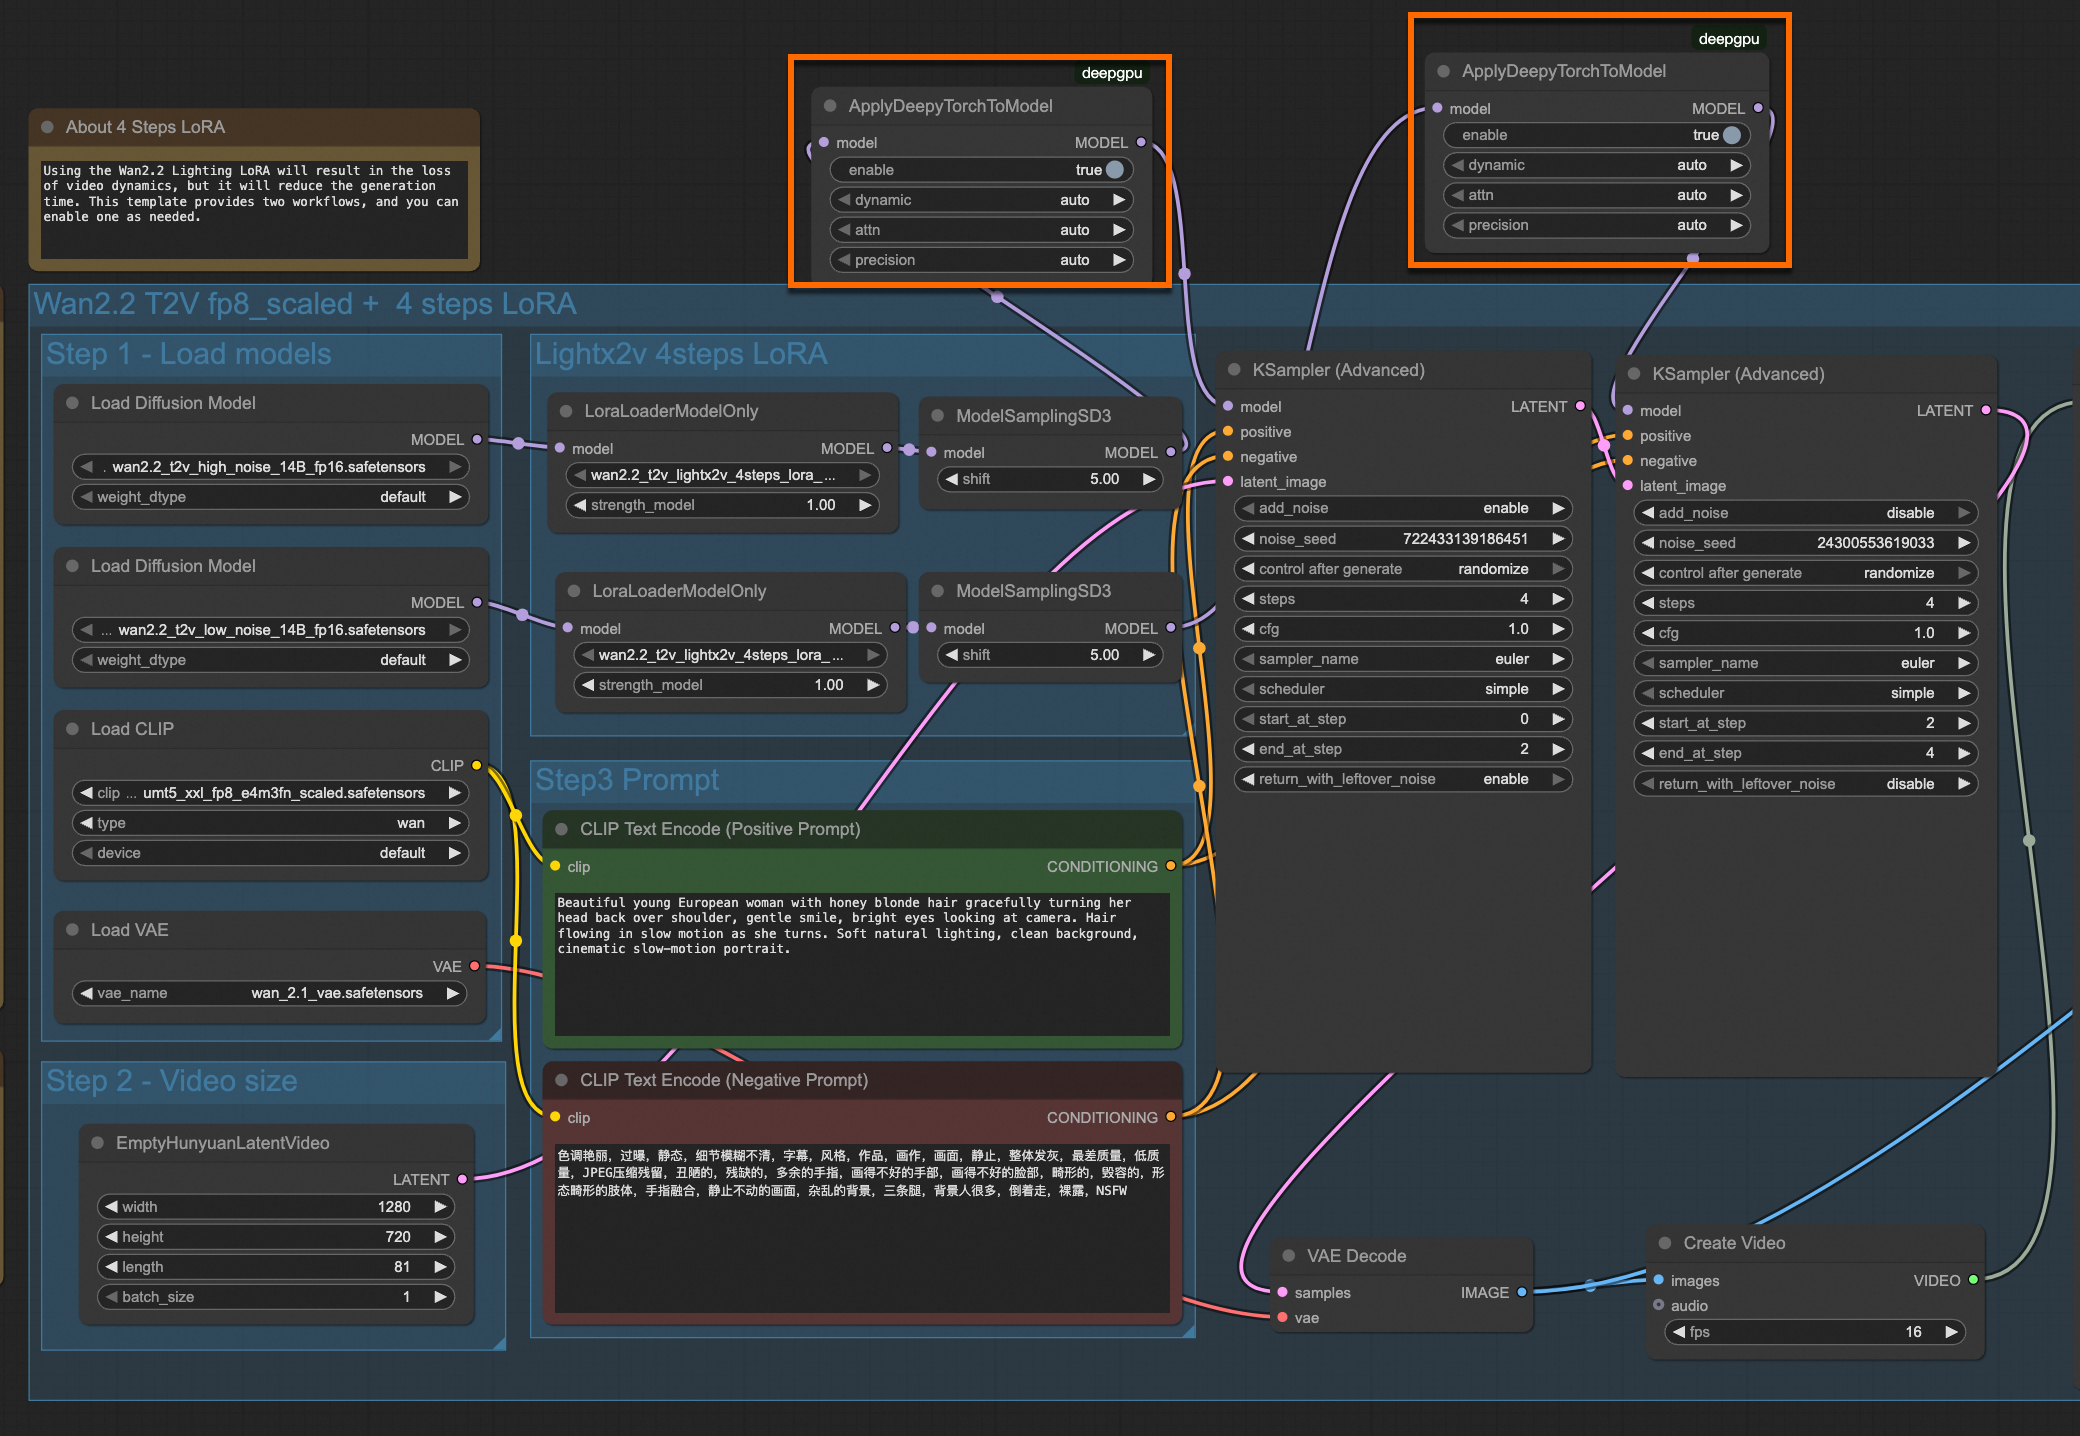
场景四:加速MiniMax-H3视频生成
MiniMax-H3视频生成的官方工作流模板请参见ComfyUI官方教程,以下示例基于官方模板(video_minimax_h3_t2v.json)添加DeepGPU加速能力。
性能数据
以下测试数据基于阿里云服务器实例,在不同GPU型号及分辨率设置下,DeepGPU插件对模型推理带来的性能提升。
FLUX.1 图像生成模型
基础加速性能
测试条件:flux1-dev 模型,迭代步数 20 steps
GPU型号 | 推理精度 | 分辨率(WxH) | 原生耗时(torch 2.8) | DeepGPU耗时 |
L20 | default (bf16) | 1024 * 1024 | 16.40s | 12.47s |
1280 * 720 | 14.61s | 11.28s | ||
fp8_e4m3fn_fast | 1024 * 1024 | 12.24s | 7.78s | |
1280 * 720 | 10.81s | 6.90s | ||
G49E | default (bf16) | 1024 * 1024 | 11.99s | 6.05s |
1280 * 720 | 10.44s | 5.24s | ||
fp8_e4m3fn_fast | 1024 * 1024 | 9.09s | 3.92s | |
1280 * 720 | 7.79s | 3.47s | ||
G59 | default (bf16) | 1024 * 1024 | 8.34s | 4.56s |
1280 * 720 | 8.05s | 4.1s |
极致加速性能(叠加优化)
测试条件:flux1-dev模型,叠加 fp8 + sage-attention + TeaCache + DeepGPU。测试工作流
GPU型号 | 分辨率 | 初始性能 (bf16) | 叠加优化后耗时 |
G49E | 1024x1024 | 11.99s | 2.33s |
Qwen-Image 图像生成模型
测试条件:qwen_image_fp8_e4m3fn模型,迭代步数 20 steps
GPU型号 | 分辨率(WxH) | 原生耗时 (torch 2.8) | DeepGPU 耗时 |
G49E | 1328 * 1328 | 45.16s | 31.18s |
1024 * 1024 | 25.52s | 19.60s |
Wan 2.1视频生成模型
基础加速性能
测试条件:迭代步数 20 steps
模型规格 | GPU型号 | 推理精度 | 分辨率(WxH) | 帧数(L) | 原生耗时(torch 2.8) | DeepGPU 耗时 |
wan2.1_Fun_InP_1.3B_bf16 | G49E | default (fp16) | 512 * 512 | 65 | 40.3s | 18.5s |
wan2.1_t2v_14B_fp16 | G49E | default (fp16) | 1280 * 720 | 81 | 1787s | 759s |
832 * 480 | 81 | 496s | 225s |
极致加速性能(叠加优化)
测试条件:叠加 fp8 + sage-attention + TeaCache(0.26) + DeepGPU
模型规格 | GPU型号 | 分辨率(WxH) | 帧数(L) | 初始性能(fp16) | 叠加优化后耗时 |
wan2.1_t2v_14B_fp16 | G49E | 1280 * 720 | 81 | 1787s | 437s |
Wan2.2 视频生成模型
基础加速性能
测试条件:Wan2.2 14B 模型(wan2.2_t2v_high/low_noise_14B_fp16),迭代步数 4 steps + LoRA
GPU型号 | 推理精度 | 分辨率(WxH) | 帧数(L) | 原生耗时 (torch 2.8) | DeepGPU 耗时 |
G49E | default (fp16) | 1280 * 720 | 81 | 200.5s | 94.6s |
640 * 640 | 81 | 64.8s | 35.8s | ||
fp8_e4m3fn_fast | 1280 * 720 | 81 | 177.7s | 80.9s |
极致加速性能(叠加优化)
测试条件:Wan2.2 14B 模型(wan2.2_t2v_high/low_noise_14B_fp16),叠加 fp8 + sage-attention + DeepGPU
GPU型号 | 分辨率(WxH) | 帧数(L) | 初始性能 (fp16) | 叠加优化后耗时 |
G49E | 1280 * 720 | 81 | 200.5s | 80.9s |
MiniMax-H3 视频生成模型
测试条件:minimax_h3_fl2va_pruned_fp8_scaled模型,迭代步数 20 steps
GPU型号 | 推理精度 | 分辨率与帧数(WxHxL) | 原生耗时(torch 2.11) | DeepGPU耗时 |
L20N | default (bf16) | 1376 * 768 * 124 | 330.78s | 227.46s |
L20N×8(8卡并行) | default (bf16) | 1376 * 768 * 124 | 55.53s | 42.04s |
常见问题
安装插件后,ComfyUI启动报错或找不到
ApplyDeepyTorchToModel节点怎么办?请按以下步骤排查
确认重启:确保在安装插件后已完全重启ComfyUI服务。
检查路径:确认
ComfyUI-deepgpu文件夹是否被正确解压到了ComfyUI/custom_nodes/目录下。检查依赖:重新安装
deepgpu-torch和deepgpu-comfyui依赖,检查是否有报错。版本冲突:检查PyTorch版本是否与安装的
deepgpu-torch版本后缀(如+torch2.11.0cu130)严格对应。
使用DeepGPU加速后,生成的图像或视频质量会下降吗?
在默认的
auto配置下,DeepGPU旨在实现无损或体感无损的加速。它会自动选择最优的精度策略,在绝大多数情况下,不会观察到肉眼可见的质量差异。我的GPU型号不在推荐列表里,还能使用吗?
可以。推荐列表是经过深度优化和测试、性能提升最显著的型号。其他 NVIDIA GPU同样可以运行并获得加速效果,只是提升幅度可能会有所不同。
如何更新DeepGPU插件?
访问官方发布渠道获取最新的
.tar.gz压缩包和pip install命令,然后重新安装插件(建议先删除旧的ComfyUI-deepgpu文件夹),即可覆盖并更新到最新版本。为什么添加了DeepGPU优化节点,优化没有生效?
确认模型支持:DeepGPU 主要针对特定模型(如 FLUX.1, Wan2.1 等)进行优化,非支持模型无法触发加速。
检查参数设置:确认节点上的
enable参数设置为true。