
本文介绍如何使用消息队列Kafka连接器。
背景信息
Apache Kafka是一款开源的分布式消息队列系统,广泛用于高性能数据处理、流式分析、数据集成等大数据领域。Kafka连接器基于开源Apache Kafka客户端,为阿里云实时计算Flink提供高性能的数据吞吐、多种数据格式的读写和精确一次语义的支持。
|
类别 |
详情 |
|
支持类型 |
源表和结果表,数据摄入目标端 |
|
运行模式 |
流模式 |
|
数据格式 |
|
|
特有监控指标 |
|
|
API种类 |
SQL,Datastream和数据摄入YAML |
|
是否支持更新或删除结果表数据 |
不支持更新和删除结果表数据,只支持插入数据。 说明
更新和删除数据相关功能请参见Upsert Kafka。 |
前提条件
请根据需求选择以下任意一种方式连接集群:
-
连接阿里云云消息队列Kafka版集群
-
Kafka集群版本在0.11及以上。
-
云消息队列 Kafka 版集群已创建。详情请参见创建资源。
-
Flink工作空间与Kafka集群处于同一VPC内,且云消息队列 Kafka 版已对Flink开放白名单,具体操作请参见配置白名单。
重要写入阿里云Kafka的限制:
-
阿里云Kafka不支持zstd压缩格式写入。
-
阿里云Kafka不支持幂等和事务写入,无法使用Kafka结果表提供的精确一次语义exactly-once semantic功能。自实时计算引擎VVR 8.0.0版本起,Kafka Connector 使用的开源Kafka Client版本升级到3.x版本,该Client的
properties.enable.idempotence属性默认值从false变为true表示显式开启幂等写入, 因此在使用实时计算引擎VVR 8.0.0及以上版本写入阿里云Kafka时,需要在结果表中添加显式配置properties.enable.idempotence=false以关闭幂等写入功能,避免无法写入阿里云Kafka的问题。阿里云Kafka的存储引擎对比与功能限制参见存储引擎对比。
-
-
连接自建Apache Kafka集群
注意事项
目前不推荐使用事务写入,这是 Flink 社区和 Kafka 社区的设计缺陷所致。当设置sink.delivery-guarantee = exactly-once,Kafka Connector 会启用事务写入,存在三个已知问题:
-
每个 Checkpoint 会生成一个 Transaction ID。如果 Checkpoint 间隔太短,Transaction ID会过多。Kafka 集群的 Coordinator 可能因此内存不足,从而破坏 Kafka 集群的稳定性。
-
每个事务会创建一个 Producer 实例。如果同时提交的事务太多,TaskManager 的内存可能耗尽,从而破坏 Flink 作业的稳定性。
-
多个 Flink 作业若使用相同的
sink.transactional-id-prefix,它们生成的事务 ID 可能冲突。一个作业写入失败时,会阻塞 Kafka 分区的 LSO(Log Start Offset)前进,这会影响所有消费者读取该分区的数据。
如果你需要 Exactly-Once 语义,改用 Upsert Kafka 写入主键表,并用主键保证幂等性。如果需要使用事务写入,请参见EXACTLY_ONCE语义注意事项。
网络连接排查
Flink作业启动时若报错Timed out waiting for a node assignment,通常是因为 Flink 与 Kafka 之间网络不通。
Kafka 客户端连接服务端如下所示:
-
客户端用
bootstrap.servers中的地址连接 Kafka。 -
Kafka 返回集群中各 broker 的元数据,包括它们的连接地址。
-
客户端再用这些返回的地址连接各 broker,进行读写。
即使bootstrap.servers地址能通,若 Kafka 返回的 broker 地址错误,客户端仍无法读写。这类问题常出现在使用代理、端口转发或专线等网络架构中。
排查步骤
消息队列Kafka
自建Kafka(ECS)
-
使用Flink开发控制台进行网络探测。
排除
bootstrap.servers地址连通性问题,确认内外网接入点正确性。 -
检查安全组与白名单
-
ECS 安全组必须放行 Kafka 接入点端口(通常为 9092 或 9093)。
-
ECS 实例需将 Flink 所在VPC加入白名单,详情请参见查看VPC网段。
-
-
配置排查
-
登录 Kafka 所用的 ZooKeeper 集群,使用 zkCli.sh 或 zookeeper-shell.sh工具。
-
执行命令获取 broker 元数据。例如:
get /brokers/ids/0。在返回结果的endpoints字段中,找到 Kafka 向客户端通告的地址。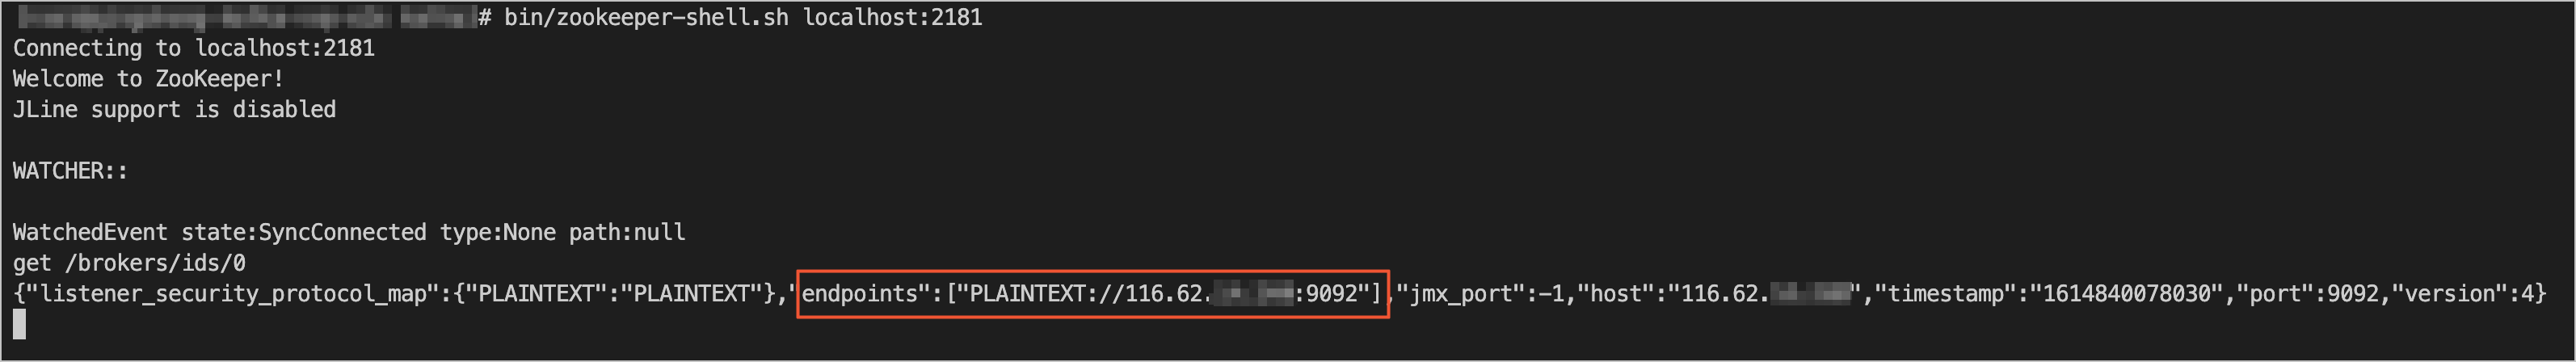
-
Flink开发控制台进行网络探测,测试该地址是否可达。
说明-
若不可达,请 Kafka 运维人员检查并修正
listeners和advertised.listeners配置,确保返回的地址对 Flink 可访问。 -
更多关于Kafka客户端与服务端的连接信息,请参见Troubleshoot Connectivity。
-
-
-
检查 SASL 配置(如启用)
若使用 SASL_SSL接入点,必须在 Flink 作业中正确配置 JAAS、SSL 与 SASL 机制。缺少认证会导致连接在握手阶段失败,也可能表现为超时,详情请参见安全与认证。
SQL
Kafka连接器可以在SQL作业中使用,作为源表或者结果表。
语法结构
CREATE TABLE KafkaTable (
  `user_id` BIGINT,
  `item_id` BIGINT,
  `behavior` STRING,
  `ts` TIMESTAMP_LTZ(3) METADATA FROM 'timestamp' VIRTUAL
) WITH (
  'connector' = 'kafka',
  'topic' = 'user_behavior',
  'properties.bootstrap.servers' = 'localhost:9092',
  'properties.group.id' = 'testGroup',
  'scan.startup.mode' = 'earliest-offset',
  'format' = 'csv'
)
元信息列
可以在源表和结果表中定义元信息列,以获取或写入Kafka消息的元信息。例如,当WITH参数中定义了多个topic时,如果在Kafka源表中定义了元信息列,那么Flink读取到的数据就会被标识是从哪个topic中读取的数据。元信息列的使用示例如下。
CREATE TABLE kafka_source (
  --读取消息所属的topic作为`record_topic`字段
  `record_topic` STRING NOT NULL METADATA FROM 'topic' VIRTUAL,
  --读取ConsumerRecord中的时间戳作为`ts`字段
  `ts` TIMESTAMP_LTZ(3) METADATA FROM 'timestamp' VIRTUAL,
  --读取消息的offset作为`record_offset`字段
  `record_offset` BIGINT NOT NULL METADATA FROM 'offset' VIRTUAL,
  ...
) WITH (
  'connector' = 'kafka',
  ...
);

CREATE TABLE kafka_sink (
  --将`ts`字段中的时间戳作为ProducerRecord的时间戳写入Kafka
  `ts` TIMESTAMP_LTZ(3) METADATA FROM 'timestamp' VIRTUAL,
  ...
) WITH (
  'connector' = 'kafka',
  ...
);下表列出了Kafka源表和结果表所支持的元信息列。
|
Key |
数据类型 |
说明 |
源表或结果表 |
|
topic |
STRING NOT NULL METADATA VIRTUAL |
Kafka消息所在的Topic名称。 |
源表 |
|
partition |
INT NOT NULL METADATA VIRTUAL |
Kafka消息所在的Partition ID。 |
源表 |
|
headers |
MAP<STRING, BYTES> NOT NULL METADATA VIRTUAL |
Kafka消息的消息头(header)。 |
源表和结果表 |
|
leader-epoch |
INT NOT NULL METADATA VIRTUAL |
Kafka消息的Leader epoch。 |
源表 |
|
offset |
BIGINT NOT NULL METADATA VIRTUAL |
Kafka消息的偏移量(offset)。 |
源表 |
|
timestamp |
TIMESTAMP(3) WITH LOCAL TIME ZONE NOT NULL METADATA VIRTUAL |
Kafka消息的时间戳。 |
源表和结果表 |
|
timestamp-type |
STRING NOT NULL METADATA VIRTUAL |
Kafka消息的时间戳类型:
|
源表 |
|
__raw_key__ |
STRING NOT NULL METADATA VIRTUAL |
Kafka原始消息的Key字段。 |
源表和结果表 说明
仅VVR 11.4及以上版本支持该参数。 |
|
__raw_value__ |
STRING NOT NULL METADATA VIRTUAL |
Kafka原始消息的Value字段。 |
源表和结果表 说明
仅VVR 11.4及以上版本支持该参数。 |
WITH参数
-
通用
参数
说明
数据类型
是否必填
默认值
备注
connector
表类型。
String
是
无
固定值为kafka。
properties.bootstrap.servers
Kafka broker地址。
String
是
无
格式为host:port,host:port,host:port,以英文逗号(,)分割。
properties.*
对Kafka客户端的直接配置。
String
否
无
Flink会将properties.前缀移除,并将剩余的配置传递给Kafka客户端。例如可以通过
'properties.allow.auto.create.topics'='false'来禁用自动创建topic。不能通过该方式修改以下配置,因为它们会被Kafka连接器覆盖:
-
key.deserializer
-
value.deserializer
format
读取或写入Kafka消息value部分时使用的格式。
String
否
无
支持的格式
-
csv
-
json
-
avro
-
debezium-json
-
canal-json
-
maxwell-json
-
avro-confluent
-
raw
说明更多format参数设置请参见Format参数。
key.format
读取或写入Kafka消息key部分时使用的格式。
String
否
无
支持的格式
-
csv
-
json
-
avro
-
debezium-json
-
canal-json
-
maxwell-json
-
avro-confluent
-
raw
说明使用该配置时,key.options配置是必填的。
key.fields
Kafka消息key部分对应的源表或结果表字段。
String
否
无
多个字段名以分号(;)分隔。例如
field1;field2key.fields-prefix
为所有Kafka消息key部分指定自定义前缀,以避免与消息value部分格式字段重名。
String
否
无
该配置项仅用于源表和结果表的列名区分,解析和生成Kafka消息key部分时,该前缀会被移除。
说明使用该配置时,
value.fields-include必须配置为EXCEPT_KEY。value.format
读取或写入Kafka消息value部分时使用的格式。
String
否
无
该配置等同于
format,只能设置format或value.format中的一个。如果同时配置,value.format会覆盖format。value.fields-include
在解析或生成Kafka消息value部分时,是否要包含消息key部分对应的字段。
String
否
ALL
参数取值如下:
-
ALL(默认值):所有列都会作为Kafka消息value部分处理 -
EXCEPT_KEY:除去key.fields定义的字段,剩余字段作为Kafka消息value部分处理
-
-
源表
参数
说明
数据类型
是否必填
默认值
备注
topic
读取的topic名称。
String
否
无
以英文分号 (;) 分隔多个topic名称,例如topic-1和topic-2
说明topic和topic-pattern两个选项只能指定其中一个。
topic-pattern
匹配读取topic名称的正则表达式。所有匹配该正则表达式的topic在作业运行时均会被读取。
String
否
无
示例:
-
user_event_.*:匹配所有以user_event_开头的 topic -
prod\.logs\..*:匹配prod.logs.前缀的 topic(.需转义)
说明topic和topic-pattern两个选项只能指定其中一个。
properties.group.id
消费组ID。
String
否
KafkaSource-{源表表名}
如果指定的group id为首次使用,则必须将properties.auto.offset.reset设置为earliest或latest以指定首次启动位点。
scan.startup.mode
Kafka读取数据的启动位点。
String
否
group-offsets
取值如下:
-
earliest-offset:从Kafka最早的分区开始读取。 -
latest-offset:从Kafka最新位点开始读取。 -
group-offsets(默认值):从指定的properties.group.id已提交的位点开始读取。 -
timestamp:从scan.startup.timestamp-millis指定的时间戳开始读取。 -
specific-offsets:从scan.startup.specific-offsets指定的偏移量开始读取。
说明该参数在作业无状态启动时生效。作业在从checkpoint重启或状态恢复时,会优先使用状态中保存的进度恢复读取。
scan.startup.specific-offsets
specific-offsets启动模式下,指定每个分区的启动偏移量。
String
否
无
例如
partition:0,offset:42;partition:1,offset:300scan.startup.timestamp-millis
timestamp启动模式下,指定启动位点时间戳。
Long
否
无
单位为毫秒
scan.topic-partition-discovery.interval
动态检测Kafka topic和partition的时间间隔。
Duration
否
5分钟
分区检查间隔默认为5分钟。需要显式地设置分区检查间隔为非正数才能关闭此功能。开启动态分区发现后,Kafka Source 可以自动地发现新增的分区并自动读取对应分区上的数据。在topic-pattern模式下,不仅读取已有topic的新增分区数据,也会读取符合正则匹配的新增topic的所有分区数据。
说明在实时计算引擎VVR 6.0.x版本中,动态分区检测默认为关闭。自8.0版本起该功能默认打开,检测间隔默认设置为5分钟。
scan.header-filter
根据Kafka数据是否包含指定的消息头(Header)对数据进行条件过滤。
String
否
无
Header key和value使用冒号(:)分隔,多个header条件之间使用逻辑运算符(&、|)连接,支持取反逻辑运算符(!)。例如
depart:toy|depart:book&!env:test表示保留header中包含depart=toy或depart=book,且不包含env=test的Kafka数据。说明-
仅实时计算引擎VVR 8.0.6及以上版本支持配置该参数。
-
暂不支持括号运算。
-
逻辑运算顺序为从左至右。
-
Header value会以UTF-8格式转换为字符串,与参数指定的header value进行比较。
scan.check.duplicated.group.id
是否检查通过
properties.group.id指定的消费者组有重复。Boolean
否
false
参数取值如下:
-
true:在启动作业前,系统会检查消费者组是否存在重复。若发现重复,作业将报错并停止运行,从而避免与现有消费者组产生冲突。
-
false:直接启动作业,不检查消费者组冲突。
说明仅VVR 6.0.4及以上版本支持该参数。
-
-
结果表
参数
说明
数据类型
是否必填
默认值
备注
topic
写入的topic名称。
String
是
无
无
sink.partitioner
从Flink并发到Kafka分区的映射模式。
String
否
default
取值如下:
-
default(默认值):使用Kafka默认的分区模式
-
fixed:每个Flink并发对应一个固定的Kafka分区。
-
round-robin:Flink并发中的数据将被轮流分配至Kafka的各个分区。
-
自定义分区映射模式:如果fixed和round-robin不满足需求,可以创建一个FlinkKafkaPartitioner的子类来自定义分区映射模式。例如org.mycompany.MyPartitioner
sink.delivery-guarantee
Kafka结果表的语义模式。
String
否
at-least-once
取值如下:
-
none:不保证任何语义,数据可能会丢失或重复。
-
at-least-once(默认值):保证数据不丢失,但可能会重复。
-
exactly-once:使用Kafka事务保证数据不会丢失和重复。
说明在使用exactly-once语义时,sink.transactional-id-prefix是必填的。
sink.transactional-id-prefix
在exactly-once语义下使用的Kafka事务ID前缀。
String
否
无
只有sink.delivery-guarantee配置为exactly-once时该配置才会生效。
sink.parallelism
Kafka结果表算子的并发数。
Integer
否
无
上游算子的并发,由框架决定。
-
安全与认证
如果Kafka集群要求安全连接或认证,请将相关的安全与认证配置添加properties.前缀后设置在WITH参数中。配置Kafka表以使用PLAIN作为SASL机制,并提供JAAS配置的示例如下。
CREATE TABLE KafkaTable (
  `user_id` BIGINT,
  `item_id` BIGINT,
  `behavior` STRING,
  `ts` TIMESTAMP_LTZ(3) METADATA FROM 'timestamp'
) WITH (
  'connector' = 'kafka',
  ...
  'properties.security.protocol' = 'SASL_PLAINTEXT',
  'properties.sasl.mechanism' = 'PLAIN',
  'properties.sasl.jaas.config' = 'org.apache.flink.kafka.shaded.org.apache.kafka.common.security.plain.PlainLoginModule required username="username" password="password";'
)使用SASL_SSL作为安全协议,并使用SCRAM-SHA-256作为SASL机制的示例如下。
CREATE TABLE KafkaTable (
  `user_id` BIGINT,
  `item_id` BIGINT,
  `behavior` STRING,
  `ts` TIMESTAMP_LTZ(3) METADATA FROM 'timestamp'
) WITH (
  'connector' = 'kafka',
  ...
  'properties.security.protocol' = 'SASL_SSL',
  /*SSL配置*/
  /*配置服务端提供的truststore (CA 证书) 的路径*/
  /*文件管理上传的文件会存放在/flink/usrlib/路径下*/
  'properties.ssl.truststore.location' = '/flink/usrlib/kafka.client.truststore.jks',
  'properties.ssl.truststore.password' = 'test1234',
  /*如果要求客户端认证,则需要配置keystore (私钥) 的路径*/
  'properties.ssl.keystore.location' = '/flink/usrlib/kafka.client.keystore.jks',
  'properties.ssl.keystore.password' = 'test1234',
  /*客户端验证服务器地址的算法,空值表示禁用服务器地址验证*/
  'properties.ssl.endpoint.identification.algorithm' = '',
  /*SASL配置*/
  /*将SASL机制配置为as SCRAM-SHA-256*/
  'properties.sasl.mechanism' = 'SCRAM-SHA-256',
  /*配置JAAS*/
  'properties.sasl.jaas.config' = 'org.apache.flink.kafka.shaded.org.apache.kafka.common.security.scram.ScramLoginModule required username="username" password="password";'
)示例中提到的CA证书和私钥可使用实时计算控制台的文件管理功能上传至平台。上传后文件存放在/flink/usrlib目录下,需要使用的CA证书文件名为my-truststore.jks,则上传后在WITH参数中有两种方式可以设置'properties.ssl.truststore.location'来使用该证书:
-
配置
'properties.ssl.truststore.location' = '/flink/usrlib/my-truststore.jks',采用这种方式Flink运行期间不需要动态下载OSS文件,但是不支持调试模式。 -
实时计算引擎版本为 VVR 11.5 及以上,可以配置
properties.ssl.truststore.location和properties.ssl.keystore.location为OSS绝对路径地址,文件路径格式为oss://flink-fullymanaged-<工作空间ID>/artifacts/namespaces/<项目空间名称>/<文件名>。采用这种方式会在Flink运行期间动态下载OSS文件,支持调试模式。
-
配置确认:上文中的示例仅适用于大多数配置情况。在配置Kafka连接器前,请与Kafka服务端运维人员联系,以获取正确的安全与认证配置信息。
-
转义说明:与开源Flink不同,实时计算Flink版的SQL编辑器默认已经对双引号(")进行转义处理,因此在配置
properties.sasl.jaas.config时无需对用户名和密码中的双引号(")添加额外的转义符(\)。 -
凭据托管:配置
properties.sasl.jaas.config时,其中的用户名和密码可填写secret://kms.<secret-name>.<key>引用KMS托管的凭据,避免明文暴露。仅实时计算引擎VVR 11.9及以上版本支持,配置步骤请参见KMS 凭据管理集成。
源表起始位点
启动模式
Kafka源表可通过配置scan.startup.mode来指定初始读取位点:
-
最早位点(earliest-offset):从当前分区的最早位点开始读取。
-
最末尾位点(latest-offset):从当前分区的最末尾位点开始读取。
-
已提交位点(group-offsets):从指定group id的已提交位点开始读取,group id通过properties.group.id指定。
-
指定时间戳(timestamp):从时间戳大于等于指定时间的第一条消息开始读取,时间戳通过scan.startup.timestamp-millis指定。
-
特定位点(specific-offsets):从指定的分区位点开始消费,位点通过scan.startup.specific-offsets指定。
-
如果不指定启动位点,则默认会从已提交位点(group-offsets)启动消费。
-
scan.startup.mode只针对无状态启动的作业生效,有状态作业启动时会从状态中存储的位点开始消费。
代码示例如下:
CREATE TEMPORARY TABLE kafka_source (
  ...
) WITH (
  'connector' = 'kafka',
  ...
  --从最早位点开始消费
  'scan.startup.mode' = 'earliest-offset',
  --从最末尾位点开始消费
  'scan.startup.mode' = 'latest-offset',
  --从消费者组"my-group"的已提交位点开始消费
  'properties.group.id' = 'my-group',
  'scan.startup.mode' = 'group-offsets',
  'properties.auto.offset.reset' = 'earliest', -- 如果 "my-group" 为首次使用,则从最早位点开始消费
  'properties.auto.offset.reset' = 'latest', -- 如果 "my-group" 为首次使用,则从最末尾位点开始消费
  --从指定的毫秒时间戳1655395200000开始消费
  'scan.startup.mode' = 'timestamp',
  'scan.startup.timestamp-millis' = '1655395200000',
  --从指定位点开始消费
  'scan.startup.mode' = 'specific-offsets',
  'scan.startup.specific-offsets' = 'partition:0,offset:42;partition:1,offset:300'
);
起始位点优先级
源表起始位点的优先级为:
|
优先级从高到低 |
Checkpoint或Savepoint中存储的位点 |
|
实时计算控制台作业启动选择的启动时间 |
|
|
WITH参数中通过scan.startup.mode指定的启动位点 |
|
|
未指定scan.startup.mode的情况下使用group-offsets,使用对应消费组的位点 |
在以上任何一个步骤中,如果位点过期或Kafka集群发生问题等原因导致位点无效,则会使用properties.auto.offset.reset指定的策略进行位点重置,如果未设置该配置项,则会产生异常要求用户介入。
一种常见情况是使用全新的group id开始消费。首先源表会向Kafka集群查询该group的已提交位点,由于该group id是第一次使用,不会查询到有效位点,所以会通过properties.auto.offset.reset参数配置的策略进行重置。因此在使用全新group id进行消费时,必须配置properties.auto.offset.reset来指定位点重置策略。
源表位点提交
Kafka源表只在checkpoint成功后将当前消费位点提交至Kafka集群。如果checkpoint间隔设置较长,在Kafka集群侧观察到的消费位点会有延迟。在进行checkpoint时,Kafka源表会将当前读取进度存储在状态中,并不依赖于提交到集群上的位点进行故障恢复,提交位点仅仅是为了在Kafka侧能够监控到读取进度,位点提交失败不会对数据正确性产生任何影响。
结果表自定义分区器
如果内置的Kafka Producer分区模式无法满足需求,可以实现自定义分区模式将数据写入对应的分区。自定义分区器需要继承FlinkKafkaPartitioner,开发完成后编译JAR包,使用文件管理功能上传至实时计算控制台。上传并引用完成后,请在WITH参数中设置sink.partitioner参数,参数值为分区器完整的类路径,如org.mycompany.MyPartitioner。
Kafka、Upsert Kafka或Kafka JSON catalog的选择
Kafka是一种只能添加数据的消息队列系统,无法进行数据的更新和删除操作,因此在流式SQL计算中无法处理上游的CDC变更数据和聚合、联合等算子的回撤逻辑。如果需要将含有变更或回撤类型的数据写入Kafka,请使用对变更数据进行特殊处理的Upsert Kafka结果表。
为了方便将上游数据库中一个或多个数据表中的变更数据批量同步到Kafka中,可以使用Kafka JSON catalog。如果Kafka中存储的数据格式为JSON,使用Kafka JSON catalog可以省去定义schema和WITH参数的步骤。详情可参见管理Kafka JSON Catalog。
使用示例
示例一:从Kafka中读取数据后写入Kafka
从名称为源表的Topic中读取Kafka数据,再写入名称为结果表的Topic,数据使用CSV格式。
CREATE TEMPORARY TABLE kafka_source (
  id INT,
  name STRING,
  age INT
) WITH (
  'connector' = 'kafka',
  'topic' = 'source',
  'properties.bootstrap.servers' = '<yourKafkaBrokers>',
  'properties.group.id' = '<yourKafkaConsumerGroupId>',
  'format' = 'csv'
);

CREATE TEMPORARY TABLE kafka_sink (
  id INT,
  name STRING,
  age INT
) WITH (
  'connector' = 'kafka',
  'topic' = 'sink',
  'properties.bootstrap.servers' = '<yourKafkaBrokers>',
  'properties.group.id' = '<yourKafkaConsumerGroupId>',
  'format' = 'csv'
);

INSERT INTO kafka_sink SELECT id, name, age FROM kafka_source;
示例二:同步表结构以及数据
将Kafka Topic中的消息实时同步到Hologres中。在该情况下,可以将Kafka消息的offset和partition id作为主键,从而保证在Failover时,Hologres中不会有重复消息。
CREATE TEMPORARY TABLE kafkaTable (
  `offset` INT NOT NULL METADATA,
  `part` BIGINT NOT NULL METADATA FROM 'partition',
  PRIMARY KEY (`part`, `offset`) NOT ENFORCED
) WITH (
  'connector' = 'kafka',
  'properties.bootstrap.servers' = '<yourKafkaBrokers>',
  'topic' = 'kafka_evolution_demo',
  'scan.startup.mode' = 'earliest-offset',
  'format' = 'json',
  'json.infer-schema.flatten-nested-columns.enable' = 'true'
    --可选,将嵌套列全部展开。
);

CREATE TABLE IF NOT EXISTS hologres.kafka.`sync_kafka`
WITH (
  'connector' = 'hologres'
) AS TABLE vvp.`default`.kafkaTable;示例三:同步表结构以及Kafka消息的key和value数据
Kafka消息中的key部分已经存储了相关信息,可以同时同步Kafka中的key和value。
CREATE TEMPORARY TABLE kafkaTable (
  `key_id` INT NOT NULL,
  `val_name` VARCHAR(200)
) WITH (
  'connector' = 'kafka',
  'properties.bootstrap.servers' = '<yourKafkaBrokers>',
  'topic' = 'kafka_evolution_demo',
  'scan.startup.mode' = 'earliest-offset',
  'key.format' = 'json',
  'value.format' = 'json',
  'key.fields' = 'key_id',
  'key.fields-prefix' = 'key_',
  'value.fields-prefix' = 'val_',
  'value.fields-include' = 'EXCEPT_KEY'
);

CREATE TABLE IF NOT EXISTS hologres.kafka.`sync_kafka`(
WITH (
  'connector' = 'hologres'
) AS TABLE vvp.`default`.kafkaTable;Kafka消息中的key部分不支持表结构变更和类型解析,需要手动声明。
示例四:同步表结构和数据并进行计算
在同步Kafka数据到Hologres时,往往需要一些轻量级的计算。
CREATE TEMPORARY TABLE kafkaTable (
  `distinct_id` INT NOT NULL,
  `properties` STRING,
  `timestamp` TIMESTAMP_LTZ METADATA,
  `date` AS CAST(`timestamp` AS DATE)
) WITH (
  'connector' = 'kafka',
  'properties.bootstrap.servers' = '<yourKafkaBrokers>',
  'topic' = 'kafka_evolution_demo',
  'scan.startup.mode' = 'earliest-offset',
  'key.format' = 'json',
  'value.format' = 'json',
  'key.fields' = 'key_id',
  'key.fields-prefix' = 'key_'
);

CREATE TABLE IF NOT EXISTS hologres.kafka.`sync_kafka` WITH (
   'connector' = 'hologres'
) AS TABLE vvp.`default`.kafkaTable
ADD COLUMN
  `order_id` AS COALESCE(JSON_VALUE(`properties`, '$.order_id'), 'default');
--使用COALESCE处理空值情况。示例五:嵌套JSON解析
JSON消息示例
{
  "id": 101,
  "name": "VVP",
  "properties": {
    "owner": "阿里云",
    "engine": "Flink"
  }
}
为避免后续使用 JSON_VALUE(payload, '$.properties.owner') 等函数解析字段,可直接在 Source DDL 中定义结构:
CREATE TEMPORARY TABLE kafka_source (
  id          VARCHAR,
  `name`      VARCHAR,
  properties  ROW<`owner` STRING, engine STRING>
) WITH (
  'connector' = 'kafka',
  'topic' = 'xxx',
  'properties.bootstrap.servers' = 'xxx',
  'scan.startup.mode' = 'earliest-offset',
  'format' = 'json'
);这样,Flink会在读取阶段一次性将 JSON 解析为结构化字段,后续 SQL 查询直接使用 properties.owner,无需额外函数调用,整体性能更优。
EXACTLY_ONCE语义注意事项
-
配置消费者隔离级别
所有消费 Kafka 数据的应用必须设置 isolation.level:
-
read_committed:只读取已提交的数据。 -
read_uncommitted(默认):可读取未提交的数据。
EXACTLY_ONCE 依赖
read_committed。否则消费者可能看到未提交数据,破坏一致性。 -
-
事务超时与数据丢失
Flink 从 Checkpoint 恢复时,仅依赖该 Checkpoint 开始前已提交的事务。如果作业崩溃到重启的时间超过 Kafka 事务超时,Kafka 会自动中止事务,导致数据丢失。
-
Kafka Broker 默认
transaction.max.timeout.ms= 15 分钟。 -
Flink Kafka Sink 默认设置
transaction.timeout.ms= 1 小时。 -
你必须在 Broker 端提高
transaction.max.timeout.ms,使其不小于 Flink 的设置。
-
-
Producer 池与 Checkpoint 并发
EXACTLY_ONCE 模式使用固定大小的 Kafka Producer 池。每个 Checkpoint 占用池中的一个 Producer。如果并发 Checkpoint 数超过池大小,作业会失败。
请根据最大并发 Checkpoint 数调整 Producer 池大小。
-
并行度缩容限制
如果作业在第一个 Checkpoint 前失败,重启后不会保留原有 Producer 池信息。因此,在第一个 Checkpoint 完成前,不要缩减作业并行度。如必须缩容,并行度不得低于
FlinkKafkaProducer.SAFE_SCALE_DOWN_FACTOR。 -
事务阻塞读取
在
read_committed模式下,任何未结束(未提交也未中止)的事务会阻塞整个 Topic 的读取。例如:
-
事务 1 写入数据。
-
事务 2 写入并提交数据。
-
只要事务 1 未结束,事务 2 的数据对消费者不可见。
因此:
-
正常运行时,数据可见延迟约等于 Checkpoint 间隔。
-
作业失败时,正在写入的 Topic 会阻塞消费者,直到作业重启或事务超时,极端情况下,事务超时甚至会影响读取。
-