
语义包用于应对 AI Query 在没有业务上下文时仅能依赖表结构猜测语义的问题。通过将真实历史 SQL 中沉淀的术语、指标、关联、验证查询等业务知识编目为语义包,AI Query 能够基于统一口径回答业务问题,生成的 SQL 准确率显著提升。
功能概述
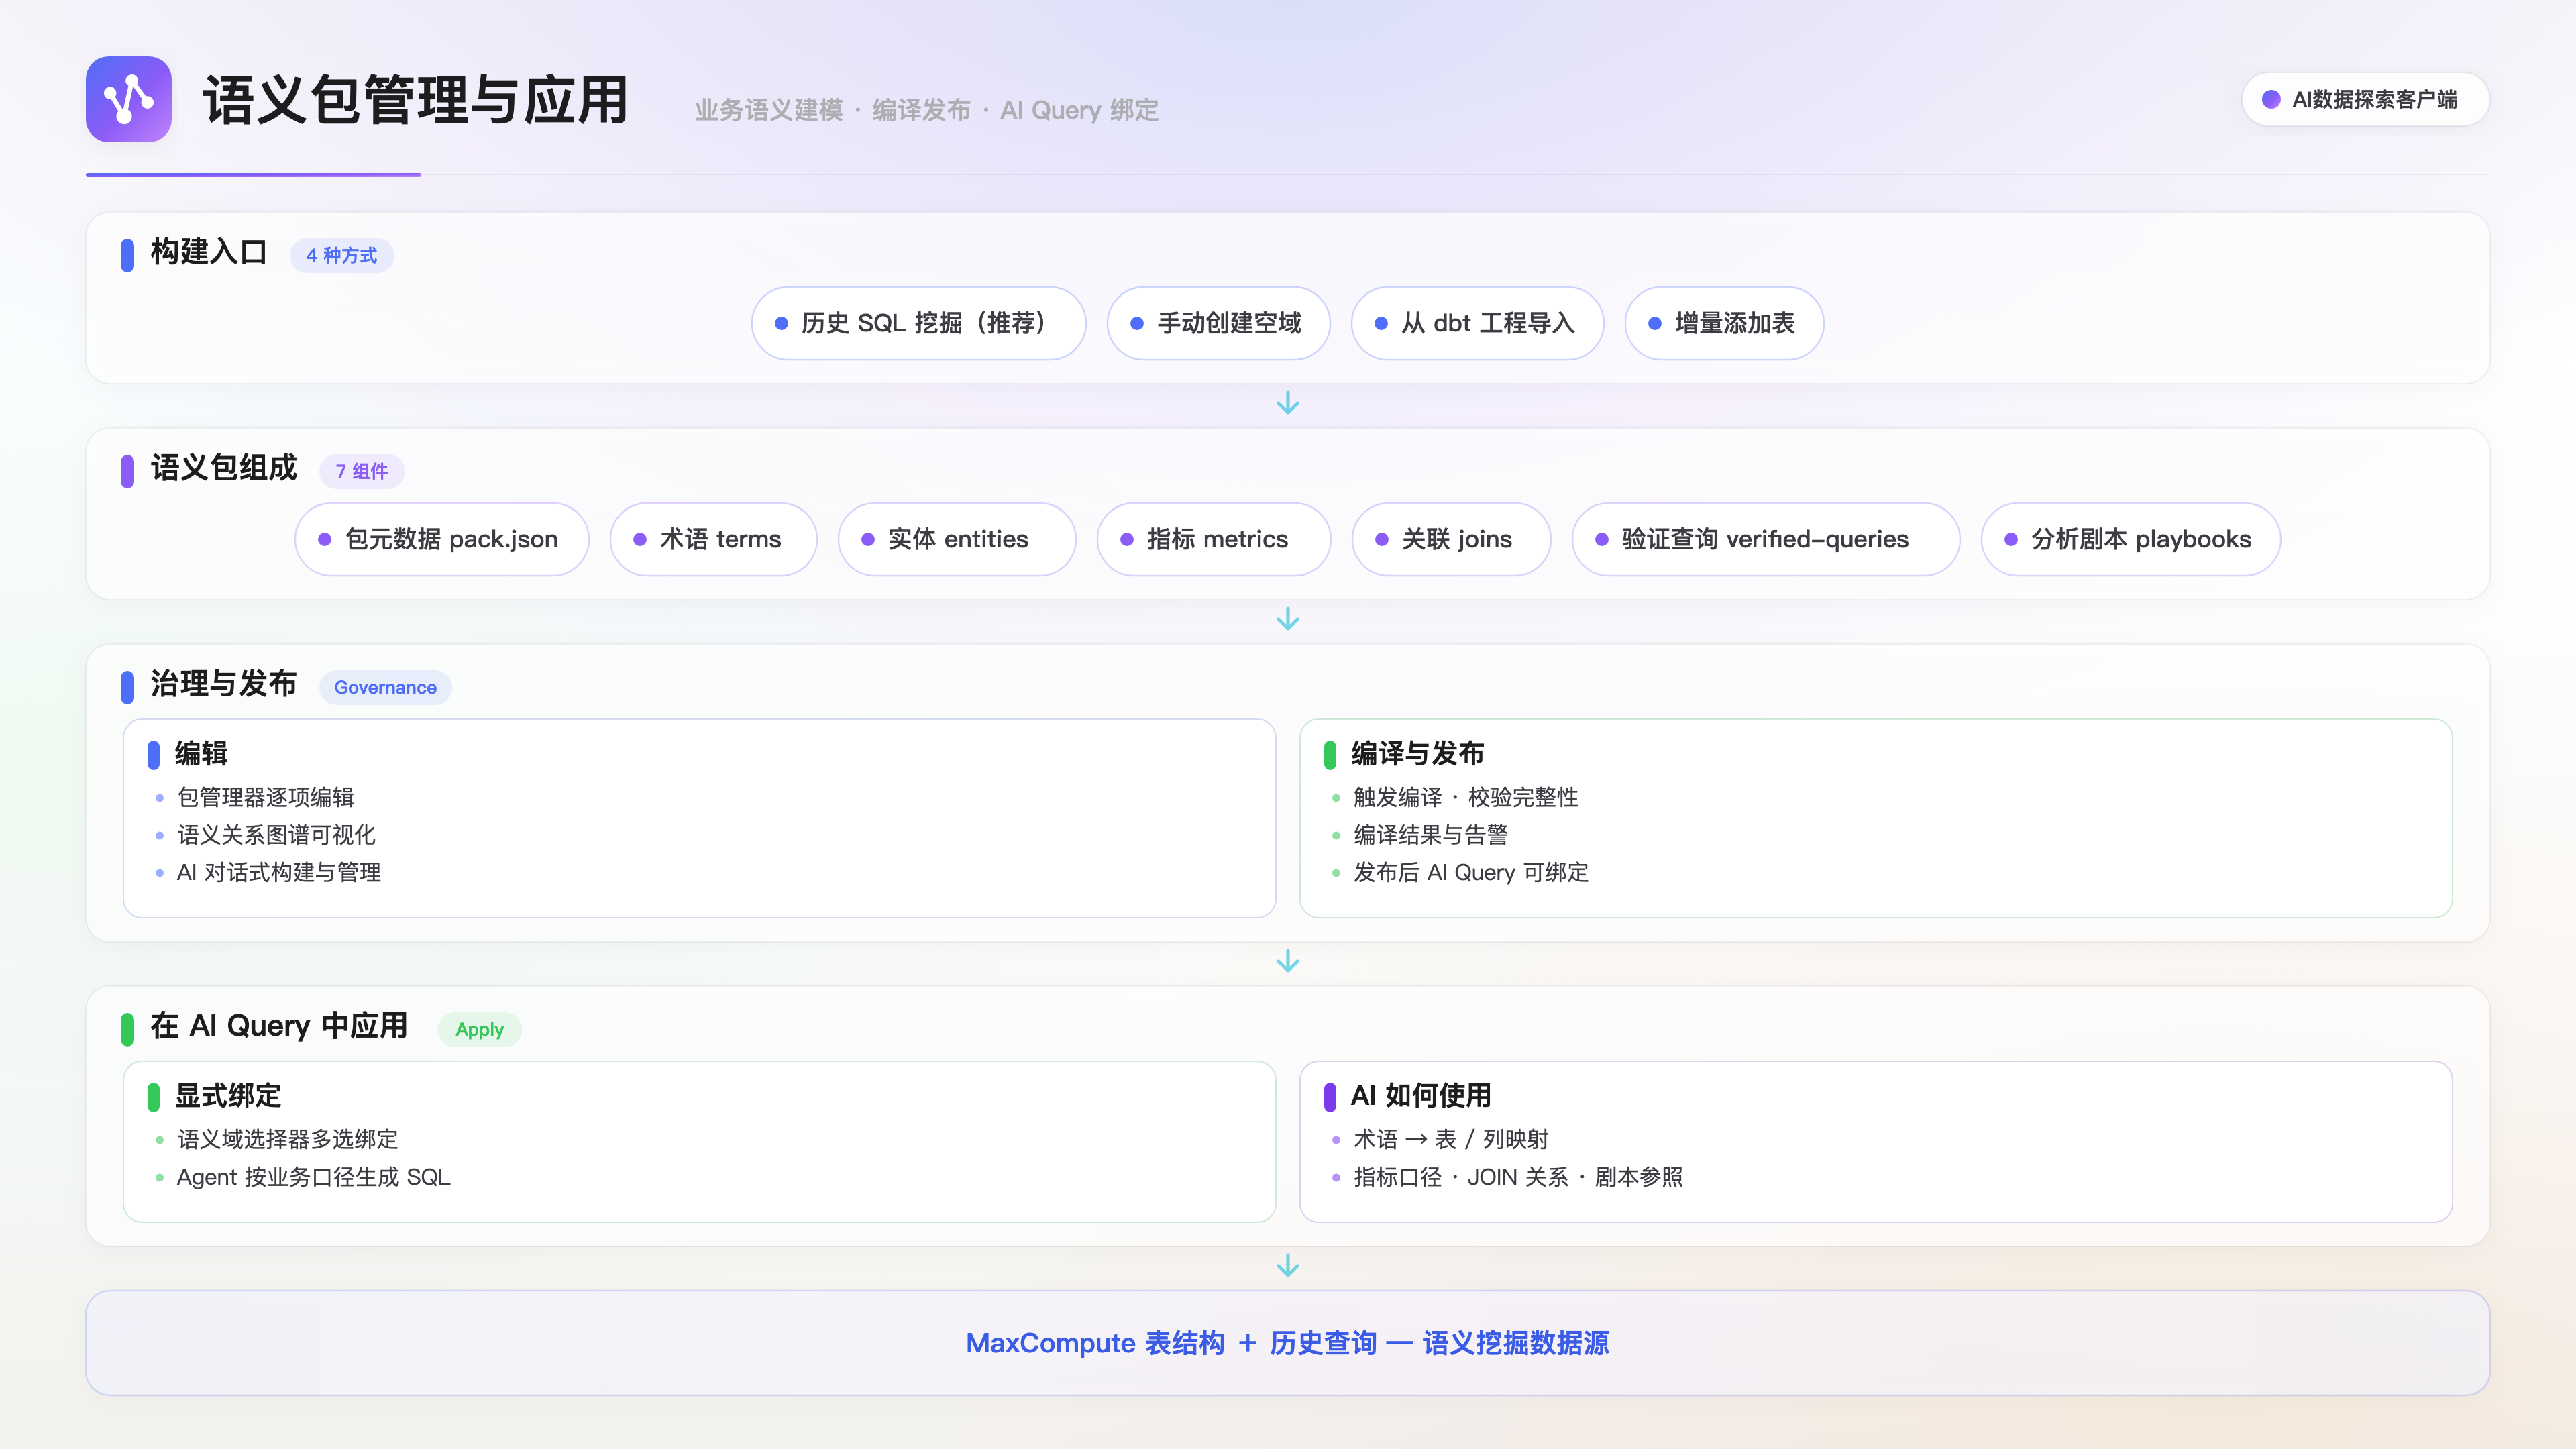
语义包(Semantic Pack)是一组描述数据资产业务含义的结构化文件。客户端从 MaxCompute 历史 SQL 中挖掘业务事实,经 LLM 增强后生成术语、实体、指标、关联等定义,编译为运行时索引供 AI Query 在生成 SQL 时参考。
每个语义包隶属于一个语义域(domain)。语义域是语义包的逻辑隔离单元,对应一个独立的文件目录,包含该领域的全部语义资产。可以为不同业务线或数据主题创建不同的域。
适用场景
提升 AI 问数准确率:在对话中绑定语义包后,AI 在规划 SQL 时能看到术语定义、指标口径、表间关联等知识,减少字段误用和口径偏差。
沉淀团队分析经验:把反复出现的维度命名、指标计算公式、常用 JOIN 条件固化下来,新成员无需重新探索。
验证 SQL 正确性:验证查询是经过人工确认的标准 SQL,AI 生成结果时可参照已有模式,降低幻觉。
功能索引
功能类别 | 功能项 |
创建与构建 | 从历史 SQL 挖掘构建、手动创建空域、dbt 导入、增量添加表 |
组件编辑 | 术语、实体、指标、关联、验证查询、分析剧本的增删改 |
编译与发布 | 编译为运行时索引、自动/手动编译、编译报告 |
可视化 | 语义关系图谱(实体/指标/术语/关联的拓扑视图) |
AI Query 应用 | 绑定语义包到会话、AI 自动引用语义知识生成 SQL |
AI 辅助构建 | 在 AI Query 对话中让 AI 创建/编辑/绑定语义包 |
前提条件
已创建并成功连接一个 MaxCompute 数据源,且已选定项目。
若使用「从历史 SQL 挖掘构建」功能,该项目需有一定量的历史查询记录(建议至少 7 天)。
快速入门
以下步骤从历史 SQL 构建一个语义包,并在 AI Query 中使用。
在侧边栏语义包分区,单击 +(新语义包)。
填写包名和描述,选择 1~3 张种子表,选择挖掘窗口(7 天或 14 天),单击开始构建。
等待挖掘完成(耗时取决于历史 SQL 量),客户端右侧栏展示构建进度。挖掘结束后弹出确认步骤:核对相关表和候选关联,单击确认并继续。
草稿生成完成后,选择是否启动 LLM 增强(补充描述与同义词),单击开始增强。
增强完成后进入审核,确认内容无误后单击发布。语义包自动编译进入运行时索引。
在 AI Query 对话中提问,AI 会自动绑定已发布的语义包并参考其中的术语与指标口径生成 SQL。
语义包的组成
一个语义包包含以下组件:
组件 | 文件 | 作用 |
包元数据 |
| 域名称、描述、关键词、默认表、默认指标与维度 |
术语 |
| 业务术语的中英文同义词与描述,帮助 AI 理解用户自然语言中的业务词汇 |
实体 |
| 数据实体(对应表),定义主键、描述、字段含义与接口 |
指标 |
| 业务指标的计算表达式、聚合方式、相关维度与同义词 |
关联 |
| 表与表之间的 JOIN 条件与连接类型 |
验证查询 |
| 经人工确认的标准 SQL,供 AI 参照模式 |
分析剧本 |
| 常见分析场景的步骤描述、所需表与首选指标 |
构建语义包
从历史 SQL 挖掘构建(推荐)
适用于项目已积累一定量历史查询的场景。构建过程分 5 个阶段:
准备 → 挖掘 → 草稿 → 增强 → 审核发布
准备:填写包名、域 ID(留空自动生成)、描述,选择种子表与挖掘窗口天数(2 / 7 / 14 天)。
挖掘:从 MaxCompute 历史 SQL 中扫描与种子表相关的查询,提取 JOIN 候选、指标候选和共现统计。挖掘完成后进入等待确认状态,用户核对相关表清单和候选关联。
草稿:基于确认后的表元数据与采样数据,生成术语、实体、指标、关联、验证查询等 8 类语义资产。
增强:LLM 在保留挖掘证据的前提下,补充描述、同义词、业务说明。用户可选择增强范围(全部或指定组件)。
审核发布:用户审核全部内容,确认后发布到运行时索引。
每个阶段执行完毕后,构建任务进入等待状态,需要用户确认后才继续下一阶段。构建进度在右侧栏的构建视图中实时显示。
构建是后台任务,可以切换到其他页面继续工作,回来后进度不丢失。
手动创建空域
在 AI Query 对话中告诉 AI「创建一个名为 xxx 的空语义包」,AI 会调用后端 API 创建一个空的语义域,随后可在编辑界面逐项添加术语、实体、指标等组件。适合已有明确语义定义、无需从历史 SQL 挖掘的场景。
从 dbt 工程导入
在 dbt 面板中单击导入语义包,可将 dbt 工程中的 semantic models 和 metrics 转换为语义包。详情参见dbt 与 MaxCompute 生态集成。
增量添加表
对已有语义包,可通过添加表操作追加新表。客户端读取该表的元数据和采样数据,为其生成实体定义、字段描述和关联候选。
编辑语义包
在侧边栏单击已有语义包打开编辑标签页。标签页内有两个子视图:
包管理器
以列表形式展示各组件(术语、实体、指标、关联、验证查询、分析剧本),支持:
添加条目:为任意组件添加新条目,填写对应字段。
编辑条目:修改已有条目的名称、描述、表达式、同义词等。
删除条目:删除不再需要的条目。
单组件增强:对指定组件调用 LLM 补充描述与同义词,不影响其他组件。
修改后需重新编译才能让 AI Query 使用最新内容。
语义关系图谱
以可视化方式展示包内各元素的关系:实体、指标、术语之间的引用与关联拓扑。便于从全局视角理解语义包的覆盖范围与结构完整性。
编译与发布
编译将语义包的各组件文件合并为一份运行时索引(index.json),供 AI Query 加载使用。
触发编译
保存时自动编译:在编辑标签页中保存修改时自动触发该域的编译。
发布时编译:构建任务的审核发布阶段自动触发。
删除后重编译:删除某个域后,客户端异步重编译剩余域。
AI 调用编译:在 AI Query 中说「编译 xxx 域」,AI 会调用编译动作。
编译结果
编译成功后,运行时索引即刻生效,下一轮 AI Query 对话即可使用。若编译发现问题(如字段引用不存在的表),会生成验证报告供用户排查。
侧边栏的语义包列表会区分两个分区:
已发布:编译通过、可正常使用的语义包。
异常/未编译:尚未编译或编译失败的语义包,需要处理后才能被 AI Query 引用。
在 AI Query 中使用语义包
显式绑定
AI Query 不会自动加载所有已编译的语义包。需要在对话中告诉 AI「使用 xxx 语义包」或「绑定 xxx 域」,AI 会调用绑定动作将指定域加入当前会话的语义上下文。绑定是会话级概念,仅影响当前对话。
绑定后,同一会话内的后续提问都会参考该语义包,无需每轮重复绑定。
AI 如何使用语义包
绑定后,AI 在每轮规划与执行时获得以下增强:
表结构预注入:语义包中定义的实体对应的表结构预加载到上下文,AI 无需额外查询元数据。
术语理解:用户说「客单价」,AI 通过术语同义词映射到对应的计算表达式。
指标口径:AI 生成聚合 SQL 时参考指标定义中的 expression 和 aggregationType,保证口径一致。
关联路径:多表查询时,AI 参考 joins 定义选择正确的 JOIN 条件,减少笛卡尔积风险。
验证查询参照:生成的 SQL 结构可参照验证查询中的已知模式,降低错误率。
用 AI 构建与管理语义包
在 AI Query 对话中,可以直接用自然语言让 AI 操作语义包。AI 支持以下动作:
查看:「列出所有语义包」「查看 sales 域的指标」。
绑定:「使用 ecommerce 语义包回答接下来的问题」。
构建:「为 sales_order 表创建一个新的语义包」——AI 会发起构建任务,右侧栏出现构建进度视图。
编辑:「给 sales 域添加一个指标:日均订单量 = COUNT(order_id) / DATEDIFF(...)」。
编译:「编译 sales 域」。
构建任务的每个决策点(确认表清单、是否增强、审核发布)都会暂停等待用户确认,AI 无法自行跳过。
删除语义包
在侧边栏语义包列表中选择目标域,单击删除。确认对话框中单击确认删除后,域目录被移除,客户端异步重编译剩余域的运行时索引。
删除操作不可撤销。若 AI Query 对话中正在使用该域,删除后当前会话的语义增强会立即失效。