
本文介绍Qwen-Audio-ASR-Filetrans非实时语音识别Python SDK的参数和接口细节。
关于支持的音频格式、文件大小限制、时长限制等输入要求,请参见音频规格。
前提条件
-
已开通服务并获取与配置 API Key。请配置API Key到环境变量,而非硬编码在代码中,防范因代码泄露导致的安全风险。
快速开始
以下示例使用 DashScope Python SDK 2.0。核心资源(client.audio.asr)提供任务提交、等待和查询接口,可通过以下两种方式调用:
- 异步提交任务+同步等待任务结束:提交任务后,阻塞当前线程直到任务结束并获取识别结果。
- 异步提交任务+异步查询任务执行结果:提交任务后,在需要的时候通过调用查询任务接口获取任务的执行结果。
异步提交任务+同步等待任务结束
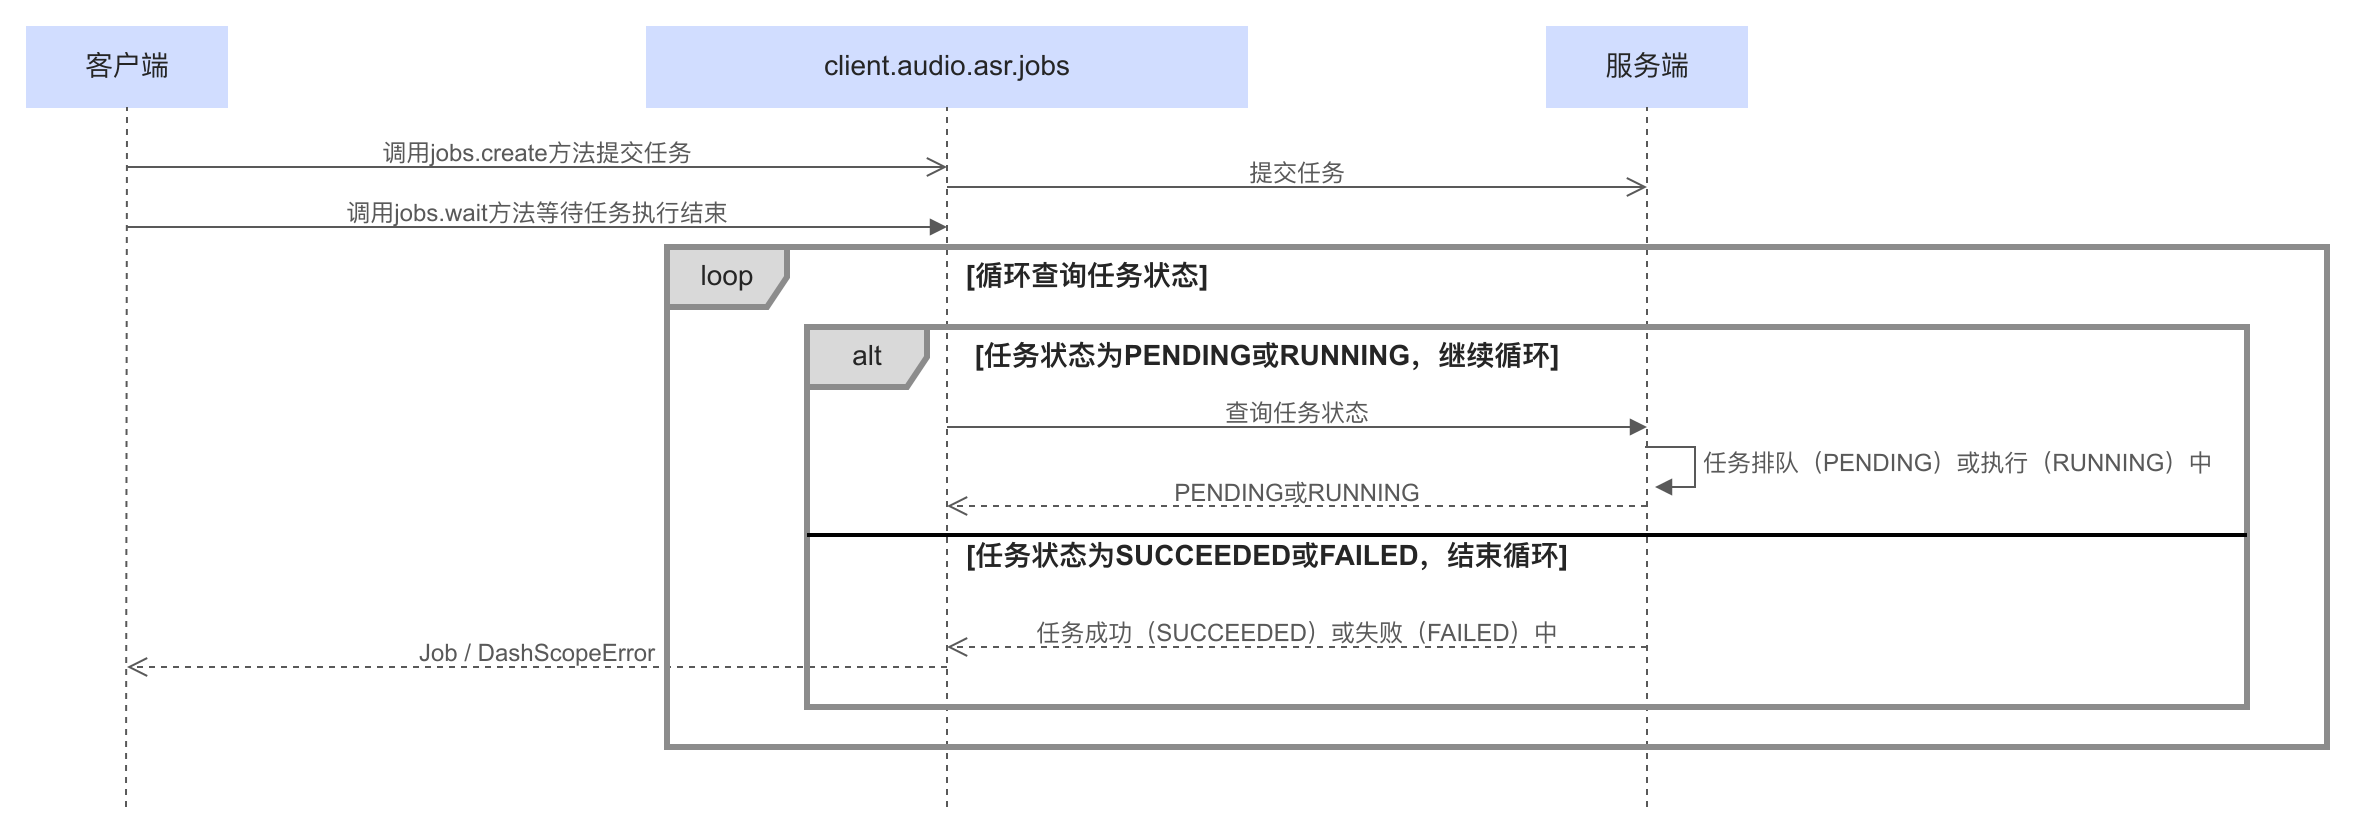
-
调用
client.audio.asr.jobs.create提交任务并设置请求参数。说明
- 文件转写服务对通过API提交的任务采取尽力服务原则进行处理。任务提交后将进入排队(
PENDING)状态,排队时间取决于队列长度和文件时长,无法明确给出,通常在数分钟内。任务开始处理后,语音识别将以数百倍加速完成。 - 每一个任务完成后,识别结果和URL下载链接有效期为24小时,超时后无法查询任务或通过先前查询结果中的URL下载结果。
- 文件转写服务对通过API提交的任务采取尽力服务原则进行处理。任务提交后将进入排队(
-
调用
client.audio.asr.jobs.wait(job=job)同步等待任务结束。任务处于
PENDING或RUNNING状态时,jobs.wait持续等待;任务成功后返回Job。接口返回
Job,可通过job.results获取结果列表,其中的transcription_url为转写结果下载地址。
import json
import os

import dashscope

# 将 {WorkspaceId} 替换为对应地域的真实业务空间 ID。
client = dashscope.Client(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    workspace="{WorkspaceId}",
    region="cn-beijing",
)

job = client.audio.asr.jobs.create(
    model="qwen-audio-3.1-asr-flash-filetrans",
    file_urls=["{YOUR_AUDIO_URL}"],
)

job = client.audio.asr.jobs.wait(job=job)

print(json.dumps(job.model_dump(), indent=4, ensure_ascii=False))
异步提交任务+异步查询任务执行结果
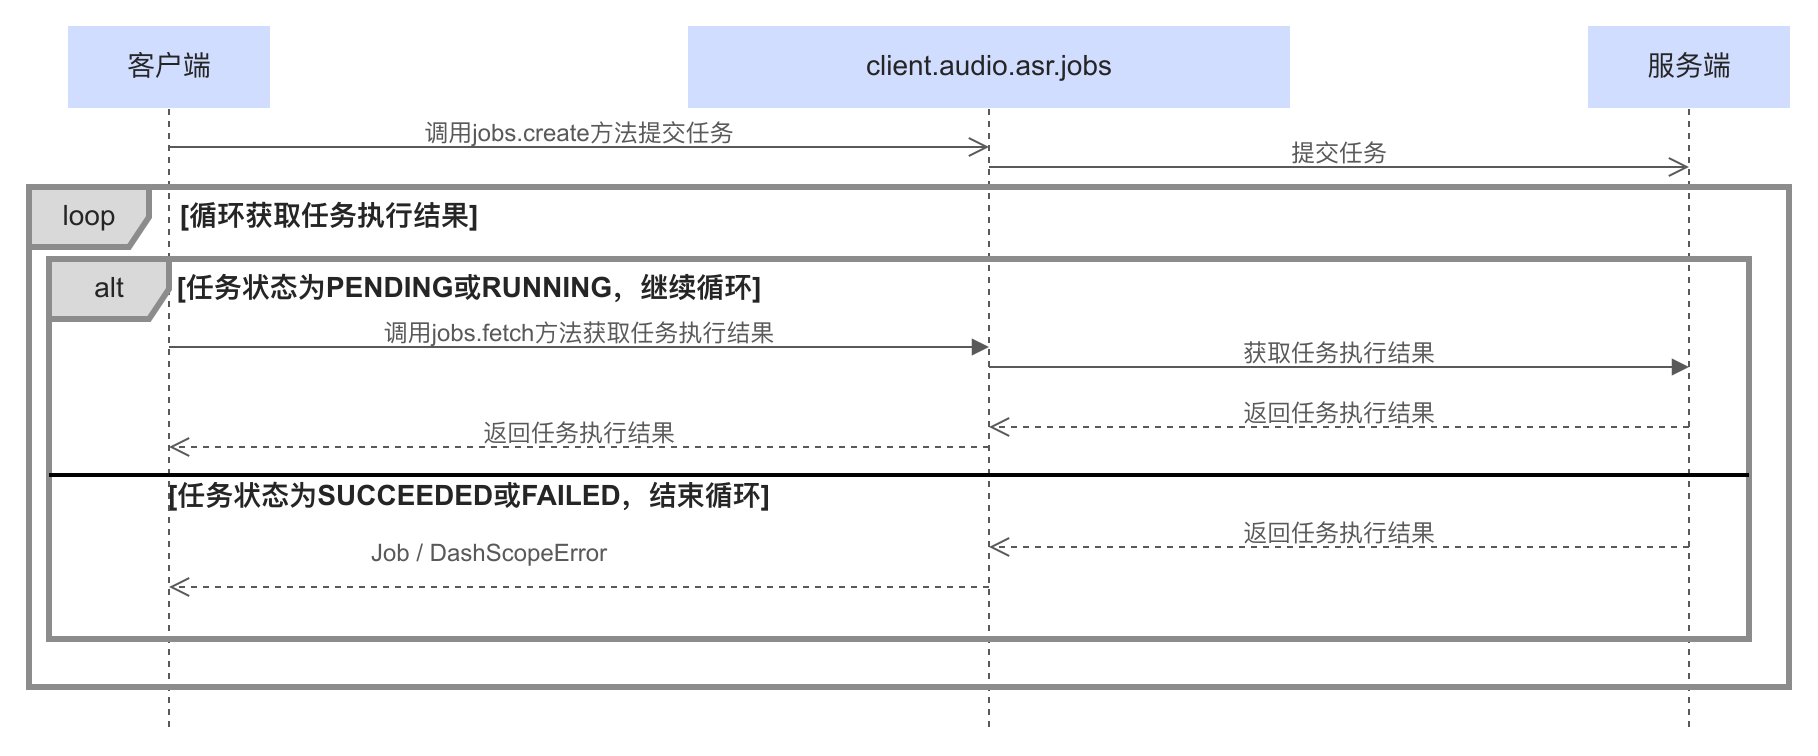
-
调用
client.audio.asr.jobs.create提交任务并设置请求参数。说明
- 文件转写服务对通过API提交的任务采取尽力服务原则进行处理。任务提交后将进入排队(
PENDING)状态,排队时间取决于队列长度和文件时长,无法明确给出,通常在数分钟内。任务开始处理后,语音识别将以数百倍加速完成。 - 每一个任务完成后,识别结果和URL下载链接有效期为24小时,超时后无法查询任务或通过先前查询结果中的URL下载结果。
- 文件转写服务对通过API提交的任务采取尽力服务原则进行处理。任务提交后将进入排队(
-
循环调用
client.audio.asr.jobs.fetch(task_id)查询任务,成功后读取结果。通过
job.status读取任务状态。本示例每隔 1 秒查询一次。接口返回
Job,可通过job.results获取结果列表,其中的transcription_url为转写结果下载地址。
import json
import os
import time

import dashscope

# 将 {WorkspaceId} 替换为对应地域的真实业务空间 ID。
client = dashscope.Client(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    workspace="{WorkspaceId}",
    region="cn-beijing",
)

job = client.audio.asr.jobs.create(
    model="qwen-audio-3.1-asr-flash-filetrans",
    file_urls=["{YOUR_AUDIO_URL}"],
)

while job.status in ("PENDING", "RUNNING"):
    time.sleep(1)
    job = client.audio.asr.jobs.fetch(task_id=job.task_id)

print(json.dumps(job.model_dump(), indent=4, ensure_ascii=False))
接口地址
SDK 默认使用北京地域。创建 dashscope.Client 时,通过 region 指定地域,通过 workspace 指定业务空间。地域配置仅作用于该 Client。
华北2(北京)
https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1
调用时请将{WorkspaceId}替换为真实的Workspace ID。
新加坡
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1
调用时请将{WorkspaceId}替换为真实的业务空间ID。
不同地域的 API Key 不同,请使用对应地域的 API Key。
请求参数
通过 client.audio.asr.transcribe 或 client.audio.asr.jobs.create 设置请求参数。
| 参数 | 类型 | 是否必须 | 说明 |
|---|---|---|---|
|
| 是 | 模型名称。 |
|
| 是 | 音视频文件转写的URL列表,支持HTTP / HTTPS协议,单次请求仅支持1个URL。关于支持的音频格式、文件大小限制、时长限制等输入要求,请参见音频规格。 若录音文件存储在阿里云OSS,使用RESTful API方式支持使用以 重要
|
|
| 否 | 仅 |
|
| 否 | 预编译热词列表 ID。 需预先调用创建热词列表接口生成,识别时传入该 ID 即可使用列表中的热词。 适用于词汇已知且相对稳定、需要跨请求复用同一词表的场景。 使用方法请参见预编译热词。 |
|
| 否 | 即时热词。 以键值对形式传入,键为热词文本( 适用于临时性、会话级别的热词优化。 与预编译热词同时配置时,系统会合并两类热词;合并后超过 2000 个时,随机选择 2000 个使用。使用方法请参见即时热词。 示例: 以下示例复用快速开始中已配置地域和业务空间的 |
|
| 否 | 指定在多音轨音频文件中需要识别的音轨索引,索引从 0 开始。例如,[0] 表示识别第一个音轨,[0, 1] 表示同时识别第一和第二个音轨。如果省略此参数,则默认处理第一个音轨。 重要指定的每一个音轨都将独立计费。例如,为单个文件请求 [0, 1] 会产生两笔独立的费用。 默认值:[0]。 |
|
| 否 | 指定在语音识别过程中需要处理的敏感词,并支持对不同敏感词设置不同的处理方式。详情请参见敏感词过滤。 |
|
| 否 | 是否启用说话人分离,默认关闭。 仅适用于单声道音频,多声道音频不支持说话人分离。 启用该功能后,识别结果中将显示 说明如果启用说话人分离功能,建议音频时长不超过2小时,否则可能导致识别失败或超时。 默认值:False。 有关 |
|
| 否 | 重要仅在开启说话人分离功能( 说话人数量参考值。取值范围为2至100的整数(包含2和100)。 默认自动判断说话人数量,如果配置此项,只能辅助算法尽量输出指定人数,无法保证一定会输出此人数。 无默认值。 |
|
| 否 | 设置待识别语言代码。如果无法提前确定语种,可不设置,模型会自动识别语种。 最多支持设置 4 个值,超出时仅前 4 个生效。 点击查看支持的语言代码
|
响应结果
Job
Job 封装任务信息、原始输出和用量信息。
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "PENDING",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": null,
    "finished_at": null,
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "PENDING",
        "submit_time": "2026-10-29 10:00:00.000"
    },
    "usage": null
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "RUNNING",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": null,
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "RUNNING",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100"
    },
    "usage": null
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "SUCCEEDED",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": "2026-10-29 10:00:01.000",
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "SUCCEEDED",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100",
        "end_time": "2026-10-29 10:00:01.000",
        "results": [
            {
                "file_url": "{YOUR_AUDIO_URL}",
                "transcription_url": "{TRANSCRIPTION_URL}",
                "subtask_status": "SUCCEEDED"
            }
        ]
    },
    "usage": {
        "duration": 1,
        "total_tokens": 25,
        "output_tokens": 4,
        "input_tokens": 21
    }
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "FAILED",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": "2026-10-29 10:00:01.000",
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "FAILED",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100",
        "end_time": "2026-10-29 10:00:01.000",
        "code": "SERVER_ERROR",
        "file_url": "{YOUR_AUDIO_URL}",
        "subtask_status": "FAILED",
        "results": [
            {
                "file_url": "{YOUR_AUDIO_URL}",
                "subtask_status": "FAILED",
                "results": []
            }
        ]
    },
    "usage": null
}
字段 | 说明 |
|---|---|
| 任务 ID。 |
| 任务状态: |
| 提交时间,对应 |
| 开始处理时间,对应 |
| 结束时间,对应 |
| 原始任务输出字典。 |
| 子任务结果列表,可通过 |
| 任务用量信息。 |
Job.output
job.output 是服务端返回的原始任务输出字典。
PENDING
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "PENDING",
    "submit_time": "2026-10-29 10:00:00.000"
}
RUNNING
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "RUNNING",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100"
}
SUCCEEDED
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "SUCCEEDED",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100",
    "end_time": "2026-10-29 10:00:01.000",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "transcription_url": "{TRANSCRIPTION_URL}",
            "subtask_status": "SUCCEEDED"
        }
    ]
}
FAILED (raise_on_error=False)
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "FAILED",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100",
    "end_time": "2026-10-29 10:00:01.000",
    "code": "SERVER_ERROR",
    "file_url": "{YOUR_AUDIO_URL}",
    "subtask_status": "FAILED",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "subtask_status": "FAILED",
            "results": []
        }
    ]
}
| 参数 | 说明 |
|---|---|
| 代表错误码。可以结合 |
| 代表错误信息。可以结合 |
| 任务ID。 |
| 任务状态。 有 当任务包含多个子任务时,只要存在任一子任务成功,整个任务状态将标记为 |
| 子任务识别结果。 |
| 子任务状态。 有 |
| 被识别音频的URL。 |
| 音频识别结果对应的URL。 识别结果以JSON格式保存在一个JSON文件中,您可以通过 |
识别结果说明
识别结果保存为JSON文件。
{
    "file_url":"{YOUR_AUDIO_URL}",
    "properties":{
        "audio_format":"pcm_s16le",
        "channels":[
            0
        ],
        "original_sampling_rate":16000,
        "original_duration_in_milliseconds":3834
    },
    "transcripts":[
        {
            "channel_id":0,
            "content_duration_in_milliseconds":3720,
            "text":"Hello world, 这里是阿里巴巴语音实验室。",
            "sentences":[
                {
                    "begin_time":100,
                    "end_time":3820,
                    "text":"Hello world, 这里是阿里巴巴语音实验室。",
                    "sentence_id":1,
                    "speaker_id":0, //当开启自动说话人分离功能时才会显示该字段
                    "words":[
                        {
                            "begin_time":100,
                            "end_time":596,
                            "text":"Hello ",
                            "punctuation":""
                        },
                        {
                            "begin_time":596,
                            "end_time":844,
                            "text":"world",
                            "punctuation":", "
                        }
                        // 这里省略其它内容
                    ]
                }
            ]
        }
    ]
}
需要关注的参数如下:
| 参数 | 类型 | 说明 |
|---|---|---|
|
| 源文件中音频的格式。 |
| array[integer] | 源文件中音频的音轨索引信息,对单轨音频返回[0],对双轨音频返回[0, 1],以此类推。 |
|
| 源文件中音频的采样率(Hz)。 |
|
| 源文件中的原始音频时长(ms)。 |
|
| 转写结果的音轨索引,以0为起始。 |
|
| 音轨中被判定为语音内容的时长(ms)。 说明以下计费说明适用于 语音识别模型服务仅对音轨中被判定为语音内容的时长进行语音转写,并据此进行计量计费,非语音内容不计量、不计费。通常情况下语音内容时长会短于原始音频时长。由于对是否存在语音内容的判定是由AI模型给出的,可能与实际情况存在一定误差。 |
|
| 段落级别的语音转写结果。 |
|
| 句子级别的语音转写结果。 |
|
| 词级别的语音转写结果。 |
|
| 开始时间戳(ms)。 |
|
| 结束时间戳(ms)。 |
|
| 语音转写结果。 |
|
| 当前说话人的索引,以0为起始,用于区分不同的说话人。 仅在启用说话人分离功能时,该字段才会显示于识别结果中。 |
|
| 预测出的词之后的标点符号(如有)。 |
关键接口
核心资源(client.audio.asr)
通过 dashscope.Client 创建客户端后,使用 client.audio.asr 资源。以下方法均返回 Job。
方法 | 方法签名 | 说明 |
|---|---|---|
| | 提交任务并同步等待完成。默认模型为 |
| | 提交任务,返回包含 |
| | 传入 |
| | 通过任务 ID 查询一次任务状态和结果,不阻塞等待任务完成。 |
其他接口:批量查询任务状态/取消任务
详情请参见管理异步任务:支持批量查询24小时内提交的非实时语音识别任务,同时支持取消PENDING(排队)状态的任务。
错误码
任务失败时,默认抛出 DashScopeError。如需获取失败任务的 Job,在创建 Client 时设置 raise_on_error=False,并检查 job.status。
如遇报错问题,请参见错误码进行排查。
当任务包含多个子任务时,只要存在任一子任务成功,整个任务状态将标记为SUCCEEDED,需通过subtask_status字段判断具体子任务结果。
错误返回示例:
{
    "task_id": "7bac899c-06ec-4a79-8875-xxxxxxxxxxxx",
    "task_status": "SUCCEEDED",
    "submit_time": "2024-12-16 16:30:59.170",
    "scheduled_time": "2024-12-16 16:30:59.204",
    "end_time": "2024-12-16 16:31:02.375",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "code": "FILE_DOWNLOAD_FAILED",
            "message": "The audio file cannot be downloaded.",
            "subtask_status": "FAILED"
        }
    ],
    "task_metrics": {
        "TOTAL": 1,
        "SUCCEEDED": 0,
        "FAILED": 1
    }
}
常见问题
功能特性
Q:是否支持Base64编码方式的音频?
不支持Base64编码方式的音频。仅支持可通过公网访问的 URL 所指向的音频的识别,不支持识别二进制流,也不支持直接识别本地文件。
Q:如何将音频文件以公网可访问的URL形式提供?
通常遵循以下几个步骤(这里为您提供一种思路,具体情况因不同存储产品而异,推荐将音频上传至阿里云OSS):
1、选择存储和托管方式
如以下这几种:
-
对象存储服务(推荐):
- 使用云服务商的对象存储服务(如阿里云OSS),将音频文件上传到存储桶中,并设置为公开访问。
- 优点:高可用性、支持 CDN 加速、易于管理。
-
Web 服务器:
- 将音频文件放置在支持 HTTP/HTTPS 访问的 Web 服务器上(如 Nginx、Apache)。
- 优点:适合小型项目或本地测试。
-
内容分发网络(CDN):
- 将音频文件托管在 CDN 上,通过 CDN 提供的 URL 访问。
- 优点:加速文件传输,适合高并发场景。
2、上传音频文件
根据选择的存储/托管方式,将音频上传,如:
-
对象存储服务:
- 登录云服务商的控制台,创建存储桶。
- 上传音频文件,并设置文件权限为“公共读”或生成临时访问链接。
-
Web 服务器:
- 将音频文件放置在服务器指定目录下(如
/var/www/html/audio/)。 - 确保文件可以通过 HTTP/HTTPS 访问。
- 将音频文件放置在服务器指定目录下(如
3、生成公网可访问的URL
例如:
-
对象存储服务:
- 文件上传后,系统会自动生成一个公网访问 URL(通常格式为
https://<bucket-name>.<region>.aliyuncs.com/<file-name>)。 - 如果需要更友好的域名,可以绑定自定义域名并开启 HTTPS。
- 文件上传后,系统会自动生成一个公网访问 URL(通常格式为
-
Web 服务器:
- 文件的访问 URL 通常是服务器地址加上文件路径(如
https://your-domain.com/audio/file.mp3)。
- 文件的访问 URL 通常是服务器地址加上文件路径(如
-
CDN:
- 配置 CDN 加速后,使用 CDN 提供的 URL(如
https://cdn.your-domain.com/audio/file.mp3)。
- 配置 CDN 加速后,使用 CDN 提供的 URL(如
4、验证URL的可用性
公网环境下,确保生成的 URL 可以正常访问,例如:
- 在浏览器中打开 URL,检查是否能播放音频文件。
- 使用工具(如
curl或 Postman)验证 URL 是否返回正确的 HTTP 响应(状态码 200)。
使用SDK时,若录音文件存储在阿里云OSS,不支持使用以 oss://为前缀的临时 URL。
使用RESTful API时,若录音文件存储在阿里云OSS,支持使用以 oss://为前缀的临时 URL:
重要
- 临时 URL 有效期48小时,过期后无法使用,请勿用于生产环境。
- 文件上传凭证接口限流为 100 QPS 且不支持扩容,请勿用于生产环境、高并发及压测场景。
- 生产环境建议使用阿里云OSS 等稳定存储,确保文件长期可用并规避限流问题。
Q:多久能获取识别结果?
任务提交后将进入排队(PENDING)状态,排队时间取决于队列长度和文件时长,无法明确给出,通常在数分钟内,请耐心等待。并且音频时长越长,所需时间越久。
故障排查
如遇代码报错问题,请根据错误码中的信息进行排查。
Q:一直轮询不到结果?
可能是限流原因,请耐心等待。
Q:无法识别语音(无识别结果)是什么原因?
请检查音频格式和采样率是否正确且符合参数约束。
可以使用ffprobe工具获取音频的容器、编码、采样率、声道等信息:
ffprobe -v error -show_entries format=format_name -show_entries stream=codec_name,sample_rate,channels -of default=noprint_wrappers=1 input.xxx