PolarDB PostgreSQL版的向量检索基于 pgvector 深度优化,支持 PQ、SQ4、SQ8、RaBitQ 等多种量化算法。通过量化技术,可以在降低内存消耗的同时保证召回率,提升检索性能。
适用范围
支持的 PolarDB PostgreSQL版的版本如下:
PostgreSQL 14(内核小版本 2.0.14.20.44.0 及以上)
PostgreSQL 16(内核小版本 2.0.16.13.16.0 及以上)
PostgreSQL 17(内核小版本 2.0.17.9.6.0 及以上)
PostgreSQL 18(内核小版本 2.0.18.3.2.0 及以上)
背景信息
全精度向量的每个维度均需 4 字节。在高维向量场景中,向量索引会消耗大量内存,不仅成本较高,还更容易出现缓存失效并影响性能。量化技术将原始精度的向量压缩为更紧凑的编码,再结合自动重排、随机旋转和 ADC 等优化技术,可在降低内存消耗的同时维持召回率并提升检索性能。
使用方式
支持 PQ、SQ4、SQ8、RaBitQ 四种量化算法,其中 RaBitQ 支持 1-bit、4-bit 和 8-bit 三种位宽。目前仅支持 HNSW 算法,IVF 算法将陆续支持。量化功能仅支持
vector(全精度浮点)数据类型。量化算法通过
WITH (quantization = pq/sq4/sq8/rabitq)开启并指定量化算法,对于 RaBitQ,通过quantization_nbits指定位宽。量化索引支持 L2、内积和余弦三种距离度量,不支持 L1 距离。
各量化算法的关键参数如下表所示。
算法
每维精度
压缩率
最大支持维度
附加限制
SQ8
8 bit
4 倍
8,000
无
SQ4
4 bit
8 倍
16,000
无
PQ
8 bit/子向量
dim/pq_m倍16,000
向量维度必须是
pq_m的整数倍,且大于pq_mRaBitQ 1-bit
1 bit
32 倍
16,000
向量维度必须是 8 的整数倍
RaBitQ 4-bit
4 bit
8 倍
16,000
向量维度必须是 8 的整数倍
RaBitQ 8-bit
8 bit
4 倍
8,000
向量维度必须是 8 的整数倍
RaBitQ
RaBitQ 先将数据向量中心化,再使用快速 Walsh-Hadamard 变换(FWHT)结合随机符号翻转实现随机正交旋转,随后按指定的位宽量化每个维度。随机正交旋转使向量信息更均匀地分布在各维度中,因此在相同压缩率下,RaBitQ 的量化误差分布更稳定,通常能获得比同尺寸标量量化更高的召回率。
RaBitQ 支持 1-bit、4-bit 和 8-bit 三种位宽,通过索引参数 quantization_nbits 指定,默认值为 1。
1-bit:每维仅存储符号位,压缩率为 32 倍,编码最紧凑;量化误差较大,建议配合重排使用。
4-bit:压缩率为 8 倍,是压缩率与检索精度之间的折中选择。
8-bit:压缩率为 4 倍,编码尺寸与 SQ8 相同;在相同压缩率下,召回率通常优于 SQ8。
最大支持维度:1-bit 和 4-bit 为 16,000;8-bit 为 8,000。
限制:向量维度必须是 8 的整数倍,例如 128、256、512 或 1024,以满足字节对齐的二进制编码要求。
注意:
quantization_nbits是索引的物理格式参数。创建索引后,如需修改该参数,必须重建索引(REINDEX)。
-- 1-bit(默认)
CREATE INDEX ON vecs USING hnsw(embedding vector_cosine_ops) WITH (m=16, ef_construction=256, quantization=rabitq, train_samples=5000);

-- 4-bit
CREATE INDEX ON vecs USING hnsw(embedding vector_cosine_ops) WITH (m=16, ef_construction=256, quantization=rabitq, quantization_nbits=4, train_samples=5000);

-- 8-bit
CREATE INDEX ON vecs USING hnsw(embedding vector_cosine_ops) WITH (m=16, ef_construction=256, quantization=rabitq, quantization_nbits=8, train_samples=5000);SQ4和SQ8
SQ 量化算法将向量的每个维度压缩为 4 bit 或 8 bit 存储,压缩率分别为 8 倍和 4 倍。
SQ8:最大支持 8,000 维。
SQ4:最大支持 16,000 维。
CREATE INDEX ON vecs USING hnsw(embedding vector_cosine_ops) WITH (m=16, ef_construction=256, quantization=sq4, train_samples=5000);
CREATE INDEX ON vecs USING hnsw(embedding vector_cosine_ops) WITH (m=16, ef_construction=256, quantization=sq8, train_samples=5000);
PQ
PQ 量化算法将原始向量分割为 pq_m 个子向量,对每组子向量独立完成 K-means 聚类并学习各自的码本(codebook)。每个子向量固定使用 1 字节存储。例如,对于 1024 维全精度向量,pq_m = 128 表示压缩率为 8 倍。pq_m 参数决定压缩率和精度之间的平衡:pq_m 越小,压缩率越高,但精度损失越大。
最大支持维度:16,000。
限制:向量维度必须是
pq_m的整数倍,且大于pq_m。
CREATE INDEX ON vecs USING hnsw(embedding vector_cosine_ops) WITH (m=16, ef_construction=256, quantization=pq, pq_m=128, train_samples=5000);适用场景
场景 | 场景特点 | 推荐配置 |
大规模 RAG/知识库检索 | 768~4096 维文本嵌入,数据量大,索引内存与缓存命中率敏感 | RaBitQ 8-bit 或 SQ8 |
高 QPS 在线检索 | 延迟要求严格,目标召回率为 95%~98% | RaBitQ 8-bit 或 SQ8,配合默认开启的批量距离计算 |
超大规模、成本优先 | 十亿级以上数据,可接受少量召回率损失,或链路中已有外部精排模型 | RaBitQ 4-bit 或 1-bit,并开启重排 |
内存极度紧张 | 索引必须尽量完整地保留在内存中 | RaBitQ 1-bit,适当扩大候选集并开启重排 |
超高维向量(超过 8,000 维) | SQ8 和 RaBitQ 8-bit 超出维度上限 | SQ4、RaBitQ 4-bit 或 RaBitQ 1-bit,最大支持 16,000 维 |
需要连续调节压缩率 | 希望通过子向量数量精细控制编码大小 | PQ,调节 |
所有量化算法的量化参数(PQ 码本、SQ 量化范围、RaBitQ 中心点)均在建索引时基于采样数据训练,采样量由 train_samples 控制。建议在导入具有代表性的数据后再创建索引;后续写入不会自动重新训练这些参数,数据分布发生显著变化时应重建索引。
重排
不同的量化算法在降低内存占用的同时,相对于量化前的全精度原始向量均会带来一定精度损失。内核自动重排会在量化向量索引召回候选集后,访问表中的全精度向量数据,重新计算相似度并排序,从而提高召回率。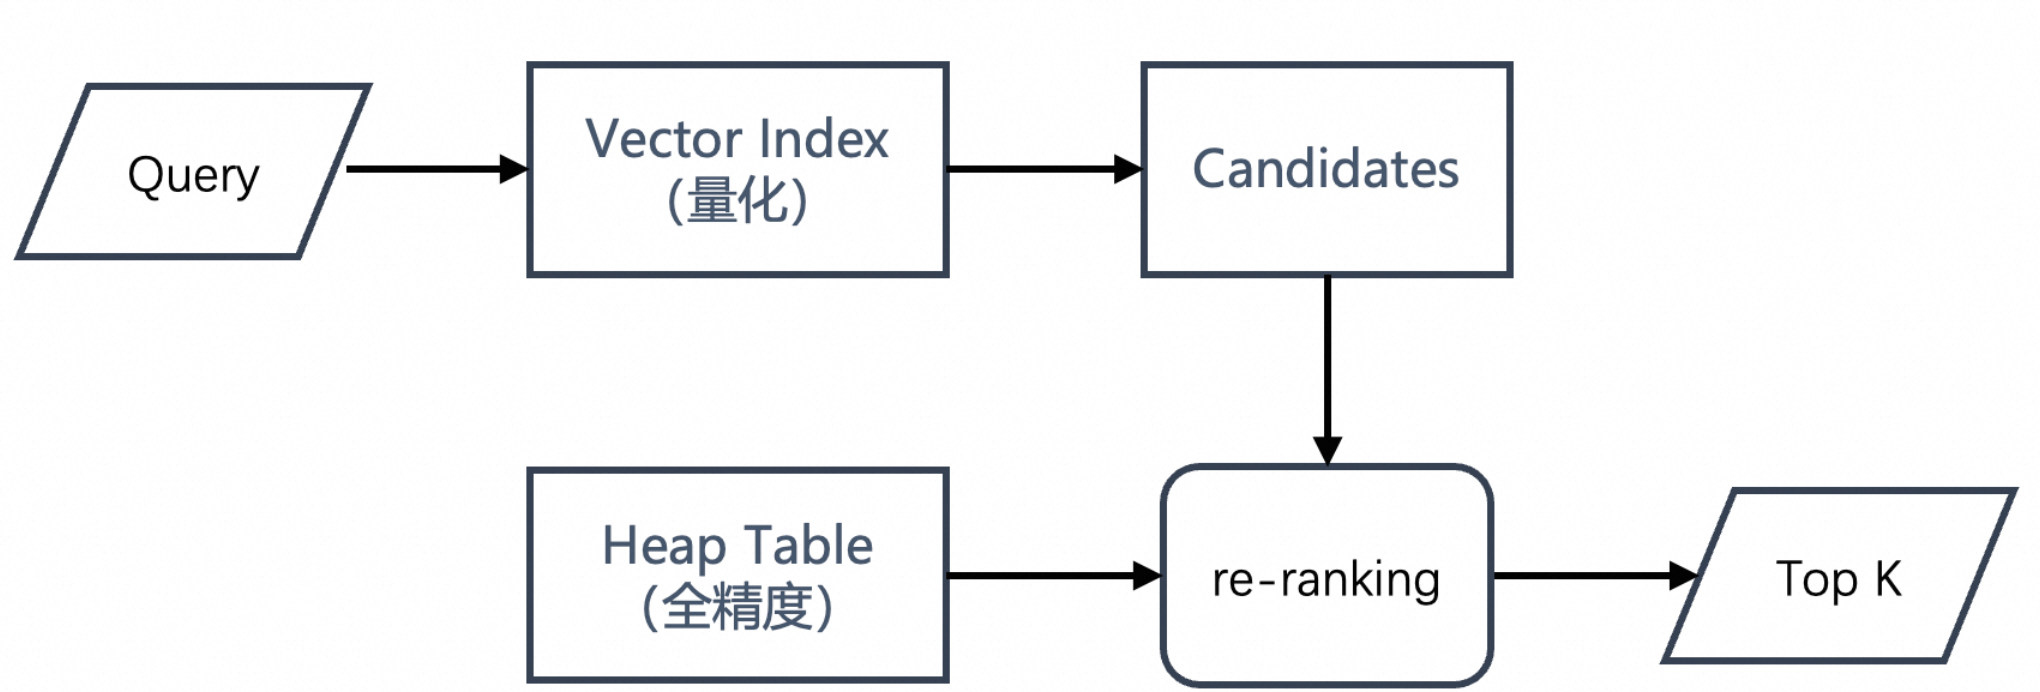
低精度量化需要重排对齐精度
量化位宽越低,编码携带的信息越少,基于编码估算的距离与真实距离的偏差越大,直接检索的召回率下降也越明显。
RaBitQ 1-bit 和 4-bit、SQ4,以及
pq_m较小的 PQ 等低精度量化,必须开启重排,才能将召回率对齐到接近全精度索引的水平。RaBitQ 8-bit 和 SQ8 等高精度量化的误差较小,默认即可达到较高召回率;是否开启重排取决于业务的召回目标,可关闭重排以换取性能,也可仅使用较小的
k_factor。
重排对性能的影响
重排时,每次查询需要回表读取 hnsw.rerank_k_factor × hnsw.ef_search 个候选的全精度向量,并重新计算精确距离。这会引入额外的堆表随机 I/O 和 CPU 开销,查询延迟随 k_factor 增大而上升。量化算法已大幅优化向量索引检索过程,即使开启重排仍可获得较好性能;但容量规划时应将这部分开销计入评估。
低精度量化场景:开启重排,从
k_factor = 2.0开始,并根据实测召回率和延迟权衡调整。高精度量化场景(RaBitQ 8-bit 和 SQ8):默认关闭重排;确需更高召回率时再开启,并使用较小的
k_factor。避免同时使用过大的
ef_search和k_factor,两者相乘决定回表候选数量。
参数设置
SET hnsw.enable_rerank = on;
SET hnsw.rerank_k_factor = 2.0;
参数 | 默认值 | 说明 |
| off | 是否开启重排。请根据量化精度和业务召回目标选择。 |
| 2.0(范围 1.0~100.0) | 候选扩展系数。索引检索阶段返回 |
选择建议
业务目标 | 索引类型推荐 | rerank 建议 | 验证方向 | 主要代价 |
默认选择:召回率、性能和内存兼顾 | RaBitQ 8-bit(新内核版本)或 SQ8(旧内核版本) | 不建议开启:8-bit 量化误差已非常小,rerank 性能影响大而收益有限。 | 调整 | 存在非常小幅的误差。 |
高召回要求,或 8-bit 量化召回不足 | 半精度 HNSW FP16 | 不适用(非量化路径) | 调整 | 维度最高支持 4000 维,且运行时所需内存占用比较高。 |
内存成本优先,同时兼顾一定召回率 | RaBitQ 4-bit / SQ4 | 视情况:先不开启rerank测试,召回能接受即不需要。不达标再开启(需对比测试) | 联合调整 |
|
极限压缩或可接受低召回 | RaBitQ 1-bit / PQ | 必须开启,否则召回大概率非常差 | 联合调整 | 不开 |
维度 >4,000(全精/半精度索引不支持) | 必须开量化,默认推荐 RaBitQ | 同上 | 同上 | 同上 |
先定义约束:TopK、目标 Recall@K、QPS、延迟 P50/P95/P99、内存预算、索引大小和向量维度。
再按选型表选起始索引(默认 RaBitQ 8-bit/SQ8,维度超 4,000 必须量化),先调
hnsw.ef_search,再按位宽决定rerank(8-bit 不开、4-bit 按需、1-bit 必开)。若召回与性能仍不能同时达标则换档重验:召回不足升精度(最高半精度 FP16),成本超预算降精度并用rerank进行补偿。
效果
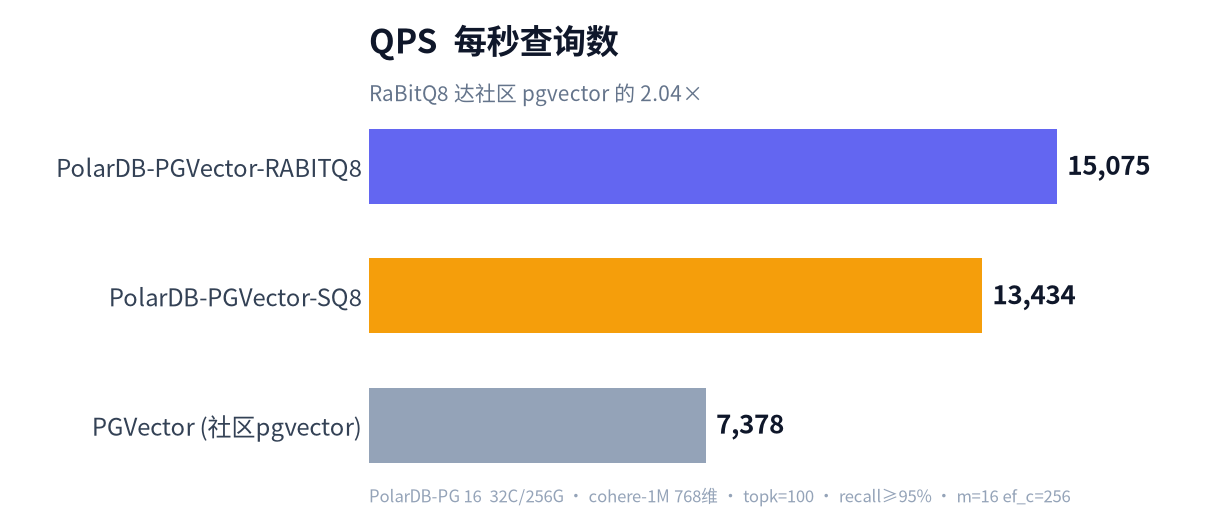
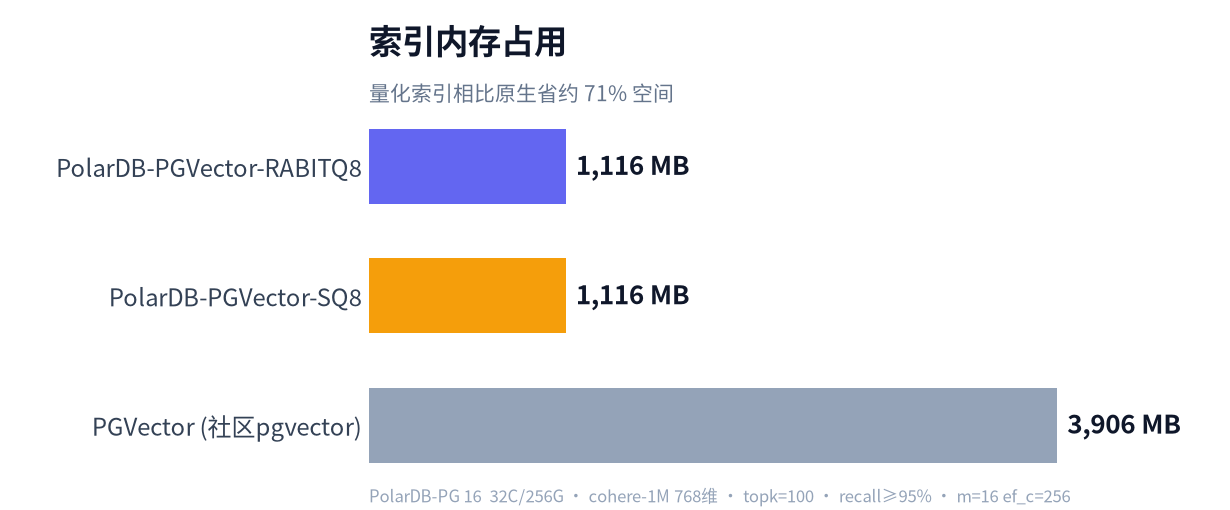
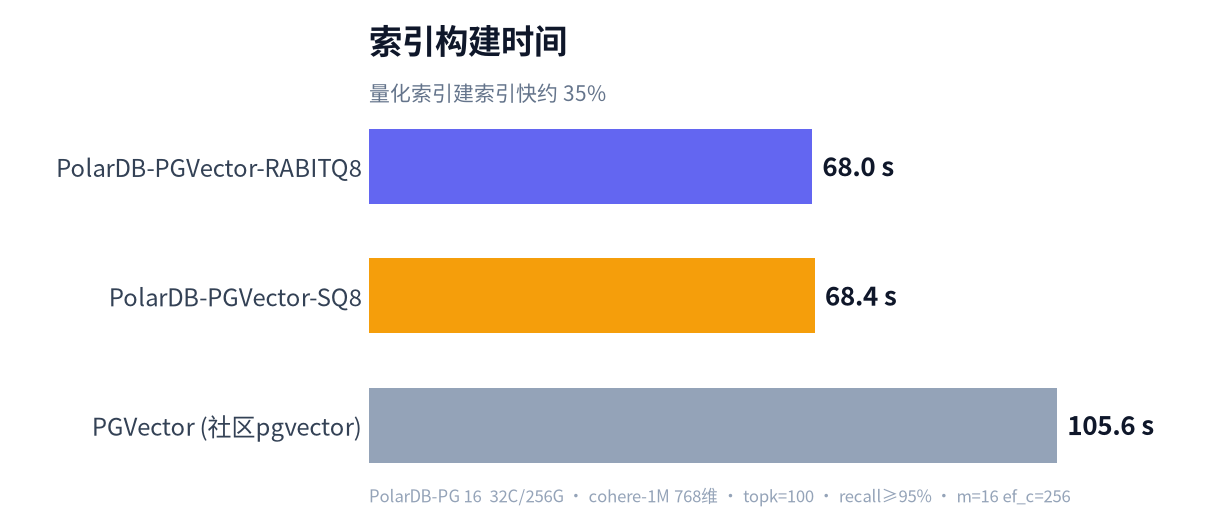
以 Cohere 1M 为例,在召回率均 ≥95% 且均使用 HNSW 索引的前提下,Vector-SQ8 和 Vector-RaBitQ 8-bit 相比社区原生 PGVector:
索引内存由约 3.9 GB 降至约 1.1 GB,节省约 71%。
查询 QPS 分别提升约 1.8 倍和 2.0 倍。
建索引速度提升约 35%。
RaBitQ 8-bit 在相同压缩率下的召回率与吞吐均略优于 SQ8,建议结合业务数据实测后再选型。