
方案概述
本方案适用于大数据开发人员快速获得可用 Spark 环境,用于数据处理、交互式查询和机器学习的场景。
什么是Apache Spark
Apache Spark 是专为大规模数据处理设计的通用计算引擎,以 Scala 作为应用程序框架,依托内存分布式数据集,支持交互式查询与迭代计算负载。
本模板安装的软件版本如下:
组件 | 说明 | 版本 |
JDK(Java Development Kit) | Java 运行环境 | 1.8.0 |
Hadoop | 分布式系统基础架构,提供 HDFS 分布式存储 | 2.7.7 |
Scala | 编程语言,Spark 核心框架基于 Scala 开发 | 2.12.1 |
Spark | 通用大数据计算引擎,支持 SQL 查询、流处理、机器学习 | 2.1.0 |
本方案的特点:基于已有VPC部署
与其他 ROS 部署方案不同,本模板要求使用已有的专有网络、交换机和安全组,不会新建网络资源。这种设计适用于:
已有标准化网络环境,需要在现有专有网络中补充 Spark 服务。
多个项目共享一个专有网络,需要避免重复创建网络资源。
创建的资源清单
序号 | 资源名称 | ROS 资源类型 | 用途说明 |
1 | ECS 云服务器实例 |
| 运行 Spark 单机版的计算节点 |
2 | 弹性公网 IP(EIP) |
| 为 ECS 实例提供公网访问入口 |
3 | EIP 绑定关联 |
| 将弹性公网 IP 绑定到 ECS 实例 |
部署完成后获得的结果
模板成功执行后,您将获得:
一台 ECS 云服务器实例(CentOS 7 系统,已绑定弹性公网 IP)。
ECS 上已安装 JDK 1.8.0、Hadoop 2.7.7、Scala 2.12.1、Spark 2.1.0。
资源栈的输出中提供
SparkWebSiteURL,可登录 Spark 管理控制台。
如需通过外网访问 SparkWebSiteURL,请在安全组添加入方向 8088 和 8080 端口的访问规则。具体操作请参见使用安全组。
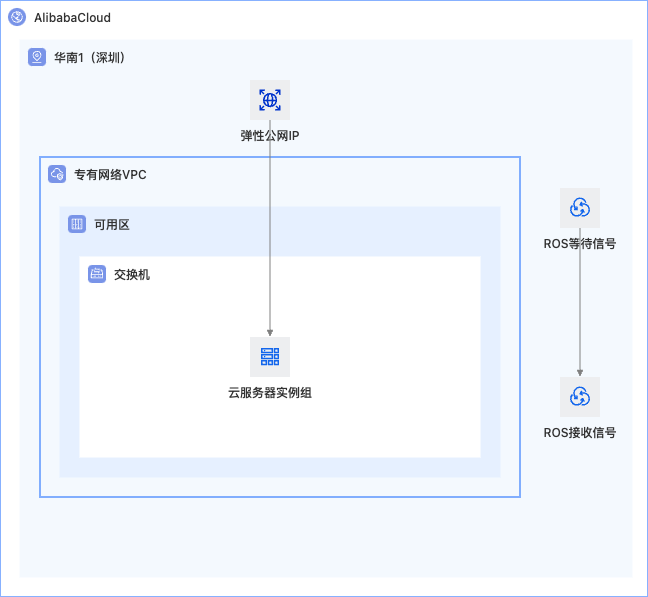
架构图
前提条件
在使用本模板前,请确认以下条件:
部署环节
部署参数
本模板要求使用已有的专有网络资源,下表中的参数均需在创建资源栈时填写。创建资源栈时所选地域需与已有专有网络、交换机和安全组所在地域一致。
参数 | 类型 | 说明 | 示例 |
现有 VPC 的实例 ID | String | VPC实例ID。关于如何创建和查询VPC实例,请参见创建和管理专有网络。 |
|
交换机可用区 | String | 专有网络下的交换机可用区 ID。 | 华东 1 可用区 K |
网络交换机 ID | String | 专有网络下的交换机ID。关于如何创建和查询交换机,请参见创建和管理交换机。 |
|
业务安全组 ID | String | ECS安全组ID。关于如何查询安全组ID,请参见使用安全组。 |
|
实例规格 | String | Spark 对内存需求较高,建议使用 2 核 4 GiB 及以上规格。 |
|
镜像ID | String | ECS 镜像 ID,默认使用 |
|
实例密码 | String | ECS登录密码,长度8~30,含大小写、数字、特殊字符。 |
|
公网 IP 带宽值 | Number | 公网 IP 的带宽。取值范围:1~100。单位:Mbps。 | 5 |
磁盘类型 | String | 系统盘类型。取值:
更多信息,请参见云盘概述。 |
|
系统盘空间 | Number | 实例系统盘大小。取值范围:40~500。单位:GB。 | 40 |
部署方式
方式一:通过 ROS 公共模板部署(推荐)
登录ROS 控制台。
在左侧导航栏,选择模板 > 公共模板 > 入门模板。
在搜索框中输入 Spark,找到模板 Spark 单机版(已有 VPC),单击模板卡片中的创建资源栈。
在配置参数页面,输入资源栈名称,并按上表填写部署参数。
单击下一步:检查并确认,然后单击创建。
在左侧导航栏,选择,在资源栈列表页面单击目标资源栈ID,在资源栈信息页签查看资源栈状态,等待状态变为
CREATE_COMPLETE。单击输出页签,获取
SparkWebSiteURL。在浏览器中访问该 URL,登录 Spark 管理控制台即部署成功。
方式二:通过 ROS IaC Code 部署
IaC Code 是面向云基础设施的 AI 基础设施即代码助手,可根据自然语言描述生成 ROS 模板并部署,使用方式参见IaC Code快速入门。
# prompt
帮我在已有 VPC 中创建一台 ECS 并部署 Spark 单机版开发测试环境。
要求:
1. 使用已有的 VPC、VSwitch 和安全组(不新建网络资源)。
2. 创建弹性公网 IP 并绑定到 ECS 实例。
3. ECS 使用 CentOS 7 镜像。
4. 通过 UserData 脚本自动安装 JDK 1.8.0、Hadoop 2.7.7、Scala 2.12.1、Spark 2.1.0。
5. 配置 JAVA_HOME、HADOOP_HOME、SCALA_HOME、SPARK_HOME 环境变量。
6. 启动 Spark 服务并输出 SparkWebSiteURL。
7. 安全组需开放入方向 8088 和 8080 端口。
部署后操作
验证Spark环境
在资源栈的输出页签获取
SparkWebSiteURL。通过浏览器访问该地址,显示 Spark 管理控制台页面表示部署成功。
连接ECS实例后,验证:
java -version          # 查看 JDK 版本
hadoop version         # 查看 Hadoop 版本
scala -version         # 查看 Scala 版本
spark-shell --version  # 查看 Spark 版本
常见问题
部署失败,报错“The specified InstanceType is not available”
原因:所选ECS实例规格在指定可用区中没有库存。
解决方案:
更换交换机所在的可用区后重新部署。
在云服务器ECS定价确认目标可用区的可用规格。
Spark 对内存需求较高,建议至少选择 2 核 4 GiB 及以上规格。
部署成功但无法访问 SparkWebSiteURL
按以下顺序排查:
确认安全组入方向规则已放行 TCP 8088 和 8080 端口,规则添加方式参见使用安全组。
访问 ECS控制台-实例,进入实例详情页,确认弹性公网 IP 已成功绑定到实例。
连接ECS实例后,确认 Spark 进程与端口监听状态:
# 检查 Spark 进程
ps -ef | grep spark
# 检查 8080 端口监听
netstat -tlnp | grep 8080
# 手动启动 Spark(如未运行)
$SPARK_HOME/sbin/start-all.sh
若 Spark 服务未安装完成,执行
cat /var/log/messages | grep cloud-init查看实例自定义数据(UserData)脚本的执行日志,定位安装过程中的失败原因。
如何部署 Spark 集群版
方案:ROS提供了 Spark 集群版公共模板,支持部署多节点Spark集群:
在ROS控制台 > 公共模板 中搜索"Spark集群版",找到Spark集群版(已有VPC)。
该模板会创建多台ECS实例(1个Master + N个Worker),自动配置集群通信
部署前建议先删除单机版资源栈,避免资源冲突
想要了解更多资源部署问题,可以查询常见问题合集。