
本文以Qwen3-32B模型为例,演示如何在ACK中部署Dynamo PD分离架构的模型推理服务。
背景知识
Qwen3-32B
Qwen3-32B 是千问系列最新一代的大型语言模型,基于328亿参数的密集模型架构,兼具卓越的推理能力与高效的对话性能。其最大特色在于支持思考模式与非思考模式的无缝切换。在复杂逻辑推理、数学计算和代码生成任务中表现出众,而在日常对话场景下也可高效响应。模型具备出色的指令遵循、多轮对话、角色扮演和创意写作能力,并在Agent任务中实现领先的工具调用表现。原生支持32K上下文,结合YaRN技术可扩展至131K。同时,支持100多种语言,具备强大的多语言理解与翻译能力,适用于全球化应用场景。有关更多详细信息,请参阅博客、GitHub和文档。
Dynamo
Dynamo 是NVIDIA推出的一款高吞吐、低延迟的推理框架,专门用于在多节点分布式环境中为LLM模型提供推理服务。
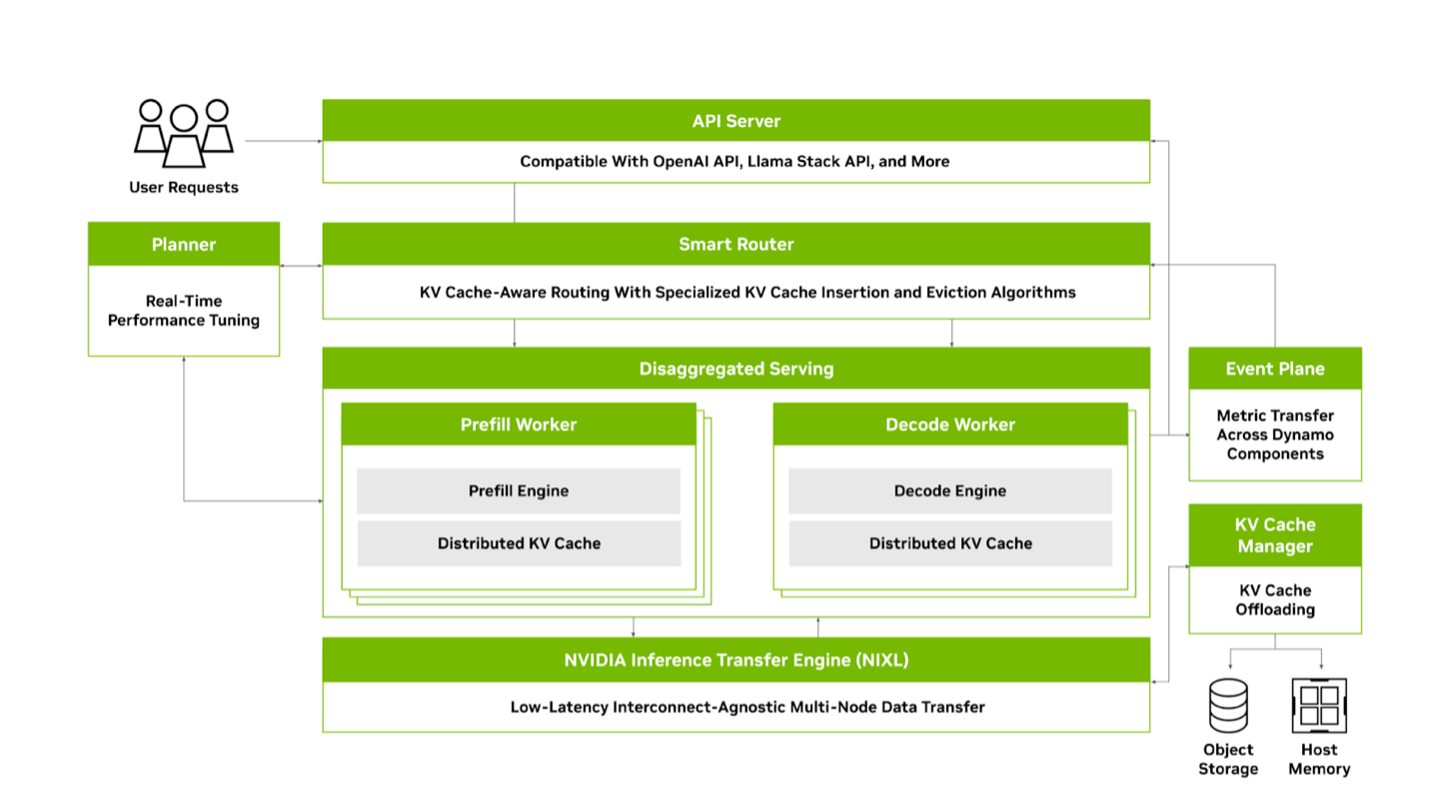
其核心特性包括如下所示,更多关于Dynamo框架的信息,请参见Dynamo GitHub及Dynamo文档。
引擎无关性:它不绑定于特定的推理引擎,可以灵活支持TensorRT-LLM、vLLM、SGLang等多种后端。
LLM专属优化能力:
Prefill与Decode分离推理,通过将Prefill和Decode分开部署,降低推理延迟,提升系统吞吐。
动态GPU调度,根据实时变化的负载需求来优化性能。
LLM感知的请求路由,可以根据节点KVCache进行路由,避免不必要的KVCache重计算。
加速数据传输,利用NIXL技术来加速中间计算结果及KVCache传输。
KVCache卸载,可以将KVCache卸载到内存、磁盘甚至云盘上,从而提升系统总吞吐量。
高性能与高扩展性,核心由 Rust 语言构建以追求极致性能,同时提供Python接口以方便用户进行扩展。
完全开源,Dynamo完全开源,并遵循透明的、开源软件优先的开发理念。
PD分离
Prefill/Decode分离架构,是当前主流的LLM推理优化技术,旨在解决推理过程中两个核心阶段的资源需求冲突问题。LLM的推理过程可分为两个阶段:
Prefill (提示词处理) 阶段:此阶段一次性处理用户输入的全部提示词(Prompt),并行计算所有输入Token的注意力,并生成初始的KV缓存。这个过程是计算密集型(Compute-Bound)的,需要强大的并行计算能力,但只在请求开始时执行一次。
Decode (解码生成) 阶段:此阶段是自回归过程,模型根据已有的KV缓存,逐个生成新的Token。每一步的计算量很小,但需要反复、快速地从显存中加载巨大的模型权重和KV缓存,因此是内存带宽密集型(Memory-Bound)的。
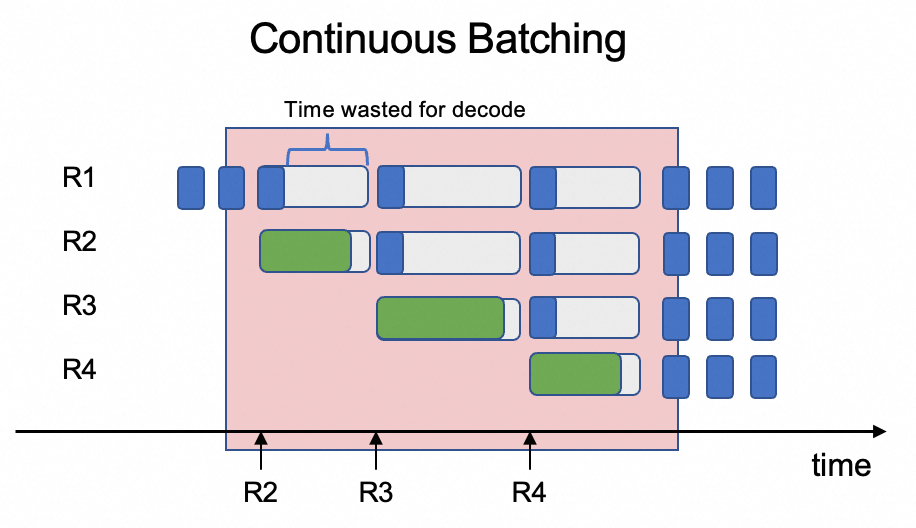
核心矛盾在于将这两种特性迥异的任务混合在同一GPU上调度,效率极低。推理引擎在处理多个用户请求时往往会采用连续批处理(Continuous Batching)的方式,将不同请求的Prefill阶段和Decode阶段放在一个批次里调度。由于Prefill阶段需处理完整提示词(计算复杂度高),而Decode阶段仅需生成单token(计算复杂度低),若在同一批次中调度,Decode阶段会因序列长度差异与资源竞争导致时延增加,进而增加系统整体延迟并降低吞吐量。
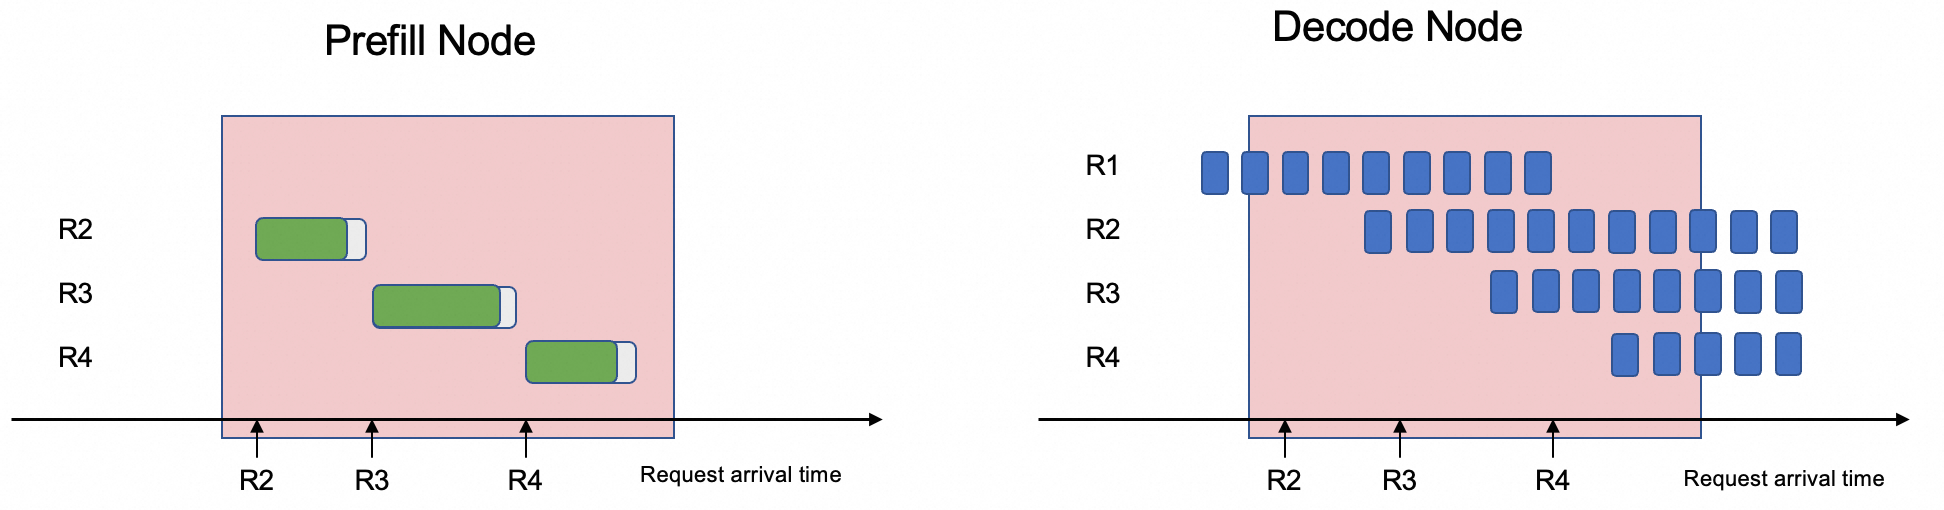
PD分离架构的解决方案就是将这两个阶段解耦,将Prefill和Decode阶段分开部署在不同GPU上。通过这种分离,系统可以针对Prefill和Decode不同特征进行优化,避免资源争抢,从而显著降低生成每个输出 token 的平均时间(TPOT),提升系统吞吐。
RoleBasedGroup
RoleBasedGroup(RBG)是阿里云容器服务团队设计的一种新的工作负载,为了解决PD分离架构在Kubernetes集群中大规模部署及运维的难题。该项目已开源,更多信息请查看RBG Github。
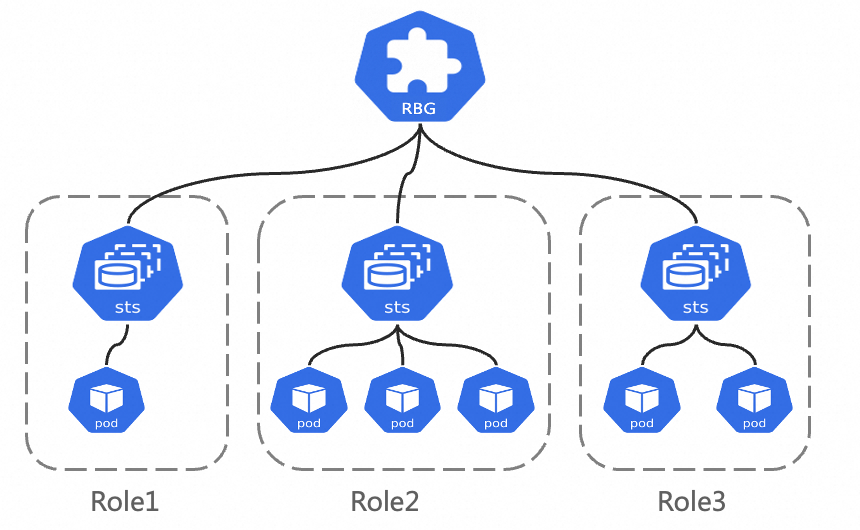
RBG API设计如下图所示,它由一组Role构成一个Group整体,每个Role可以基于StatefulSet/Deployment/LWS构建。其核心特性如下:
灵活的多角色定义:RBG支持定义任意数量任意名称的Role;支持定义Role间的依赖关系,可以按指定顺序启动Role;可以按照Role维度弹性扩缩容。
Runtime:具备Group内部的自动服务发现能力;支持多种重启策略;支持滚动更新;支持Gang调度。
前提条件
已创建ACK集群且集群版本为1.22及以上,并且已经为集群添加GPU节点。具体操作,请参见创建ACK托管集群和为集群添加GPU节点。
本文要求集群中GPU卡>=6, 单个GPU卡显存>=32GB。推荐使用ecs.ebmgn8is.32xlarge规格,更多规格信息可参考弹性裸金属服务器规格。
已安装ack-rbgs组件。组件安装步骤如下。
登录容器服务管理控制台,在左侧导航栏选择集群列表。单击目标集群名称,进入集群详情页面,使用Helm为目标集群安装ack-rbgs组件。您无需为组件配置应用名和命名空间,单击下一步后会出现一个请确认的弹框,单击是,即可使用默认的应用名(ack-rbgs)和命名空间(rbgs-system)。然后选择Chart 版本为最新版本,单击确定即可完成ack-rbgs组件的安装。
在集群详情页面左侧导航栏选择应用,在Helm页面单击创建,来源选择应用市场,搜索并选择ack-rbgs Chart。
模型部署
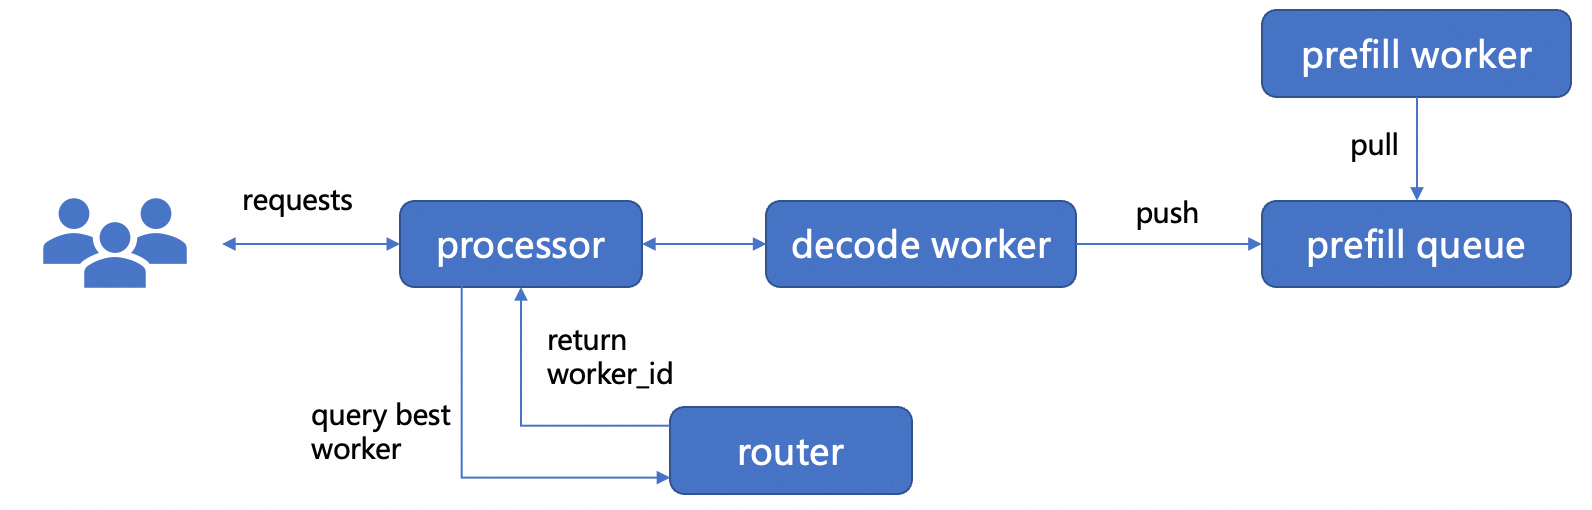
部署Dynamo PD分离架构推理服务。Dynamo PD分离时序图如下所示。
用户请求首先发送给processor组件,经由router选出合适的Decode Worker,将请求转发给Decode Worker。
由Decode Worker判断是否prefill计算是在本地完成还是远程完成。如果需要远程计算,则向PrefillQueue中发送请求。
PrefillWorker从Queue获取请求后进行Prefill计算。等计算完成后,将Prefill KVCache传输给Decode Worker。
步骤一:准备Qwen3-32B模型文件
执行以下命令从ModelScope下载Qwen-32B模型。
请确认是否已安装git-lfs插件,如未安装可执行
yum install git-lfs或者apt-get install git-lfs安装。更多的安装方式,请参见安装git-lfs。git lfs install GIT_LFS_SKIP_SMUDGE=1 git clone https://www.modelscope.cn/Qwen/Qwen3-32B.git cd Qwen3-32B/ git lfs pull登录OSS控制台,查看并记录已创建的Bucket名称。如何创建Bucket,请参见创建存储空间。在OSS中创建目录,将模型上传至OSS。
关于ossutil工具的安装和使用方法,请参见安装ossutil。
ossutil mkdir oss://<YOUR-BUCKET-NAME>/Qwen3-32B ossutil cp -r ./Qwen3-32B oss://<YOUR-BUCKET-NAME>/Qwen3-32B创建PV和PVC。为目标集群配置名为
llm-model的存储卷PV和存储声明PVC。具体操作,请参见创建PV和PVC。控制台操作示例
创建PV。
登录容器服务管理控制台,在左侧导航栏选择集群列表。
在集群列表页面,单击目标集群名称,然后在左侧导航栏,选择。
创建
pv-oss-rrsa.yaml。apiVersion: v1 kind: PersistentVolume metadata: # PV名称 name: pv-oss # PV标签 labels: alicloud-pvname: pv-oss spec: capacity: # 定义存储卷容量 storage: 10Gi # 访问模式 accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com # 与PV名称(metadata.name)一致 volumeHandle: pv-oss volumeAttributes: # 替换为实际Bucket名称 bucket: "your-bucket-name" # 替换为实际Bucket的地域 region: cn-hangzhou # 挂载Bucket的根目录或指定子目录 path: / # Bucket所在地域的Endpoint url: "https://oss-cn-hangzhou-internal.aliyuncs.com" otherOpts: "-o umask=022 -o max_stat_cache_size=100000 -o allow_other" authType: "rrsa" # 此前创建或修改的RAM角色 roleName: "demo-role-for-rrsa" # OSS请求签名版本 sigVersion: "v4"参数
描述
storage定义OSS存储卷容量。此值仅用于匹配PVC。
accessModes配置访问模式,支持
ReadOnlyMany和ReadWriteMany。选择
ReadOnlyMany时,ossfs将以只读模式挂载OSS Bucket。persistentVolumeReclaimPolicyPV回收策略。当前OSS存储卷仅支持
Retain,即删除PVC时,PV和OSS Bucket中的数据不会随之删除。driver定义驱动类型。使用阿里云OSS CSI插件固定为
ossplugin.csi.alibabacloud.com。volumeHandle需与PV名称(
metadata.name)保持一致。bucket待挂载的OSS Bucket。
pathCSI组件版本需为v1.14.8.32-c77e277b-aliyun及以上。
指定挂载点相对于 Bucket 根目录的路径。默认为
/,即挂载整个 Bucket。ossfs版本小于1.91时,指定的
path必须在 OSS Bucket 中预先存在。详见ossfs 1.91及以上版本新增功能说明url待挂载OSS的访问域名(Endpoint)。
挂载节点和Bucket处于相同地域,或已打通VPC网络时,使用内网地址。
挂载节点和Bucket不同地域时,使用外网地址。
不同访问端口的常见填写格式如下:
内网格式:
https://oss-{{regionName}}-internal.aliyuncs.com。内网访问端口格式
vpc100-oss-{{regionName}}.aliyuncs.com已废弃,请及时切换。外网格式:
https://oss-{{regionName}}.aliyuncs.com。
从安全考虑,建议您通过HTTPS协议访问OSS,若希望使用HTTP协议,请替换上述格式为
http://开头。otherOpts为OSS存储卷输入定制化参数,格式为
-o *** -o ***,例如-o umask=022 -o max_stat_cache_size=100000 -o allow_other。authType配置为
rrsa,使用RRSA方式鉴权。roleName配置为此前创建或修改的RAM角色。
如需为不同PV配置不同权限,可创建不同的RAM角色,并在PV中配置不同的
roleName。sigVersion请求OSS服务端的请求签名版本。
重要OSS 将逐步下线 V1 签名,强烈建议您使用更安全的 V4 签名,以确保应用稳定运行。详见V1签名下线时间和影响。
使用OSS签名版本4时,必须配置
region参数。
region使用OSS签名版本4时需要配置为Bucket所在的OSS地域。如何查询OSS地域,详见获取存储空间的地域信息。
非空时,自动选择使用OSS签名版本4。
若默认的RRSA鉴权不满足需求(如使用非默认ServiceAccount或第三方OIDC),可通过修改PV配置来指定具体的ARN或ServiceAccount,详见如何在RRSA鉴权方式中使用指定的ARNs或ServiceAccount?。
在存储卷页面,单击创建,选择存储卷类型为OSS,按照页面配置并提交参数。
以下为示例PV的基本配置信息:
配置项
说明
存储卷类型
OSS
名称
llm-model
访问证书
配置用于访问OSS的AccessKey ID和AccessKey Secret。
Bucket ID
选择上一步所创建的OSS Bucket。
OSS Path
选择模型所在的路径,如
/Qwen3-32B。
创建PVC。
在集群列表页面,单击目标集群名称,然后在左侧导航栏,选择。
创建
pv-oss-rrsa.yaml。apiVersion: v1 kind: PersistentVolume metadata: # PV名称 name: pv-oss # PV标签 labels: alicloud-pvname: pv-oss spec: capacity: # 定义存储卷容量 storage: 10Gi # 访问模式 accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com # 与PV名称(metadata.name)一致 volumeHandle: pv-oss volumeAttributes: # 替换为实际Bucket名称 bucket: "your-bucket-name" # 替换为实际Bucket的地域 region: cn-hangzhou # 挂载Bucket的根目录或指定子目录 path: / # Bucket所在地域的Endpoint url: "https://oss-cn-hangzhou-internal.aliyuncs.com" otherOpts: "-o umask=022 -o max_stat_cache_size=100000 -o allow_other" authType: "rrsa" # 此前创建或修改的RAM角色 roleName: "demo-role-for-rrsa" # OSS请求签名版本 sigVersion: "v4"参数
描述
storage定义OSS存储卷容量。此值仅用于匹配PVC。
accessModes配置访问模式,支持
ReadOnlyMany和ReadWriteMany。选择
ReadOnlyMany时,ossfs将以只读模式挂载OSS Bucket。persistentVolumeReclaimPolicyPV回收策略。当前OSS存储卷仅支持
Retain,即删除PVC时,PV和OSS Bucket中的数据不会随之删除。driver定义驱动类型。使用阿里云OSS CSI插件固定为
ossplugin.csi.alibabacloud.com。volumeHandle需与PV名称(
metadata.name)保持一致。bucket待挂载的OSS Bucket。
pathCSI组件版本需为v1.14.8.32-c77e277b-aliyun及以上。
指定挂载点相对于 Bucket 根目录的路径。默认为
/,即挂载整个 Bucket。ossfs版本小于1.91时,指定的
path必须在 OSS Bucket 中预先存在。详见ossfs 1.91及以上版本新增功能说明url待挂载OSS的访问域名(Endpoint)。
挂载节点和Bucket处于相同地域,或已打通VPC网络时,使用内网地址。
挂载节点和Bucket不同地域时,使用外网地址。
不同访问端口的常见填写格式如下:
内网格式:
https://oss-{{regionName}}-internal.aliyuncs.com。内网访问端口格式
vpc100-oss-{{regionName}}.aliyuncs.com已废弃,请及时切换。外网格式:
https://oss-{{regionName}}.aliyuncs.com。
从安全考虑,建议您通过HTTPS协议访问OSS,若希望使用HTTP协议,请替换上述格式为
http://开头。otherOpts为OSS存储卷输入定制化参数,格式为
-o *** -o ***,例如-o umask=022 -o max_stat_cache_size=100000 -o allow_other。authType配置为
rrsa,使用RRSA方式鉴权。roleName配置为此前创建或修改的RAM角色。
如需为不同PV配置不同权限,可创建不同的RAM角色,并在PV中配置不同的
roleName。sigVersion请求OSS服务端的请求签名版本。
重要OSS 将逐步下线 V1 签名,强烈建议您使用更安全的 V4 签名,以确保应用稳定运行。详见V1签名下线时间和影响。
使用OSS签名版本4时,必须配置
region参数。
region使用OSS签名版本4时需要配置为Bucket所在的OSS地域。如何查询OSS地域,详见获取存储空间的地域信息。
非空时,自动选择使用OSS签名版本4。
若默认的RRSA鉴权不满足需求(如使用非默认ServiceAccount或第三方OIDC),可通过修改PV配置来指定具体的ARN或ServiceAccount,详见如何在RRSA鉴权方式中使用指定的ARNs或ServiceAccount?。
以下为示例PVC的基本配置信息:
配置项
说明
存储声明类型
OSS
名称
llm-model
分配模式
选择已有存储卷。
已有存储卷
单击选择已有存储卷链接,选择已创建的存储卷PV。
kubectl操作示例
创建
llm-model.yaml文件,该YAML文件包含Secret、静态卷PV、静态卷PVC等配置,示例YAML文件如下所示。apiVersion: v1 kind: Secret metadata: name: oss-secret stringData: akId: <YOUR-OSS-AK> # 配置用于访问OSS的AccessKey ID akSecret: <YOUR-OSS-SK> # 配置用于访问OSS的AccessKey Secret --- apiVersion: v1 kind: PersistentVolume metadata: name: llm-model labels: alicloud-pvname: llm-model spec: capacity: storage: 30Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: llm-model nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: <YOUR-BUCKET-NAME> # bucket名称 url: <YOUR-BUCKET-ENDPOINT> # Endpoint信息,如oss-cn-hangzhou-internal.aliyuncs.com otherOpts: "-o umask=022 -o max_stat_cache_size=0 -o allow_other" path: <YOUR-MODEL-PATH> # 本示例中为/Qwen3-32B/ --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: llm-model spec: accessModes: - ReadOnlyMany resources: requests: storage: 30Gi selector: matchLabels: alicloud-pvname: llm-model创建Secret、创建静态卷PV、创建静态卷PVC。
kubectl create -f llm-model.yaml
步骤二:安装ETCD及NATS服务
Dynamo框架中跨节点通信使用的是NIXL。NIXL启动时会向ETCD注册,从而实现相互发现。NATS服务主要用于Prefill和Decode Worker间消息传递。因此部署推理服务前,需要先部署ETCD及NATS服务。
执行以下命令创建
etcd.yaml并部署ETCD服务。kubectl apply -f etcd.yaml执行以下命令创建
nats.yaml并部署NATS服务。kubectl apply -f nats.yaml
步骤三:部署Dynamo PD分离架构的推理服务
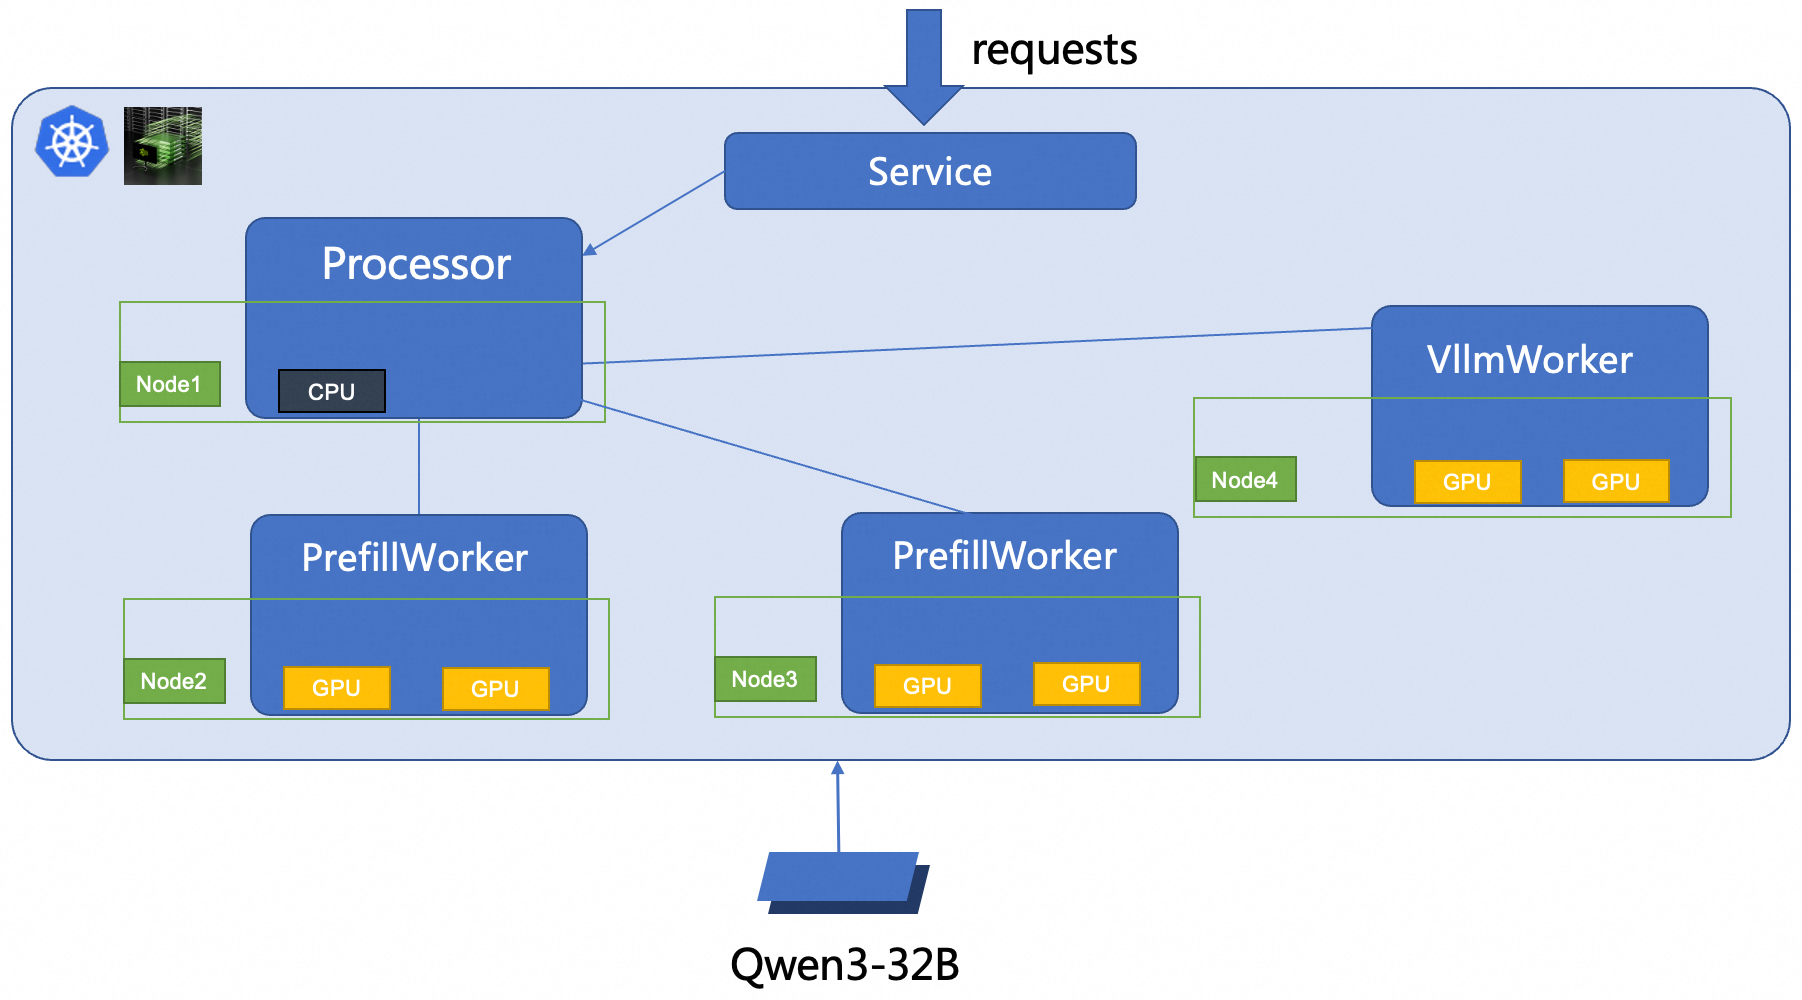
本文使用RBG部署2P1D Dynamo推理服务,部署架构图如下所示。 Prefill和Decode均采用了TP=2的方式部署。
使用
dynamo-configs.yaml配置qwen3模型及Dynamo框架相关的配置文件。kubectl apply -f dynamo-configs.yaml准备Dynamo Runtime镜像。
具体操作,请参见Dynamo社区文档获取,或制作使用vllm作为推理框架的Dynamo Runtime容器镜像。
执行以下命令创建
dynamo.yaml并部署服务。kubectl apply -f ./dynamo.yaml
步骤四:验证推理服务
执行以下命令,在推理服务与本地环境之间建立端口转发。
重要kubectl port-forward建立的端口转发不具备生产级别的可靠性、安全性和扩展性,因此仅适用于开发和调试目的,不适合在生产环境使用。更多关于Kubernetes集群内生产可用的网络方案的信息,请参见Ingress管理。kubectl port-forward svc/dynamo-service 8000:8000预期输出:
Forwarding from 127.0.0.1:8000 -> 8000
Forwarding from [::1]:8000 -> 8000
执行以下命令,向模型推理服务发送了一条示例的模型推理请求。
curl http://localhost:8000/v1/chat/completions -H "Content-Type: application/json" -d '{"model": "qwen","messages": [{"role": "user","content": "测试一下"}],"stream":false,"max_tokens": 30}'预期输出:
{"id":"31ac3203-c5f9-4b06-a4cd-4435a78d3b35","choices":[{"index":0,"message":{"content":"<think>\n好的,用户发来“测试一下”,我需要先确认他们的意图。可能是在测试我的反应速度或者功能,也可能是想","refusal":null,"tool_calls":null,"role":"assistant","function_call":null,"audio":null},"finish_reason":"length","logprobs":null}],"created":1753702438,"model":"qwen","service_tier":null,"system_fingerprint":null,"object":"chat.completion","usage":null}输出结果表明模型可以根据给定的输入(在这个例子中是一条测试消息)生成相应的回复。
相关文档
针对LLM模型服务的动态负载波动问题,Kubernetes HPA结合ACK的ack-alibaba-cloud-metrics-adapter组件,可根据CPU/内存/GPU利用率及自定义指标实现Pod的动态弹性伸缩,保障服务稳定性与资源高效利用。
LLM 模型通常包含超过10GB的权重文件,从存储服务(如 OSS、NAS 等)拉取这些大文件时,容易因长时间延迟和冷启动问题影响性能。Fluid 通过在 Kubernetes 集群节点上构建分布式文件缓存系统,整合多个节点的存储与带宽资源;同时,它从应用程序端优化模型文件的读取机制,从而显著加速模型加载过程。