
通过创建Hive数据源能够实现Dataphin读取Hive的业务数据或向Hive写入数据。本文为您介绍如何创建Hive数据源。
背景信息
Hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供SQL查询功能。Hive用于转化HQL或SQL语句为MapReduce、Tez等程序。如果您使用的是Hive,在对接Dataphin进行数据开发或将Dataphin的数据写入至Hive的场景中,您需要先完成Hive数据源的创建。更多信息,请参见Hive官网。
使用限制
-
在Aliyun E-MapReduce5.x Hadoop计算引擎下,若您需要使用基于OSS创建的Hive外部表进行离线集成。您需要进行相关配置后才可以正常使用。配置说明,请参见。
-
使用Hive数据源作为集成的输入输出组件时,请确认Dataphin的IP地址已在Hive的网络白名单中,以确保Dataphin能够访问Hive中的数据。
-
请确保Dataphin的应用集群与调度集群与Hive服务、HDFS的NameNode(包括webUI、IPC)和DataNode、KDC Server、元数据库或Hive Meta Store、Zookeeper的连通性。
-
已购买元数据采集-大数据存储功能,且已创建可以访问此数据源的注册调度集群后,才可正常使用Hive数据源。
权限说明
仅支持具备新建数据源权限点的自定义全局角色和超级管理员、数据源管理员、板块架构师、项目管理员角色创建数据源。
操作步骤
-
在Dataphin首页顶部菜单栏中,选择管理中心 > 数据源管理。
-
在数据源页面,单击+新建数据源。
-
在新建数据源页面的大数据存储区域,选择Hive。
如果您最近使用过Hive,也可以在最近使用区域选择Hive。同时,您也可以在搜索框中,输入Hive的关键词,快速筛选。
-
在新建Hive数据源页面中,配置数据源连接参数。
Hive数据源配置参数中,集成配置是为了支持数据集成,实时研发配置是为了支持实时研发的场景,而元数据库配置是基础的配置,用来获取元数据。
说明通常情况下,生产数据源和开发数据源需配置为非同一个数据源,以实现开发数据源与生产数据源的环境隔离,降低开发数据源对生产数据源的影响。但Dataphin也支持配置成同一个数据源,即相同参数值。
-
Hive数据源基本信息配置
参数
描述
数据源名称
填写数据源名称。命名规则如下:
-
只能包含中文、英文字母大小写、数字、下划线(_)或短划线(-)。
-
长度不能超过64个字符。
数据源编码
配置数据源编码后,您可以在Flink_SQL任务中通过
数据源编码.表名称或数据源编码.schema.表名称的格式引用数据源中的表;如果需要根据所处环境自动访问对应环境的数据源,请通过${数据源编码}.table或${数据源编码}.schema.table的变量格式访问。更多信息,请参见Flink SQL任务开发方式。重要数据源编码配置成功后不支持修改。
数据源编码配置成功后,才能在资产清单的对象详情页面进行数据预览。
Flink SQL中,目前仅支持MySQL、Hologres、MaxCompute、Oracle、StarRocks、Hive、SelectDB、GaussDB(DWS)数据源。
版本
选择Hive数据源的版本。Dataphin支持以下版本:
-
CDH5.x Hive 1.1.0
-
Aliyun EMR3.x Hive 2.3.5
-
Aliyun EMR5.x Hive 3.1.x
-
CDH6.x Hive 2.1.1
-
FusionInsight 8.x Hive 3.1.0
-
CDP7.x Hive 3.1.3
-
亚信DP5.x Hive 3.1.0
-
Amazon EMR
数据源描述
对数据源的简单描述,128个字符以内。
数据源配置
选择数据源的配置环境:
-
如果业务数据源区分生产数据源和开发数据源,则选择生产+开发数据源。
-
如果业务数据源不区分生产数据源和开发数据源,则选择生产数据源。
标签
您可根据标签给数据源进行分类打标,如何创建标签,请参见管理数据源标签。
-
-
生产/开发数据源配置
不同Hive版本所需配置的数据源参数不同。
除Amazon EMR外的其他版本
Hive配置
元数据获取方式:支持元数据库、DLF源数据获取方式。获取方式不同,所需配置信息不同。
元数据库
说明当开启模块中仅选中实时研发时,元数据获取方式仅支持元数据库。
参数
说明
数据库类型
请根据集群中使用的元数据库类型,选择对应的数据库类型。Dataphin支持选择MySQL。MySQL数据库类型支持MySQL 5.1.43、MySQL 5.6/5.7和MySQL 8版本。
JDBC URL
填写目标数据库的JDBC连接地址。连接地址格式为
jdbc:mysql://host:port/dbname。用户名、密码
填写登录Hive的用户名和密码。
Hive JDBC URL
填写Hive的JDBC连接地址。支持配置以下三种类型的连接地址:
-
Hive Server:连接地址格式为
jdbc:hive://host:port/dbname。 -
ZooKeeper:例如
jdbc:hive2://zk01:2181,zk02:2181,zk03:2181/;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2。 -
Hive已开启Kerberos:连接地址格式为
jdbc:hive2://host:port/dbname;principal=hive/_HOST@xx.com。
说明当版本选择为E-MapReduce3.x、E-MapReduce5.x、Cloudera Data Platform时,开启Kerberos认证后,JDBC URL中不支持填写多个IP地址。
DLF
说明仅Aliyun EMR5.x Hive 3.1.x版本支持DLF获取方式。
参数
说明
Endpoint
填写集群在DLF数据中心所在地域的Endpoint。如何获取,请参见DLF Region和Endpoint对照表。
AccessKey ID、AccessKey Secret
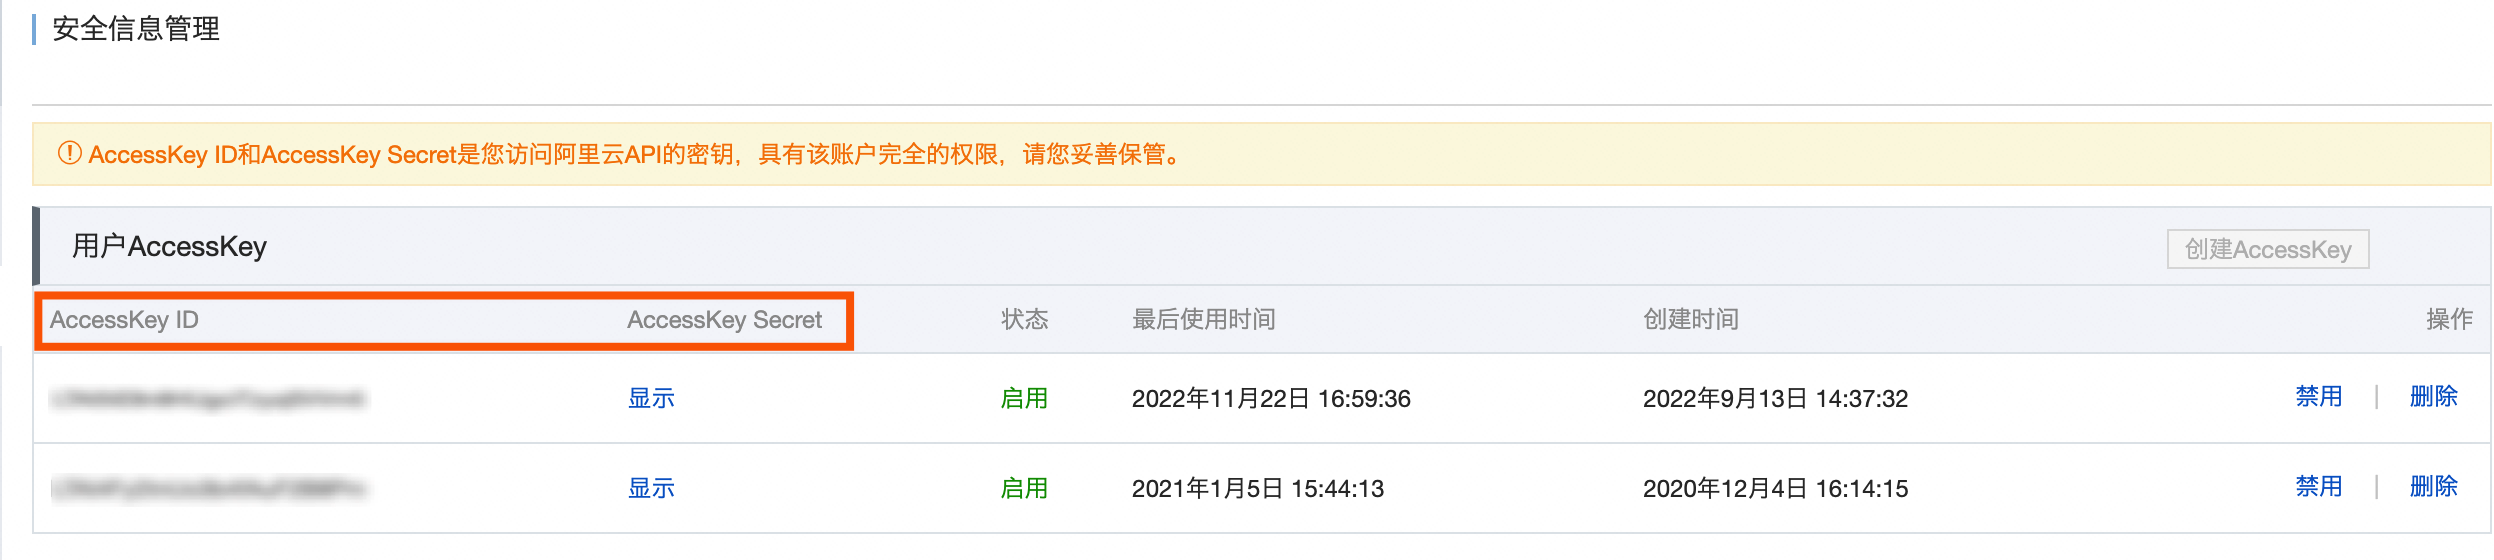
填写集群所在账号的AccessKey ID和AccessKey Secret。
您可在用户信息管理页面,获取账号的AccessKey ID和AccessKey Secret。
hive-site.xml
上传Hive的hive-site.xml配置文件。
说明若开启实时研发,则实时研发中也将复用该配置文件。
Hive JDBC URL
填写Hive的JDBC连接地址。支持配置以下三种类型的连接地址:
-
Hive Server:连接地址格式为
jdbc:hive://host:port/dbname。 -
ZooKeeper:例如
jdbc:hive2://zk01:2181,zk02:2181,zk03:2181/;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2。 -
Hive已开启Kerberos:连接地址格式为
jdbc:hive2://host:port/dbname;principal=hive/_HOST@xx.com。
集成
说明开启模块中选择集成后,支持配置集成模块。
集成配置
支持HDFS、OSS-HDFS集群存储两种方式。存储方式不同,所需配置信息不同。
HDFS
参数
描述
NameNode
NameNode是HDFS集群中元数据的管理者,单击新增,在新增NameNode对话框,配置NameNode节点信息。
-
Web UI Port:访问Hadoop集群中各个组件的Web界面的端口。
-
IPC Port:进程间通信(IPC)的端口。
Web UI Port和IPC Port在CDH5环境下默认是
50070和8020,您可根据实际情况填写对应的端口。说明Web UI Port和IPC Port其中一个填写正确时,可以正常完成测试连接。
配置文件
上传Hadoop的配置文件
hdfs-site.xml和core-site.xml,配置文件可在Hadoop集群导出。说明开启数据湖表格式并选择Hudi作为表格式后,若实时研发使用Hive数据源并采用dp-hudi Connector,则还需上传
hive-site.xml配置文件。开启Kerberos
Kerberos是一种基于对称密钥技术的身份认证协议,可以为其他服务提供身份认证功能,且支持SSO(即客户端身份认证后,可以访问多个服务,例如HBase和HDFS)。
如果Hadoop集群有Kerberos认证,则需要完成以下配置。
-
Kerberos配置方式
-
KDC Server:KDC服务器地址,辅助完成Kerberos认证。
说明支持配置多个KDC Server服务地址,使用英文逗号(,)分隔。
-
Krb5文件配置:需要上传Krb5文件进行Kerberos认证。
-
-
HDFS配置
-
HDFS Keytab File:上传keytab认证文件,您可以在HDFS Server上获取keytab文件。
-
HDFS Principal:填写HDFS Keytab File文件对应的Principal名,例如
xxx/hdfsclient@xxx.xxx。
-
-
Hive配置
-
JDBC URL:填写Hive的JDBC连接地址。支持配置以下三种连接地址:
-
Hive Server的连接地址,格式为
jdbc:hive://host:port/dbname。 -
ZooKeeper的连接地址。例如
jdbc:hive2://zk01:2181,zk02:2181,zk03:2181/;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2。 -
开启Kerberos的连接地址,格式为
jdbc:hive2://host:port/dbname;principal=hive/_HOST@xx.com。
说明当版本选择为E-MapReduce3.x、E-MapReduce5.x、Cloudera Data Platform时,开启Kerberos认证后,JDBC URL中不支持填写多个IP地址。
-
-
Hive Keytab File:上传keytab认证文件,您可以在Hive Server上获取keytab文件。
-
Hive Principal:填写Hive Keytab File文件对应的Principal名,例如
xxx/hdfsclient@xxx.xxx。
-
关闭Kerberos
如果Hadoop集群无Kerberos认证,则需要完成以下配置。
-
JDBC URL:填写Hive的JDBC连接地址。支持配置以下三种连接地址:
-
Hive Server的连接地址,格式为
jdbc:hive://hodt:port/dbname。 -
ZooKeeper的连接地址。例如
jdbc:hive2://zk01:2181,zk02:2181,zk03:2181/;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2。 -
开启Kerberos的连接地址,格式为
jdbc:hive2://host:port/dbname;principal=hive/_HOST@xx.com。说明当版本选择为E-MapReduce3.x、E-MapReduce5.x、Cloudera Data Platform时,开启Kerberos认证后,JDBC URL中不支持填写多个IP地址。
-
-
用户名、密码:填写登录Hive用户名和密码。
说明为保证任务正常运行,需确保所填写的用户有访问Hive数据的权限。
OSS-HDFS
说明仅Aliyun EMR5.x Hive3.1.x版本支持OSS-HDFS集群存储。
参数
描述
集群存储
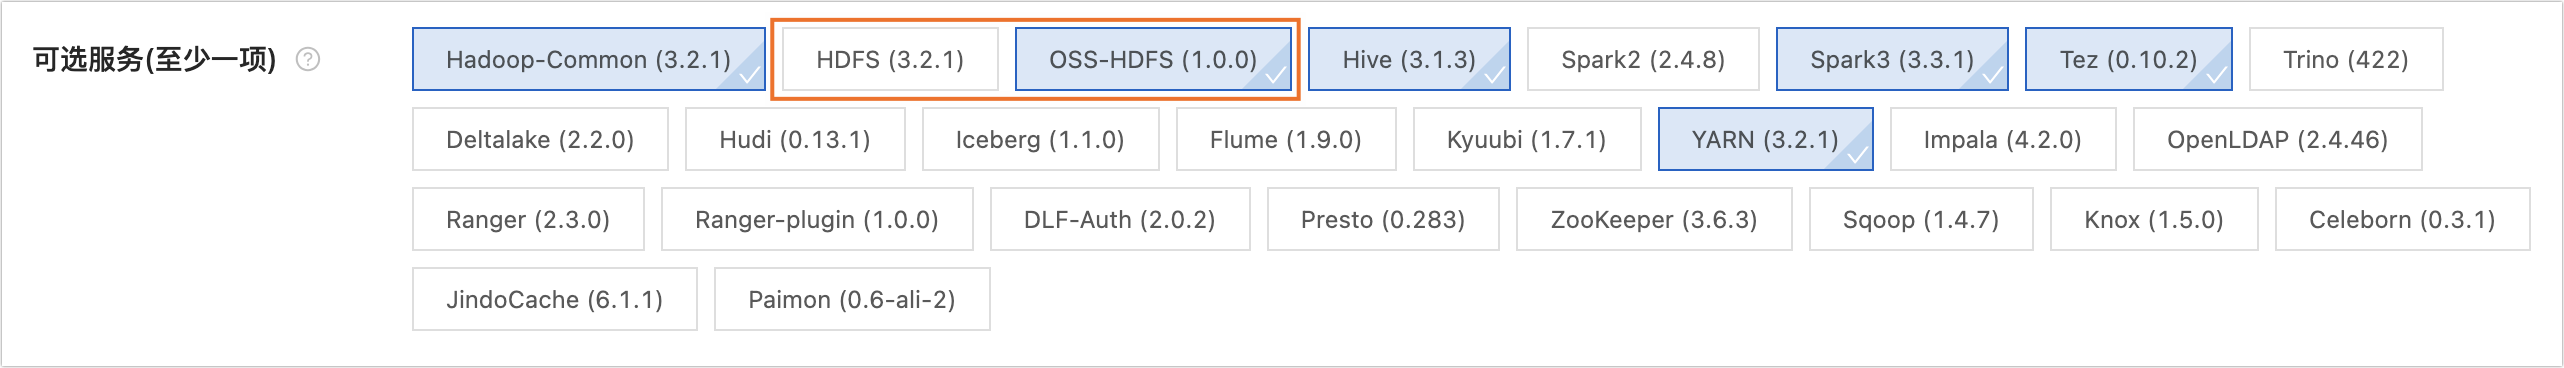
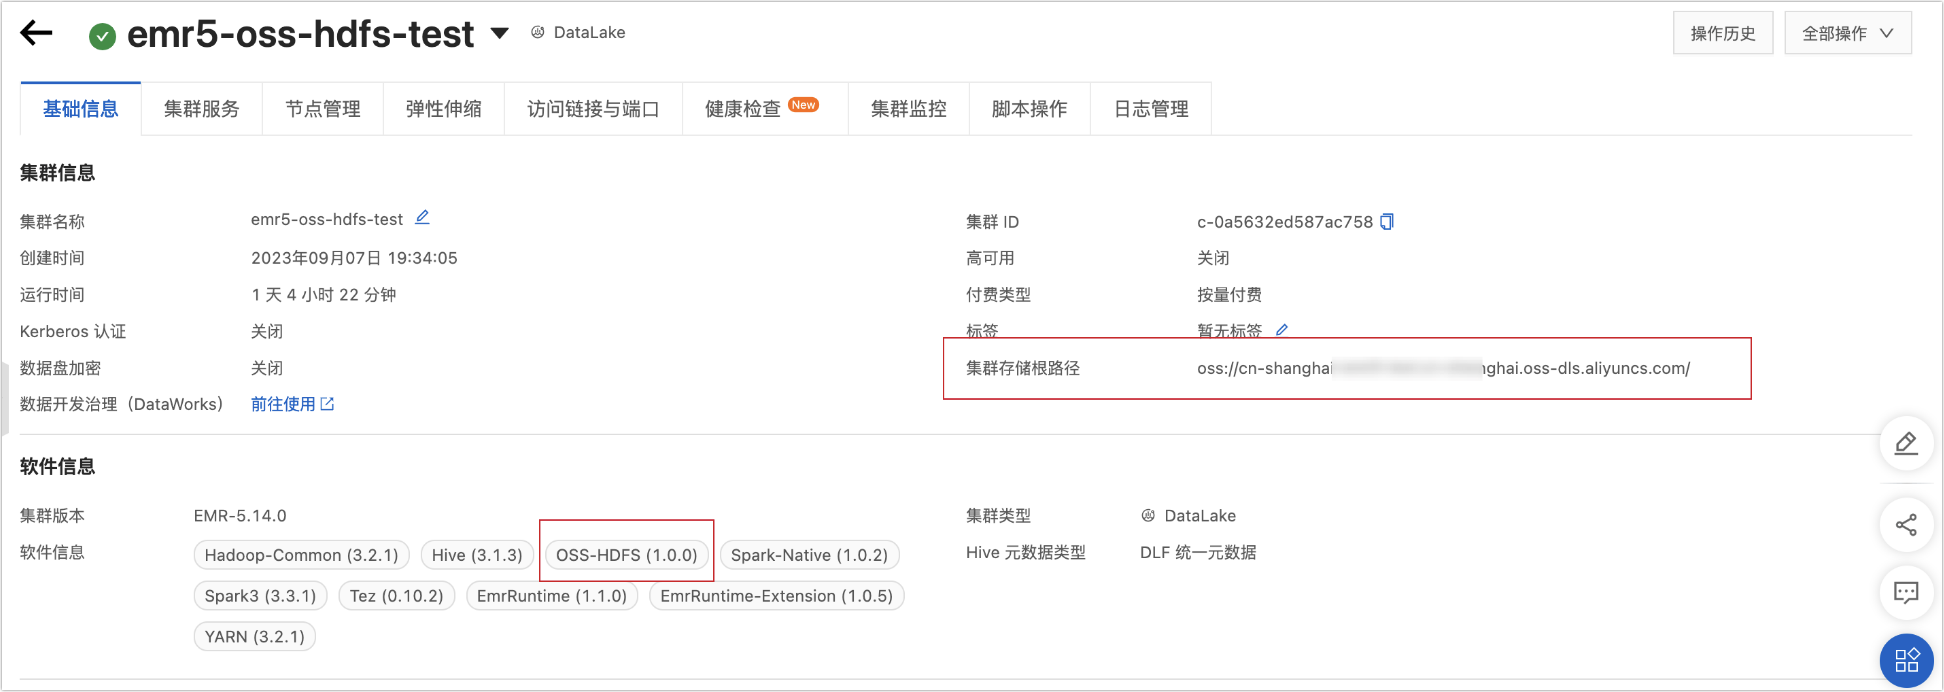
可以通过以下方式查看集群存储类型。
-
未创建集群:可以通过E-MapReduce5.x Hadoop集群创建页面查看所创建的集群存储类型。如下图所示:
-
已创建集群:可以通过E-MapReduce5.x Hadoop集群的详情页查看所创建的集群存储类型。如下图所示:
集群存储根目录
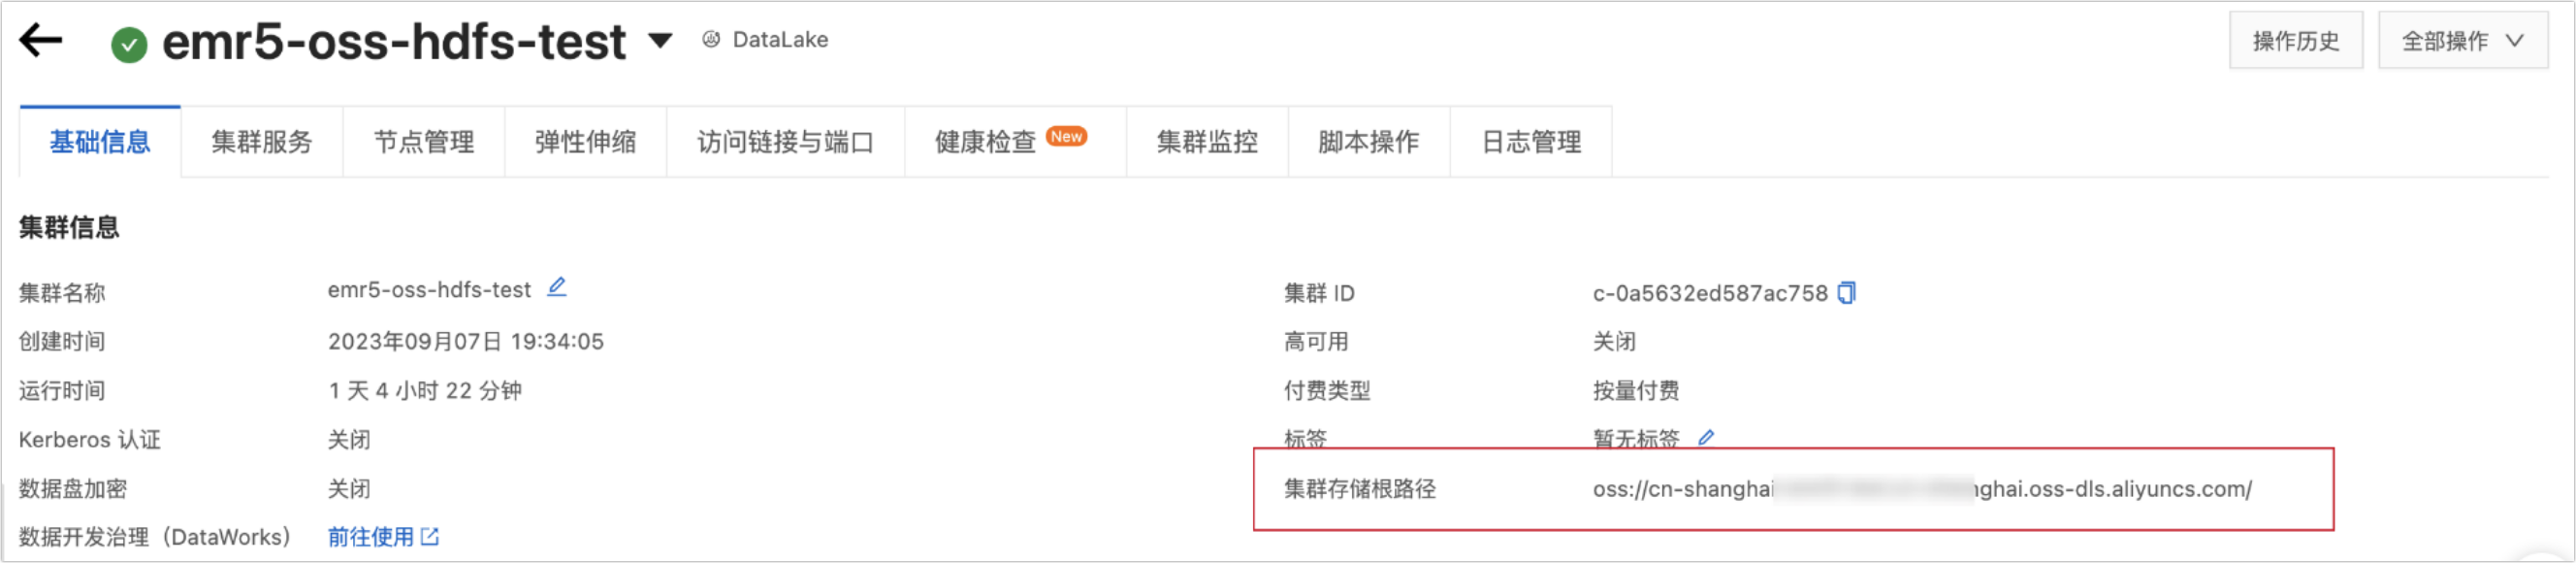
填写集群存储根目录。可以通过查看E-MapReduce5.x Hadoop集群信息获取进行。如下图所示:
 重要
若填写的路径中包括Endpoint,则Dataphin默认使用该Endpoint;若不包含,则使用core-site.xml中配置的Bucket级别的Endpoint;若未配置Bucket级别的Endpoint,则使用core-site.xml中的全局Endpoint。更多信息请参见阿里云OSS-HDFS服务(JindoFS 服务)Endpoint配置。
配置文件
上传集群的
core-site.xml和hive-metastore-site.xml配置文件,配置文件可在Hadoop集群导出。AccessKey ID、AccessKey Secret
填写访问集群OSS的AccessKey ID和AccessKey Secret。请使用已有AccessKey或者参考创建AccessKey重新创建。
重要-
此处填写的配置优先级高于core-site.xml中配置的AccessKey。
-
为降低AccessKey泄露的风险,AccessKey Secret只在创建时显示一次,后续无法查看。请务必妥善保管。
开启Kerberos
Kerberos是一种基于对称密钥技术的身份认证协议,可以为其他服务提供身份认证功能,且支持SSO(即客户端身份认证后,可以访问多个服务,例如HBase和HDFS)。
如果Hadoop集群有Kerberos认证,则需要完成以下配置。
-
Kerberos配置方式
Krb5文件配置:需要上传Krb5文件进行Kerberos认证。
-
Hive配置
-
JDBC URL:填写Hive的JDBC连接地址。支持配置以下三种连接地址:
-
Hive Server的连接地址,格式为
jdbc:hive://host:port/dbname。 -
ZooKeeper的连接地址。例如
jdbc:hive2://zk01:2181,zk02:2181,zk03:2181/;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2。 -
开启Kerberos的连接地址,格式为
jdbc:hive2://host:port/dbname;principal=hive/_HOST@xx.com。说明当版本选择为E-MapReduce3.x、E-MapReduce5.x、Cloudera Data Platform时,开启Kerberos认证后,JDBC URL中不支持填写多个IP地址。
-
-
Hive Keytab File:上传keytab认证文件,您可以在Hive Server上获取keytab文件。
-
Hive Principal:填写Hive Keytab File文件对应的Principal名,例如
xxx/hdfsclient@xxx.xxx。
-
关闭Kerberos
如果Hadoop集群无Kerberos认证,则需要完成以下配置。
-
JDBC URL:填写Hive的JDBC连接地址。支持配置以下三种连接地址:
-
Hive Server的连接地址,格式为
jdbc:hive://hodt:port/dbname。 -
ZooKeeper的连接地址。例如
jdbc:hive2://zk01:2181,zk02:2181,zk03:2181/;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2。 -
开启Kerberos的连接地址,格式为
jdbc:hive2://host:port/dbname;principal=hive/_HOST@xx.com。
-
-
用户名、密码:填写登录Hive用户名和密码。
说明为保证任务正常运行,需确保所填写的用户有访问Hive数据的权限。
Spark配置
说明-
当版本选择为CDP7.x Hive3.1.3,且数据湖表格式选择Hudi时,支持Spark配置。
-
当版本选择为Aliyun EMR5.x Hive3.1.x,且数据湖表格式选择Iceberg或Paimon时,支持Spark配置。
参数
描述
Spark
可选择开启或关闭,默认为开启,开启后还需配置下方参数。
说明当数据湖表格式已选择Paimon时,不支持关闭Spark。
服务类型
可选择Kyuubi或Livy,默认为Kyuubi。
Spark JDBC URL
输入JDBC连接地址,格式为
jdbc:hive2://{host}:{port}/{database name}。认证方式
可选择无认证、LDAP或Kerberos。
用户名、密码
输入鉴权用户名和密码,为保证任务正常执行,请确保该用户拥有所需数据权限。
说明当认证方式选择为无认证时,需输入用户名;当认证方式选择为LDAP时,需输入用户名和密码。
Spark Keytab File
上传keytab认证文件,您可以在Spark Server上获取keytab文件。
说明当认证方式选择为Kerberos时,支持配置此项。
Spark Principal
填写Spark Keytab File文件对应的Principal名,例如
xxx/hadooppclient@xxx.xxx。说明当认证方式选择为Kerberos时,支持配置此项。
实时研发
说明仅CDH6.x Hive 2.1.1、CDP7.x Hive 3.1.3、亚信DP5.x Hive 3.1.0版本支持开启实时研发。开启模块中选择实时研发时,支持配置实时研发模块。
配置文件:上传hive-site.xml文件。Flink SQL任务将忽略集成中的认证信息,而使用Flink引擎的认证信息访问Hive数据源。
Amazon EMR
参数
描述
主节点公有DNS
通过公有DNS获取VPC私有DNS,Hive及 Spark均通过私有DNS连接,格式为
ec2-{public_ip}.{region}.compute.amazonaws.com。密钥文件(*pem)
访问主节点ec2的密钥对(新建EMR集群时所设定的密钥对)。
配置文件
可自行上传相关集群配置文件(core-site.xml、yarn-site.xml、hive-site.xml、hdfs-site.xml),或单击获取集群配置(需先填写主节点公有DNS并上传密钥文件),从主节点下载相关文件。
Database
填写Amazon EMR计算引擎的Database名称。
引擎类型
可选择Hive或Spark,默认选择Hive。选择Hive后,还需输入Hive JDBC URL;选择Spark还需输入 Spark JDBC URL。
-
Hive JDBC URL:输入Hive的JDBC连接地址,或自动获取连接地址(需先填写主节点公有DNS并上传密钥文件)。Hive JDBC URL格式为
jdbc:hive2//host1:port1,host2:post2/,无需填写Database name。 -
Spark JDBC URL:输入Spark的JDBC连接地址,格式为
jdbc:hive2//{host:port}/{database name}。
用户名
Hive或Spark的指定用户名,此用户名将设置为JDBC的
username。集群存储
可选择HDFS或S3。
选择S3后,还需配置以下参数:
-
Region:输入S3 Bucket所在的AWS地域,例如
us-east-1。 -
AccessKeyId、AccessKeySecret:输入S3的AccessKeyId和AccessKeySecret。
元数据获取方式
Amazon Glue:选择Amazon Glue后,还需配置Glue Region Code、Glue AccessKey ID、Glue AccessKey Secret。
-
Glue Region Code:输入Amazon Glue的Region Code,例如ap-northeast-3,us-east-1,us-west-1。
-
Glue AccessKey ID、Glue AccessKey Secret:输入Amazon Glue的访问AccessKey ID和AccessKey Secret。
-
-
-
选择默认资源组,该资源组用于运行与当前数据源相关任务,包括数据库SQL、离线整库迁移、数据预览等。
-
进行测试连接或直接单击确定进行保存,完成Hive数据源的创建。
单击测试连接,系统将测试数据源是否可以和Dataphin进行正常的连通。若直接单击确定,系统将自动对所有已选中的集群进行测试连接,但即使所选中的集群均连接失败,数据源依然可以正常创建。
测试连接针对公共调度集群或已经在Dataphin注册且正常使用的注册调度集群进行连接测试。公共调度集群为系统默认选中,不支持取消选中。注册调度集群下不存在资源组时,不支持进行连接测试,需先创建资源组后再进行测试连接。
所选集群只用于测试与当前数据源的网络连通,不用于后续相关任务的运行。
测试连接时长通常在2分钟内,若超时,您可以单击
 图标查看具体原因并重试。
无论测试结果为连接失败、连接成功或成功有风险,系统都将为您记录最终结果的生成时间。
说明仅公共调度集群的测试结果包含成功有风险、连接成功、连接失败三种连接状态;在Dataphin注册的注册调度集群的测试结果仅包含连接成功、连接失败两种连接状态。
测试结果为连接失败时,您可以单击
 图标查看具体失败原因。
测试结果为成功有风险时,代表应用集群连接成功、调度集群连接失败。您可以单击
图标查看日志信息。
若Hive元数据库地址为公网地址,则此处请选择公共调度集群的资源组作为默认资源组,在配置集成任务时将任务运行在注册调度集群中。若Hive元数据库地址为内网地址,此处请选择注册地调度集群的资源组作为默认资源组,并前往元数据中配置采集任务,在配置集成任务时将任务运行在注册调度集群中。
重要如果连接测试失败,您可以根据网络连通常见问题进行排查。详细内容,请参见网络连通解决方案。