
通过部署获得独立的、资源专享的推理服务,以满足高并发、低延迟等性能需求;本文介绍各计费方式选型、部署方法与通用运维。
计费方式
部署前可以在专属部署控制台查看不同模型的预估每小时费用。
说明计费方式在服务创建后无法更改。如需切换,必须下线已经部署的模型后再重新部署。
预置吞吐(PTU,Provisioned Throughput Unit) (高吞吐;高性能) | 模型单元 (自定义性能指标;资源隔离) | Token 用量 (调优后按量计费/效果验证) | |||
|---|---|---|---|---|---|
定义 | 通过平台预留资源,保障特定TPM 吞吐能力的模型部署方式;在保障额度内不限速。 | 按使用时长与模型单元数量配置算力,资源独占的模型部署方式。 | 以每次调用产生的输入 Token 与输出 Token 作为用量计量依据的模型部署方式。 | ||
优势 |
|
| 不使用不计费。 | ||
支持模型 | 部分预置模型 | 部分预置模型与所有调优后模型 | 部分经过 LoRA 调优后的模型 | ||
使用场景 |
|
| 调优后模型效果验证 | ||
计费图示 |
|
|
| ||
计费方式 | 按使用时长和预置吞吐 随用随付、包天 | 按使用时长和模型单元数量 随用随付、包月 | 按模型 Token 使用量 随用随付 | ||
扩缩容方式 | 自助增减吞吐量 | 自助增减模型单元数量 | 在控制台提交申请,等待人工审核。 | ||
产品约束 |
| 预付费购买后,若在首月内提前退订,日单价(≈ 月单价 / 30)将按 1.2 倍计费 |
| ||
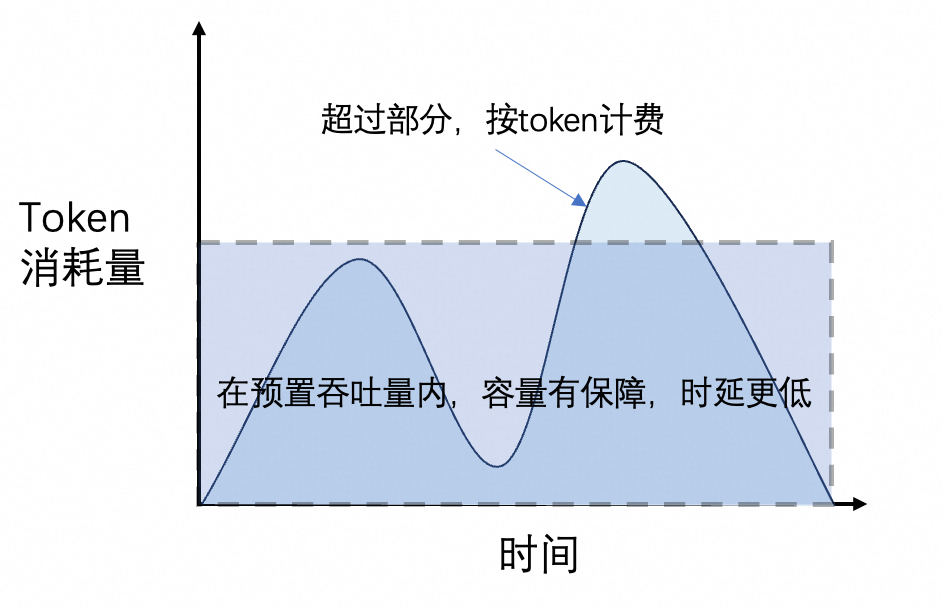
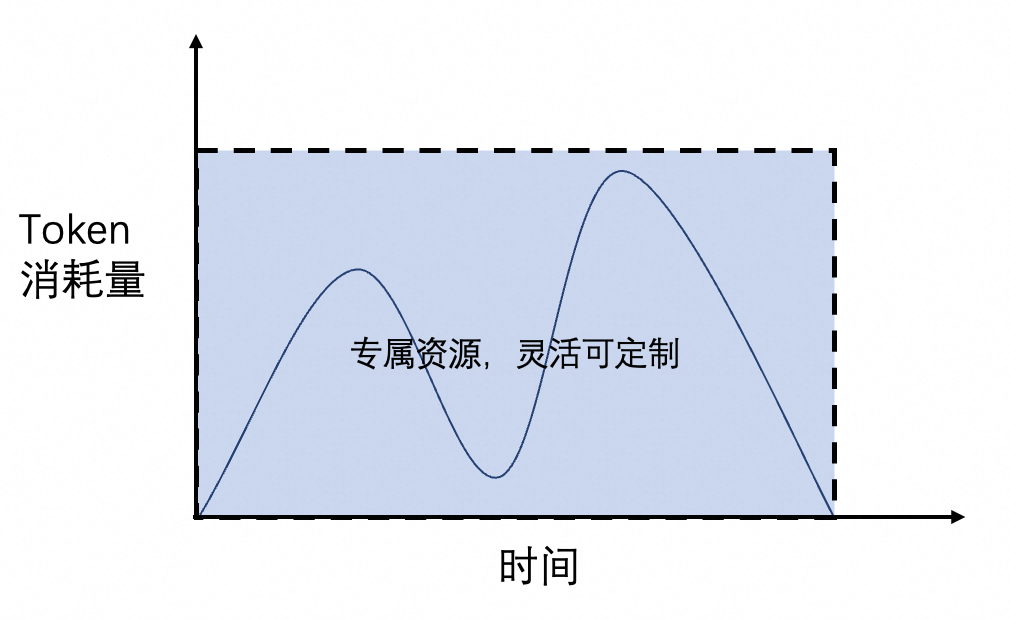
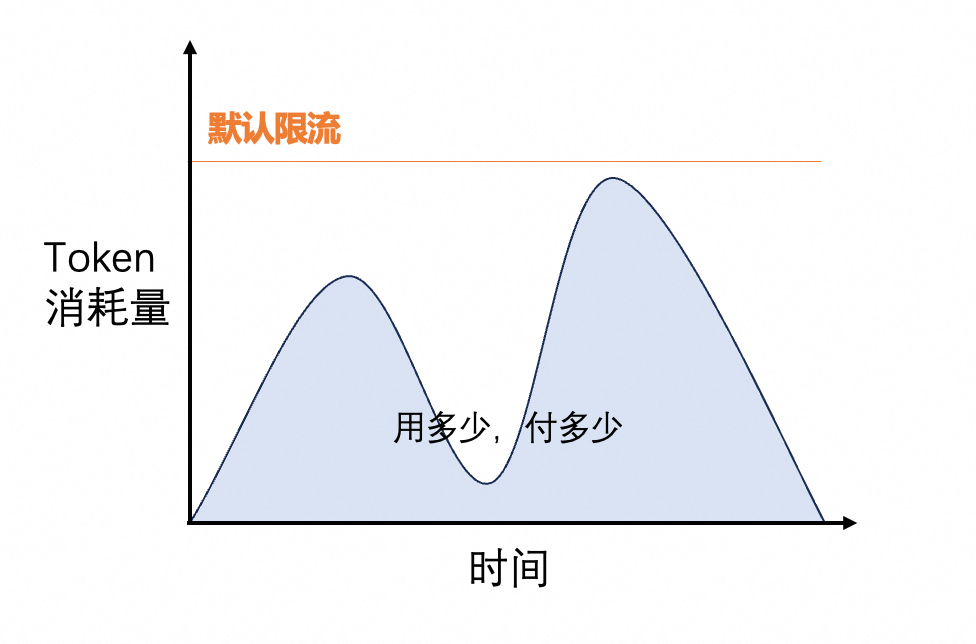
如需查看单次调用的 Token 使用量及调用次数历史统计,请前往:模型监控。
DTU 是模型单元(MU)的继任方案(计量粒度由单元数改为输入/输出TPM),新购独占部署优先选 DTU,详见独占算力部署。
部署模式
各部署模式支持的模型与价格详见对应模式页:
说明预置吞吐单元(PTU)的创建与管理现已支持在「吞吐预留」页面进行,支持叠加容量包等更完整的容量管理功能。详见吞吐预留。
部署方法
您可以在控制台上部署模型,请参考以下操作步骤:
如果提示权限不足,请参考API 部署指南中的权限排查部分。
-
登录百炼控制台,在左侧导航栏选择模型推理 > 专属部署。
-
单击部署新模型。
-
填写服务名称,完成选择模型与计费方式,其他配置保持默认,单击确认。
需先完成模型调优,方可部署大部分模型。
-
返回部署列表,部署状态变为运行中时,代表该模型已部署成功。
重要模型部署成功后将产生费用。
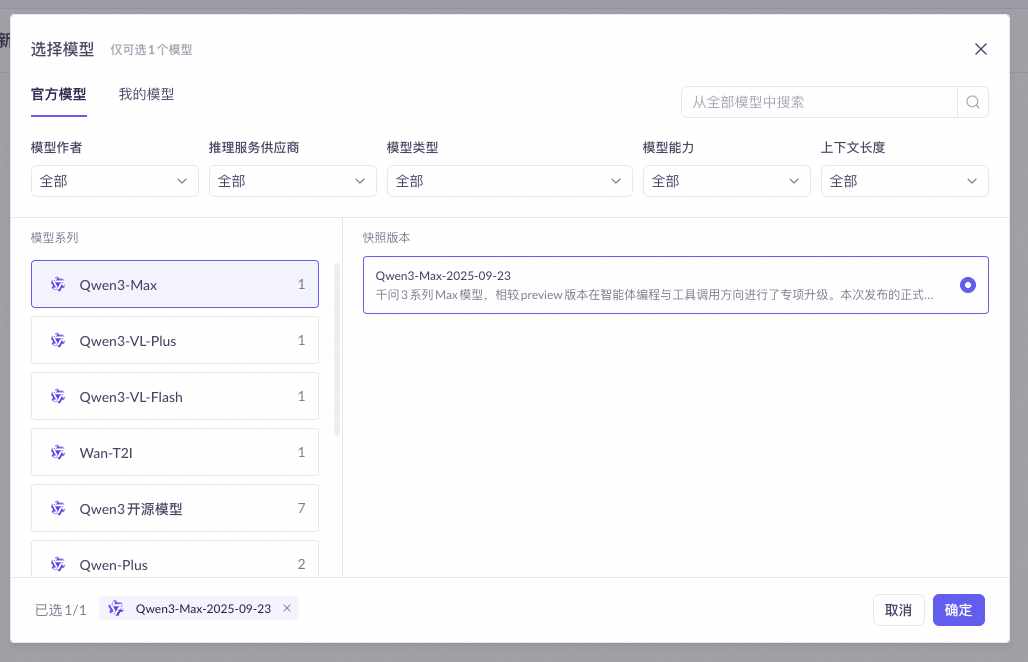
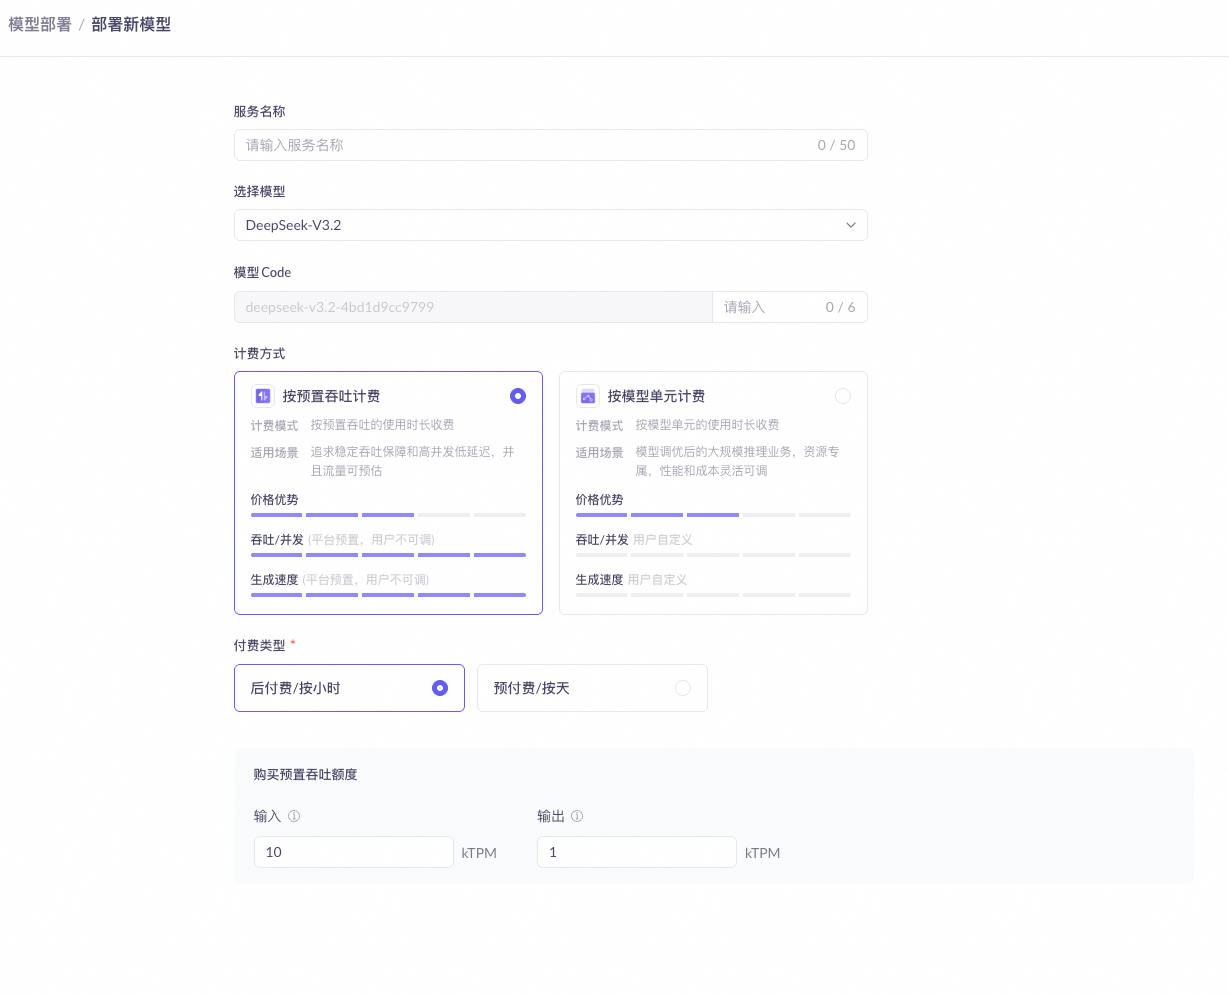
部署服务的详细配置参数(服务名称、模型、模型单元类型、副本数、推理模式、最长上下文、限流等)详见独占算力部署与API 部署指南。
部署列表页
部署成功后,您可以在部署列表页查看和管理所有部署服务。列表页包含以下信息:
- 服务名称:部署服务的名称,单击可查看部署详情。
- 模型名称:部署使用的模型。
- 模型Code:模型部署成功后生成的唯一标识,用于 API 调用时指定模型。
- 部署状态/事件状态:包括待部署、部署中、运行中、部署失败、下线中、服务暂停、已停止、删除中、退订停服/欠费停服、停服恢复中、运行中(变配中)、运行中(变配失败)等状态。
- 计费方式:当前部署服务的计费方式。
- 部署详情:模型单元类型、副本数等配置信息。
- 限流详情:展示当前部署服务的 RPM(每分钟请求数)、TPM(每分钟 Token 数)等限流配置。
- 服务时间:展示部署服务的创建时间与到期时间。
- 操作:根据部署状态和计费方式,可执行更新、监控、扩缩容、续费、下线、删除、体验等操作;预置吞吐单元(PTU)实例还支持在吞吐预留页叠加容量包。
部署成功后的 API 调用方式(DashScope / OpenAI 兼容接口 / Assistant SDK)详见API 部署指南。
各计费方式的扩缩容操作(手动增减吞吐量/模型单元、Token 扩容申请、自动伸缩策略)详见对应模式页:PTU预置吞吐部署、独占算力部署、Token按量部署。
部署服务下线
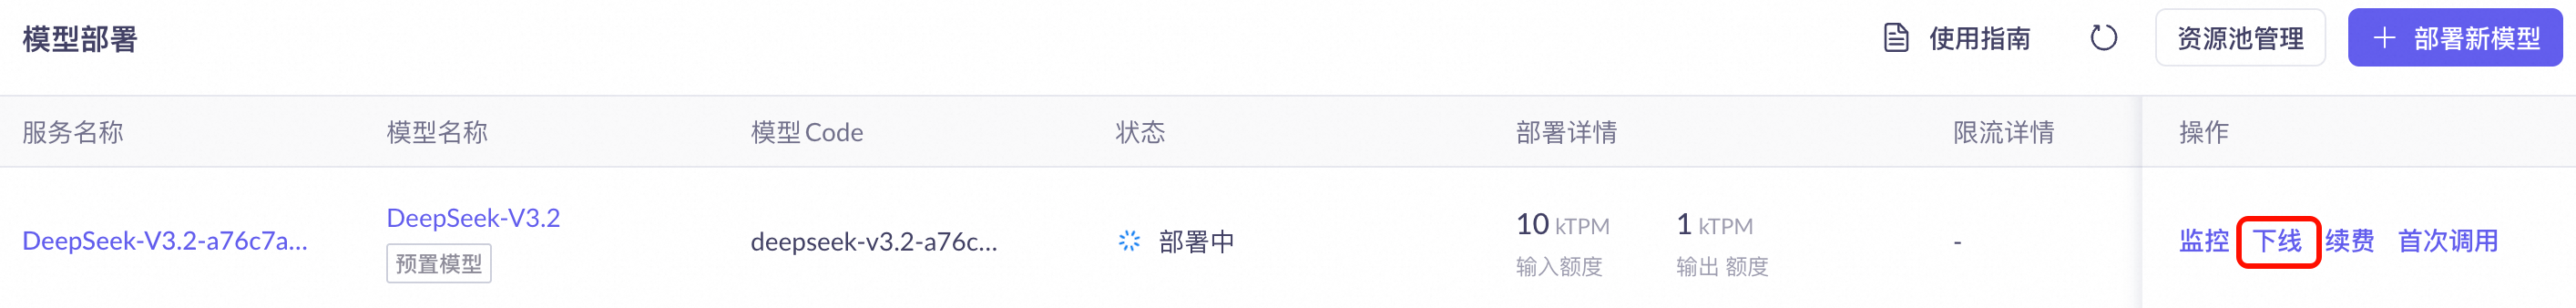
前往专属部署控制台,找到要停止的部署服务,根据计费类型点击对应操作:
- 模型单元预付费:点击下线并确认。
- 后付费:点击删除并确认。
操作完成后将不再产生计费。
常见问题
可以上传和部署自己的模型吗?
支持在我的模型控制台(北京)导入部分开源模型,详细支持列表请参考:模型导入。
此外,阿里云人工智能平台 PAI 提供了部署自有模型的功能,您可以参考PAI-LLM大语言模型部署了解部署方法。
该如何切换到其他的计费方式?
只能释放原有资源,再通过需要的计费方式创建新资源。
建议按照以下步骤进行切换:
- 使用需要的计费方式部署新的资源。
- 切换 API 并测试服务可用性。
- 下线释放原有资源。